


在 2026 年的 CES 大會上,Nvidia 已正式發表了全新 Vera Rubin 平台的所有細節。面對 AMD MI450X Helios 與 Google TPU 在機架級別的競爭,Nvidia 提出了「極端協同設計」(Extreme Co-Design)理念,整個機架被視為一個單一的叢集加速器,Nvidia 透過全面掌握 CPU、GPU、網卡與交換機等頂尖矽晶片產品,打造出競爭對手難以複製的完整生態系。趁在3月16日GTC 前,本文章上半部先帶讀者回顧Vera Robin 架構,下半部份將分析傳聞中的全新Groq LPU 架構6大版本。
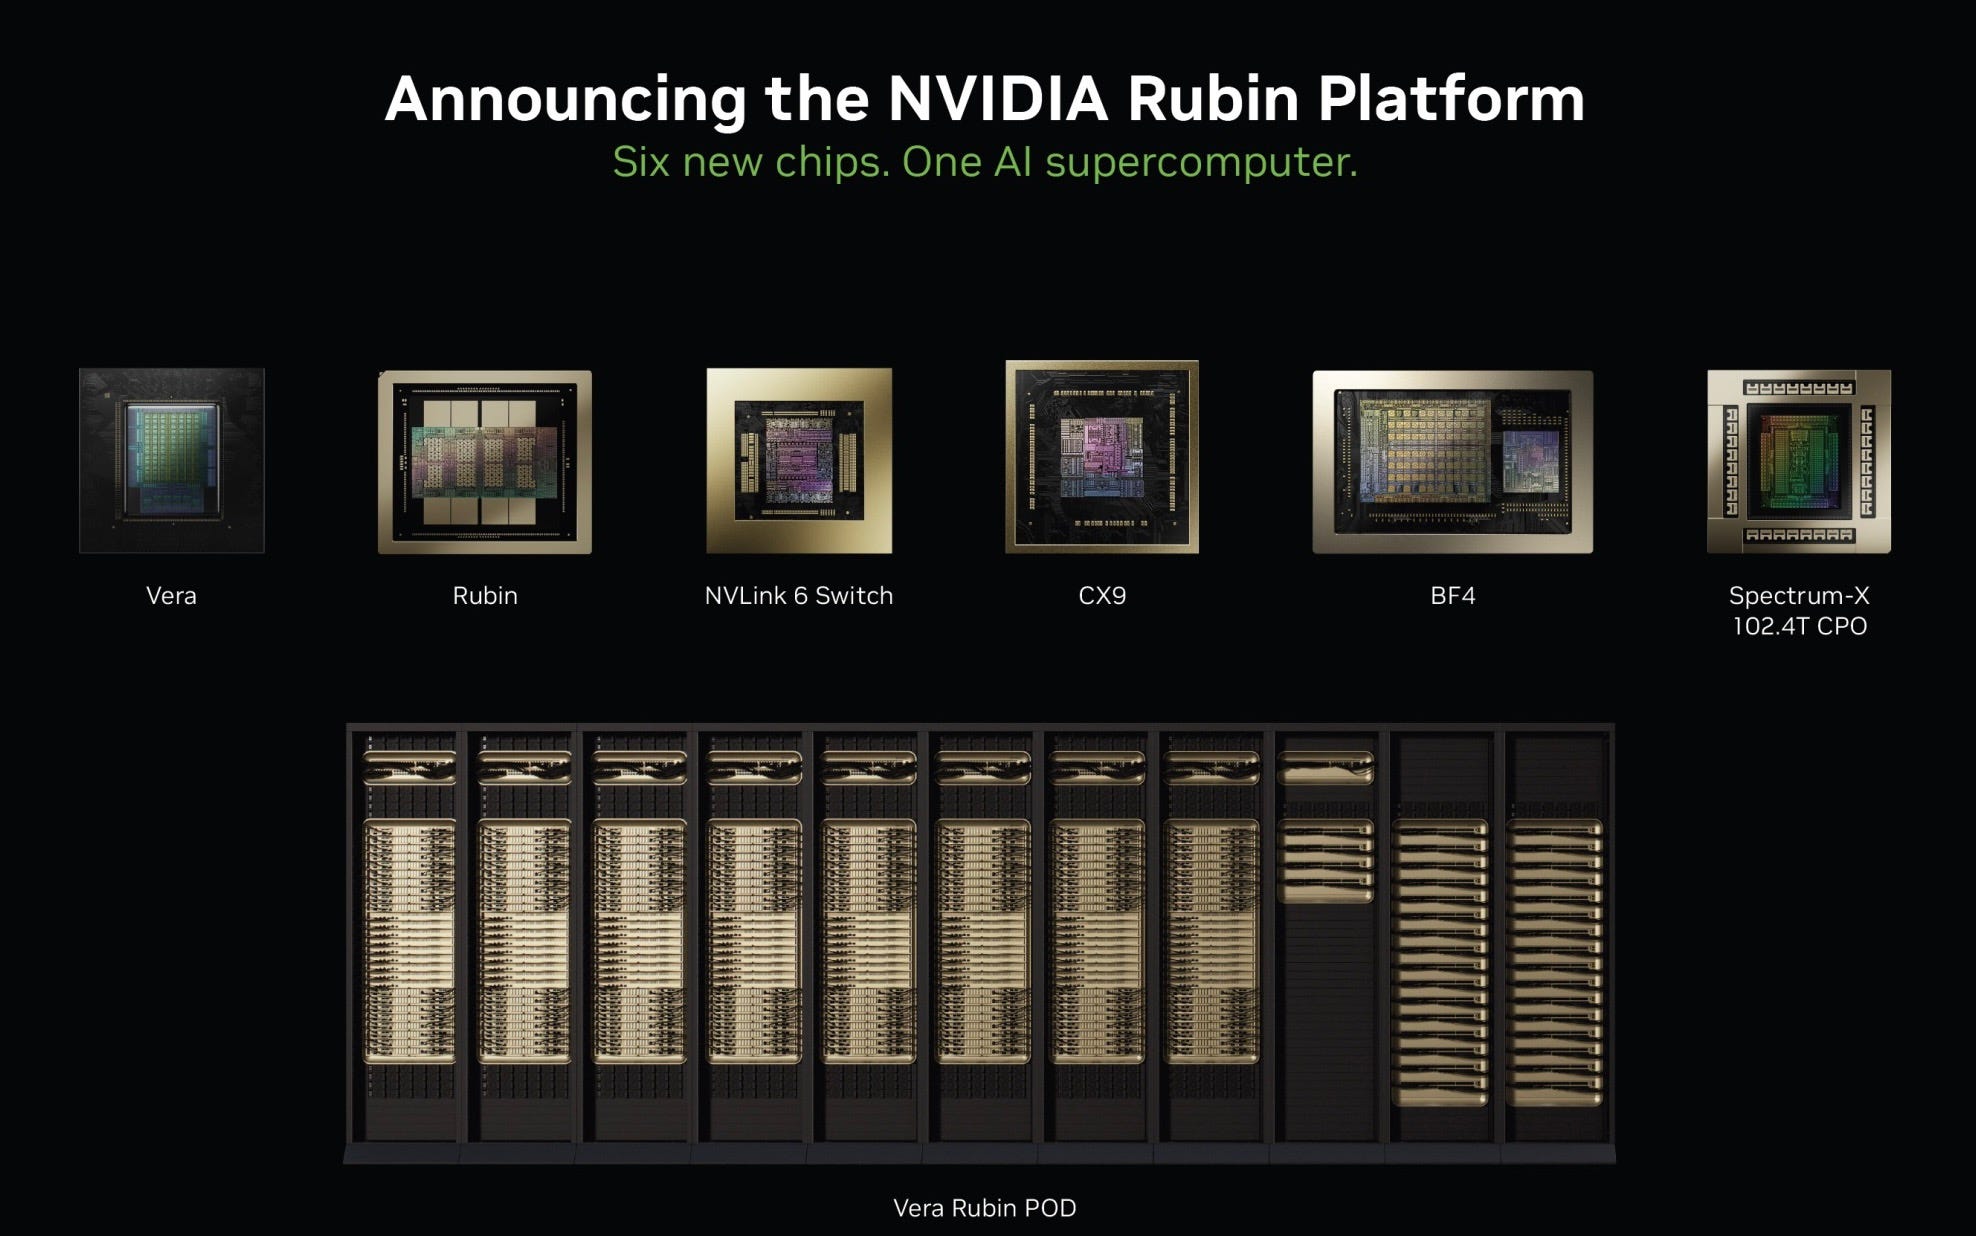
一、 六大核心晶片產品升級
Vera Rubin 平台由六款深度整合的晶片產品構成,架構上特別強調頻寬與低精度運算的升級:
Rubin GPU:
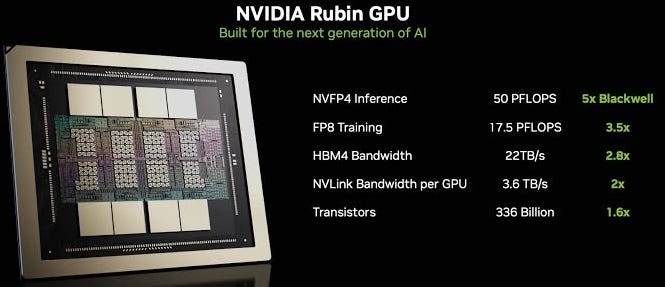
採用 3 奈米製程,架構為 Blackwell 的邏輯演進。時脈提升至 2.38GHz,SM串流處理器數量增加至 224 個,Tensor Core 寬度加倍,在FP4 精度下效能提昇為 GB200 的 3.5 倍。
第三代 Transformer 引擎與自適應壓縮(Adaptive Compression Engine):Rubin 採用動態(in-flight)運算。它能自動消除資料流中的零值,保持模型準確度的同時把推論效推升。
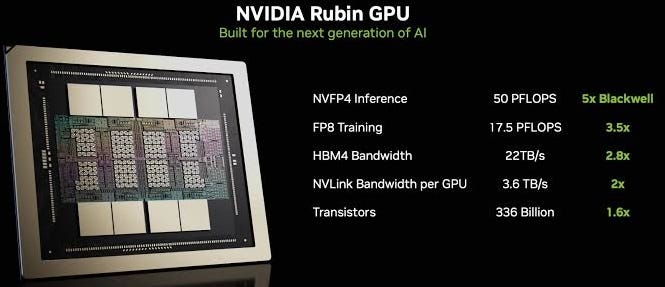
記憶體方面升級至 HBM4,提供 22TB/s 的總頻寬(容量維持在 288GB)。
功耗方面分為兩個版本:效能極致的 Max-P(高達 2300W)與注重能效的 Max-Q(1800W)。
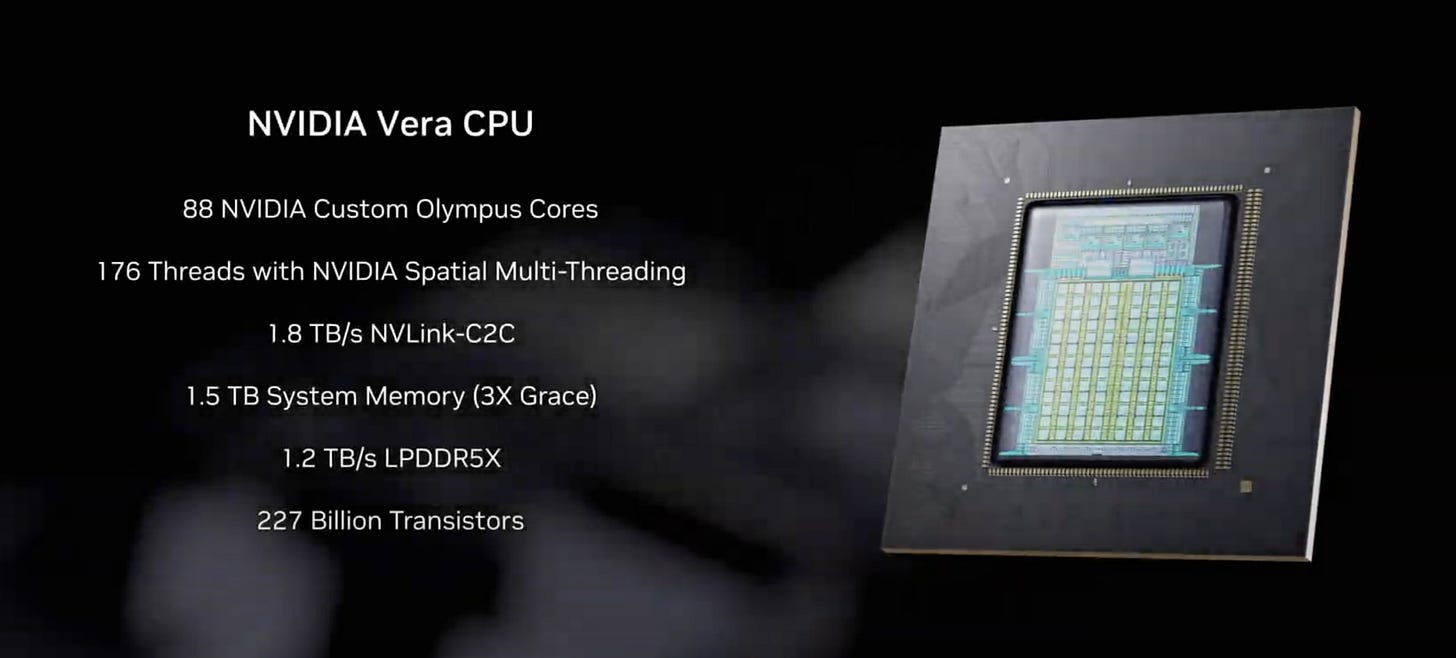
Vera CPU:
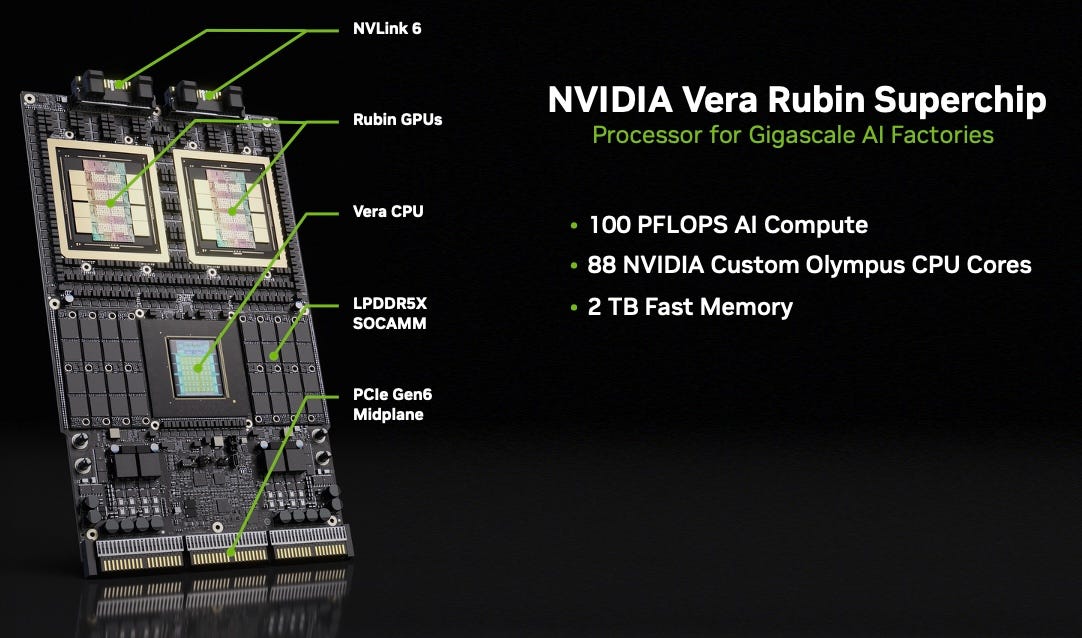
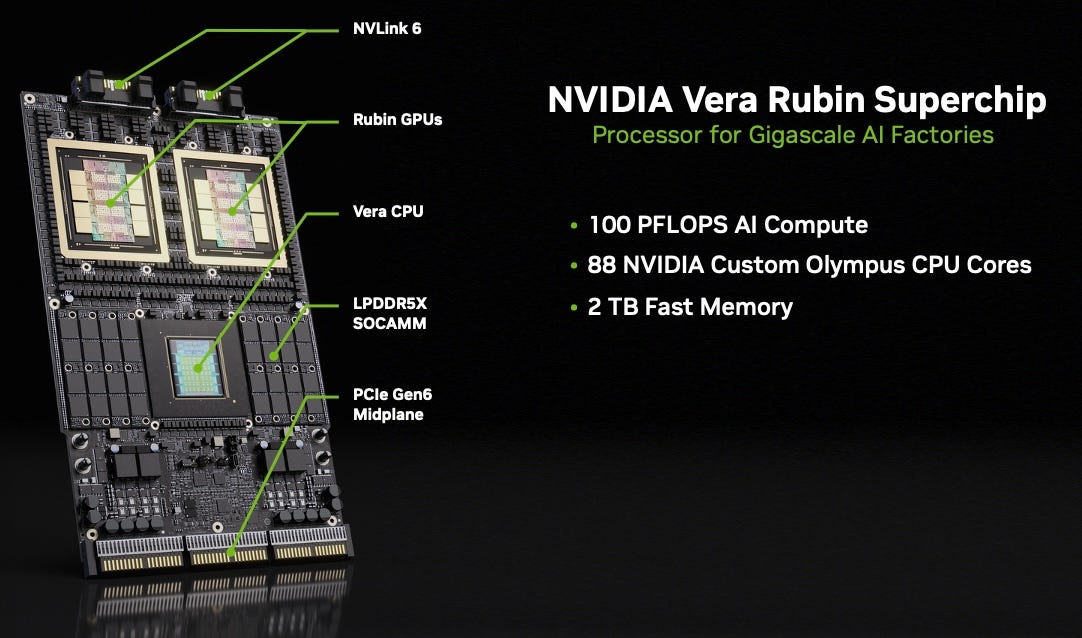
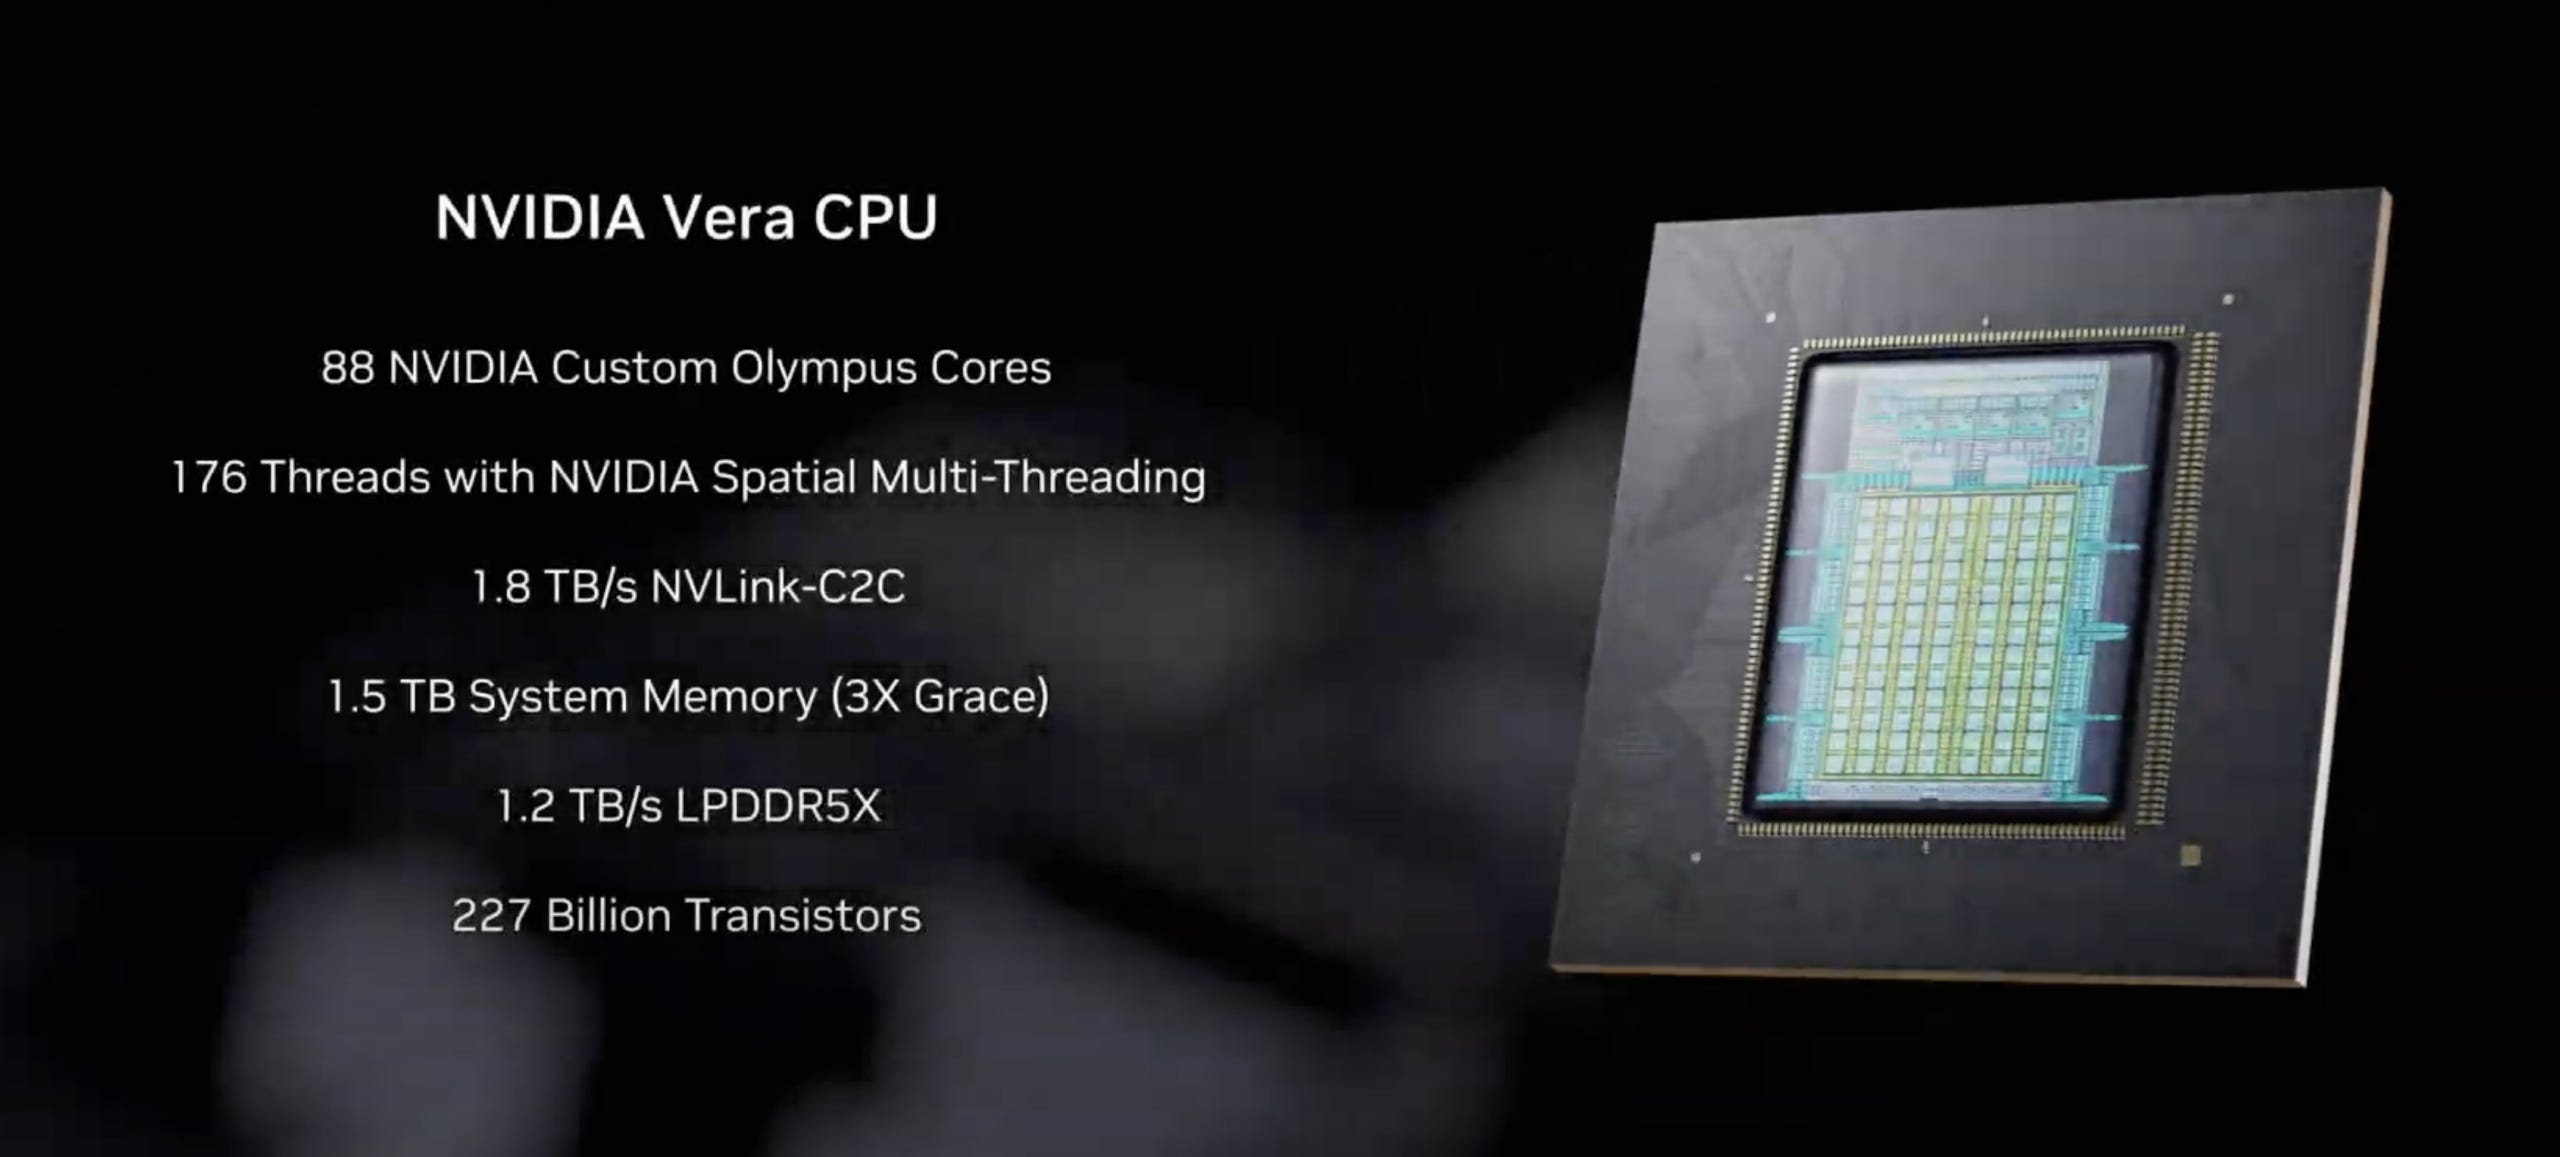
Nvidia 回歸客製化 ARM CPU 設計(代號 Olympus),擁有 88 個核心與高達 162MB 的 L3 快取。(Meta 已預訂)
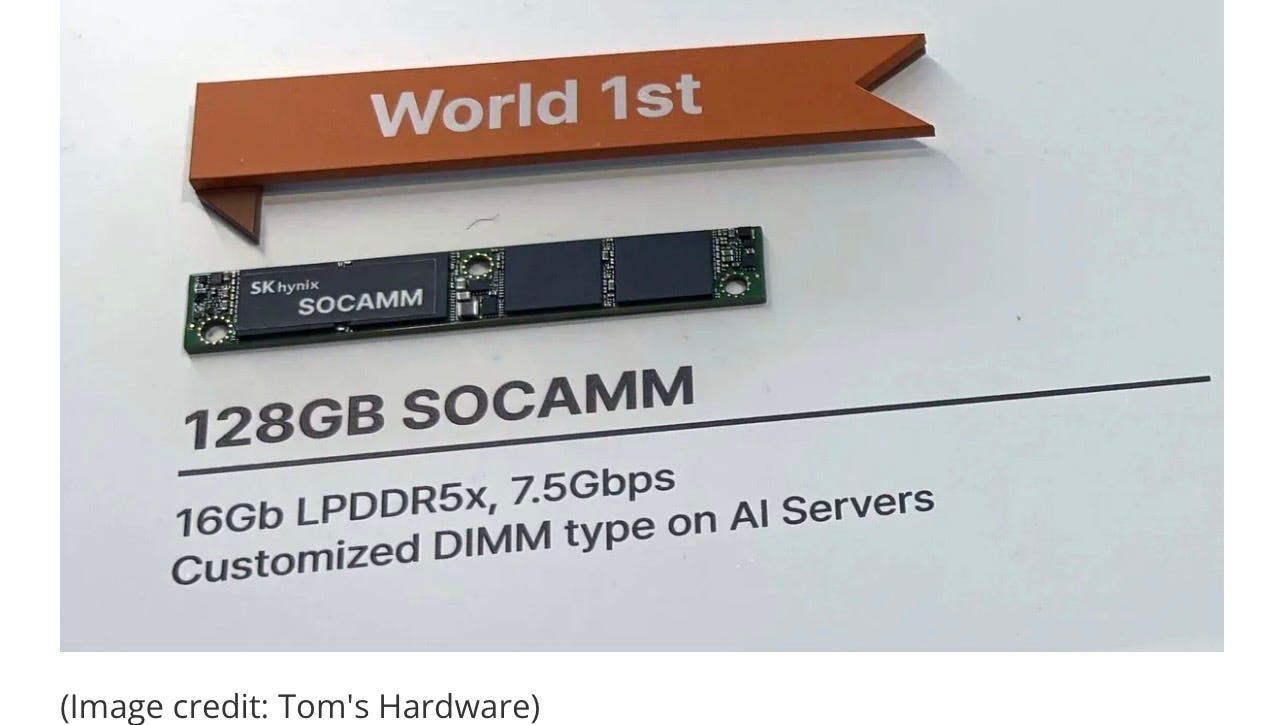
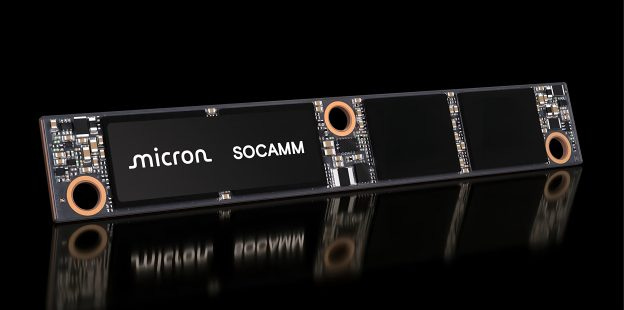
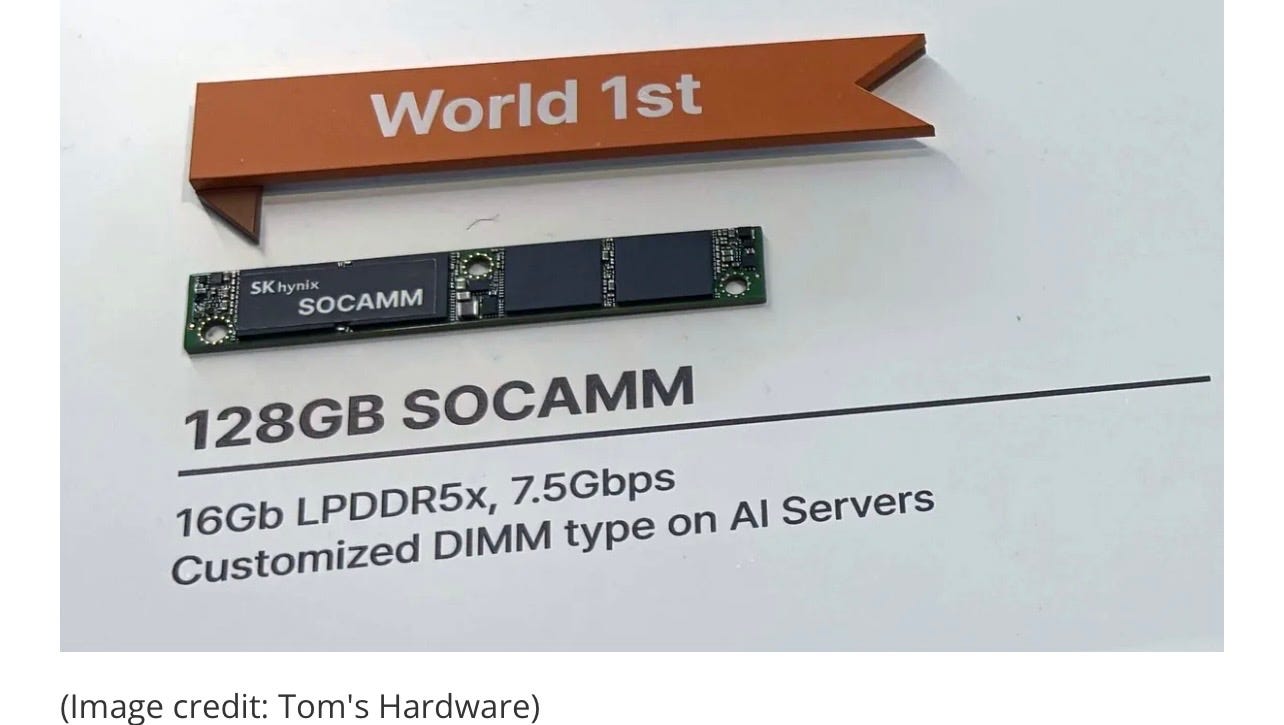
採用分離式的 SOCAMM 記憶體模組,支援高達 1.5TB 的 LPDDR5X,速度達 9600MT/s。透過加倍的 NVLink-C2C 介面,與 Rubin 的連接頻寬高達 1.8TB/s。
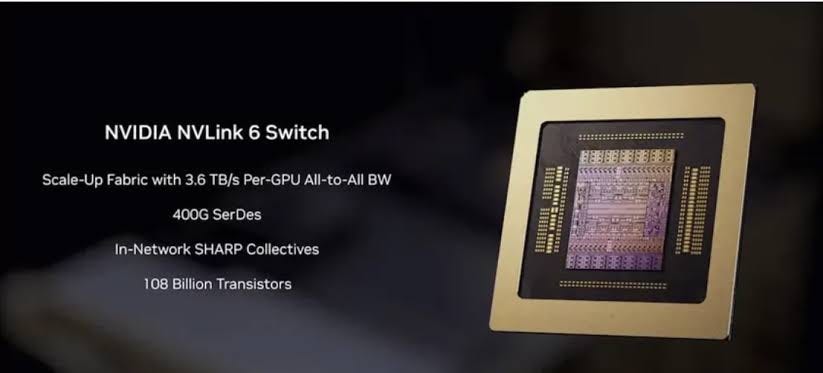
NVLink 6 交換晶片:
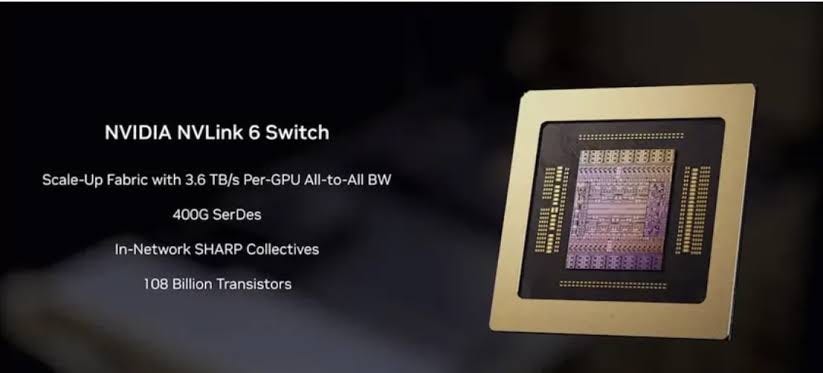
保持與前代相同的 28.8T 總頻寬,但連接埠數量減半,透過採用 400G 雙向 SerDes 技術,讓單一晶片架構更精簡。
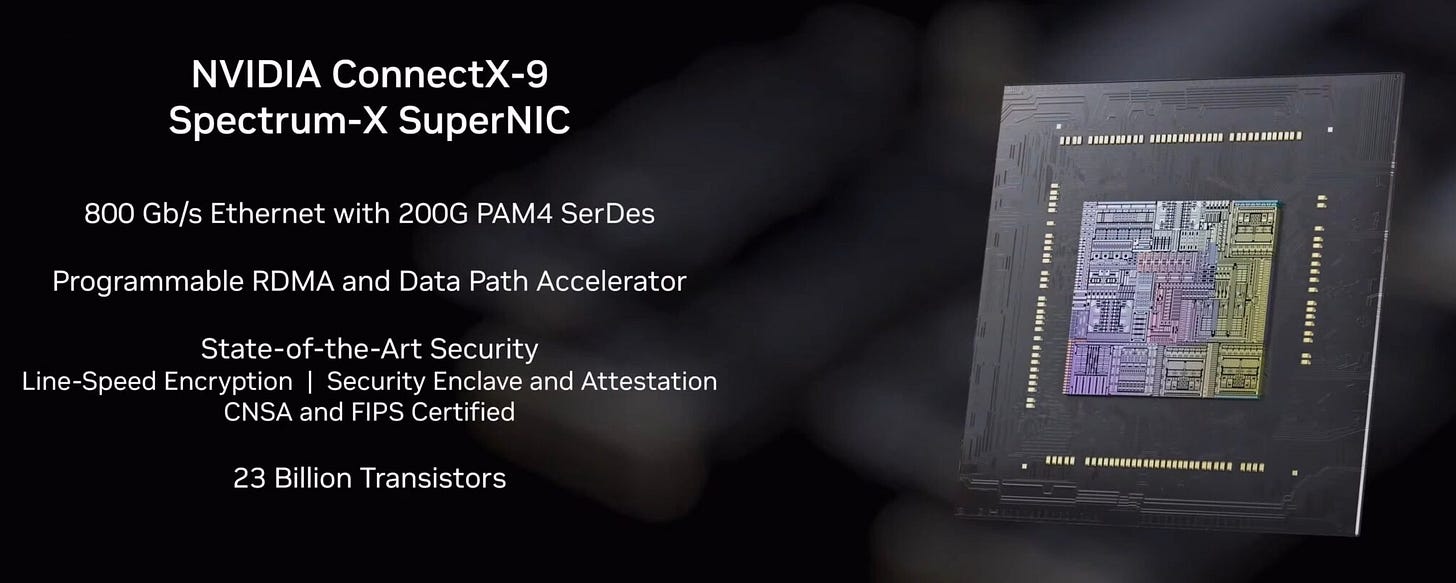
ConnectX-9 (CX-9) 網卡:
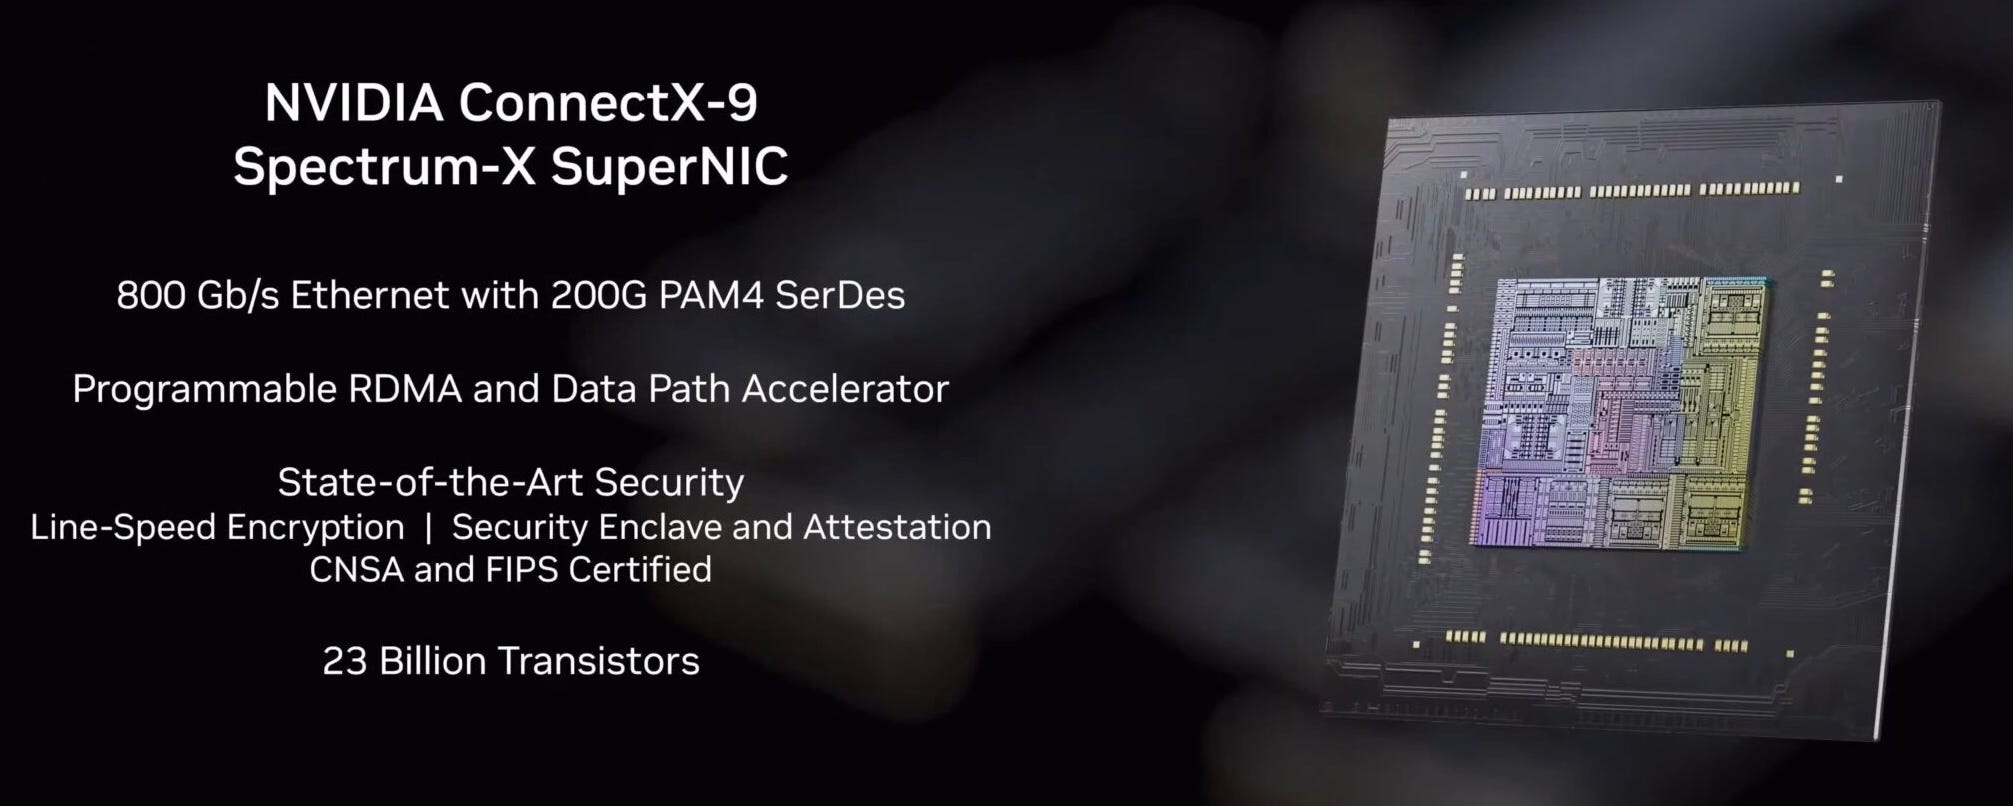
提供 800G 網路頻寬,支援 PCIe Gen 6,並透過 4x200G PAM4 SerDes 支援 800G 乙太網路。每顆 GPU 的網卡配置數量翻倍,以達到 1.6T 的頻寬。
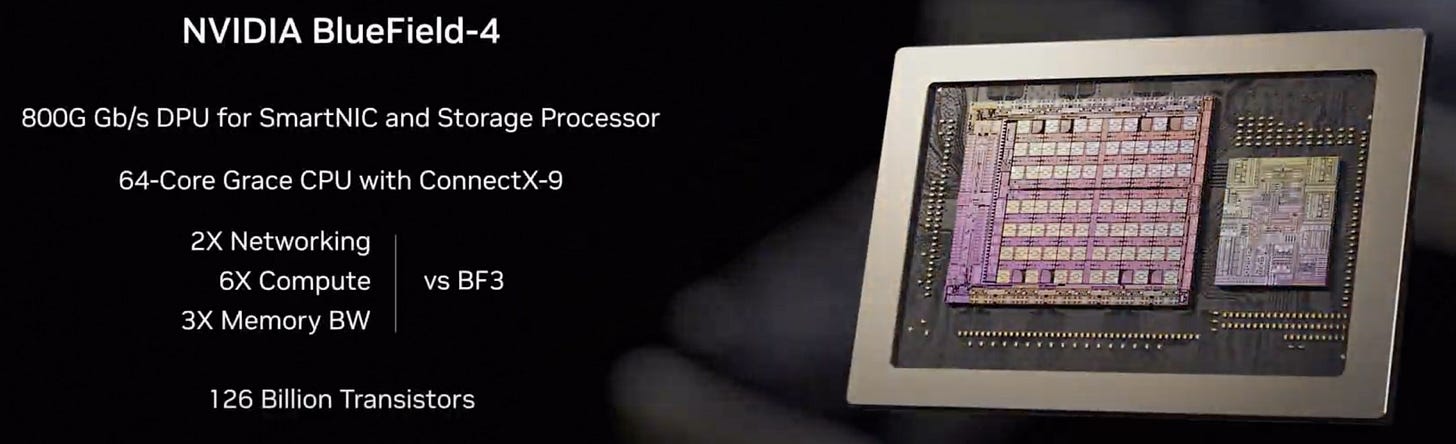
BlueField-4 (BF-4) DPU:
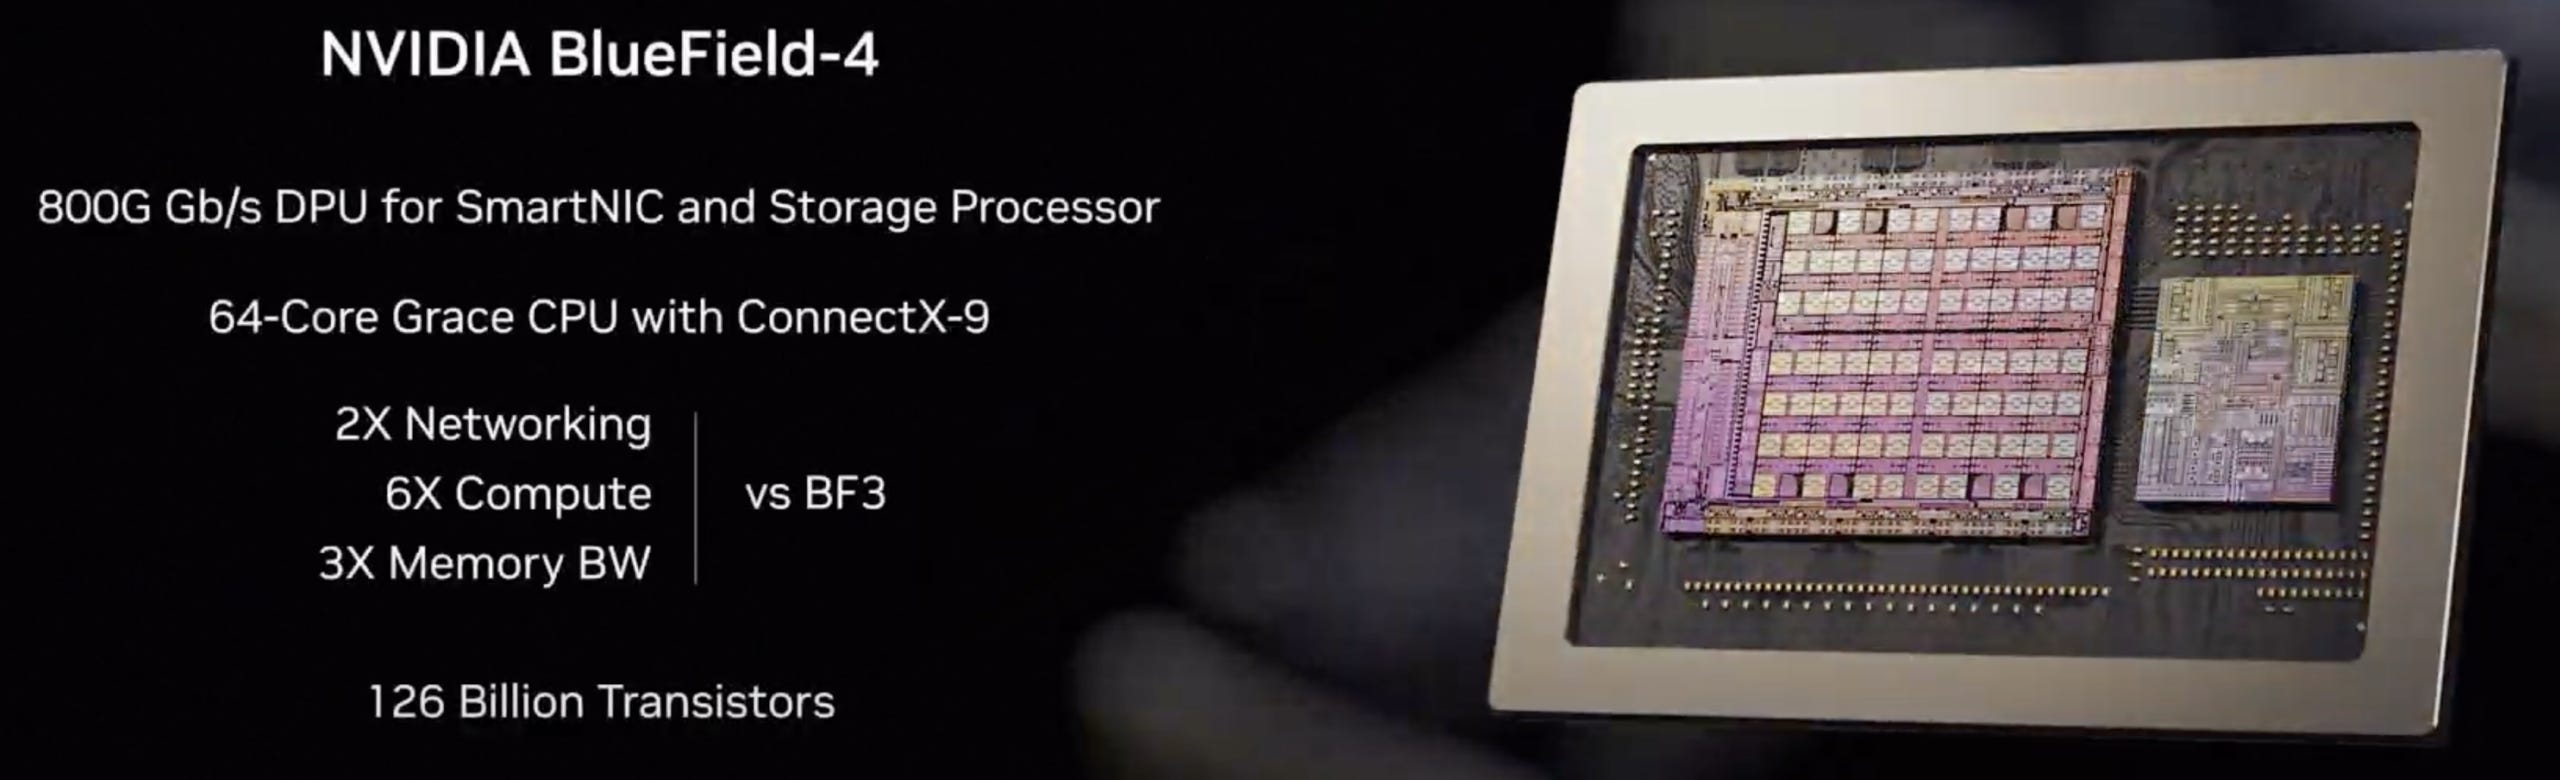
直接將 Grace CPU 晶片與 CX-9 晶片封裝在一起,並配備 128GB 的 LPDDR5 記憶體。它能作為儲存控制器,同時管理前後端網路,減輕 CPU 的負載。早前有介紹此晶片的主要供應商之一就是慧榮科技 Silicon Motion Technology Corp. 行內簡稱SMI,Nasdaq 股票代号SIMO。
Spectrum-6 交換機:
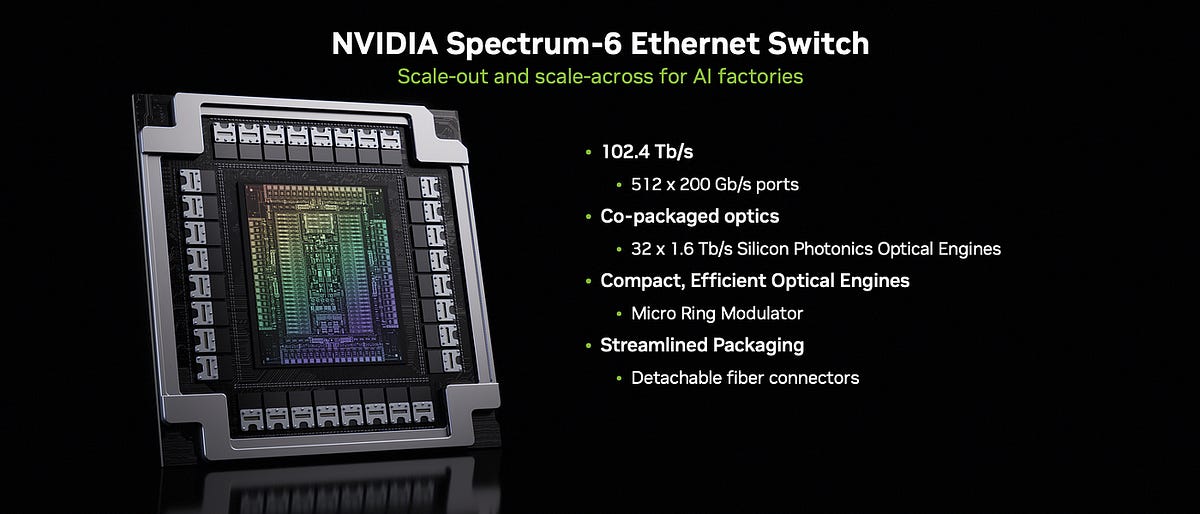
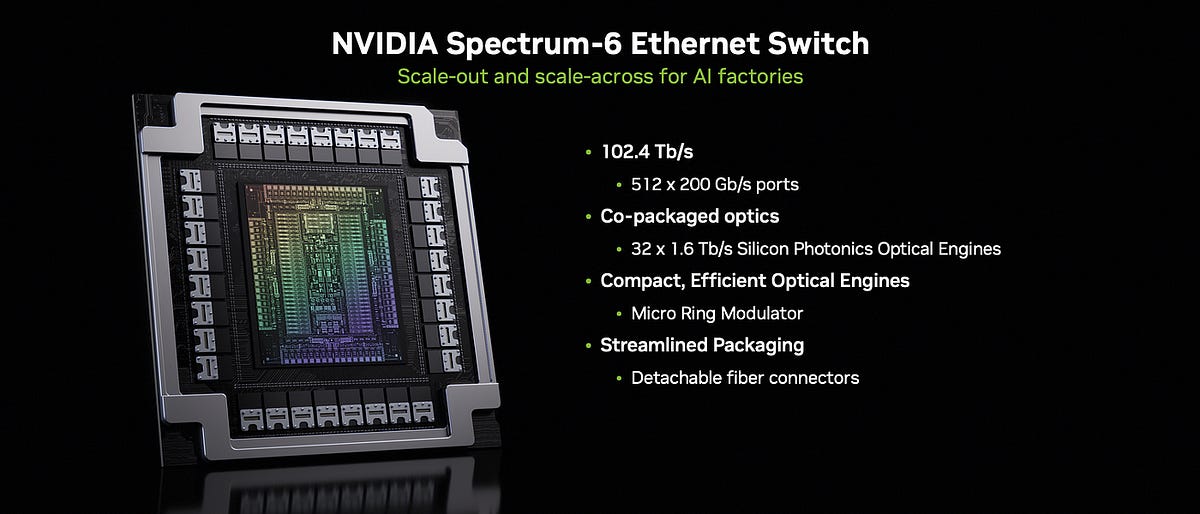
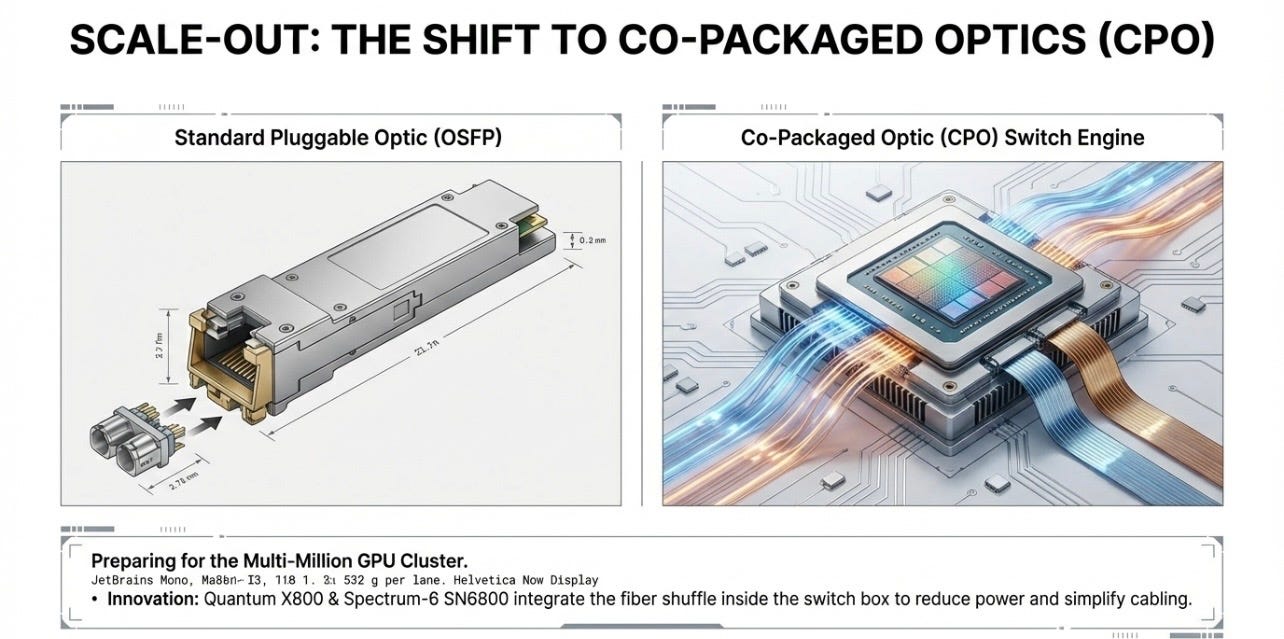
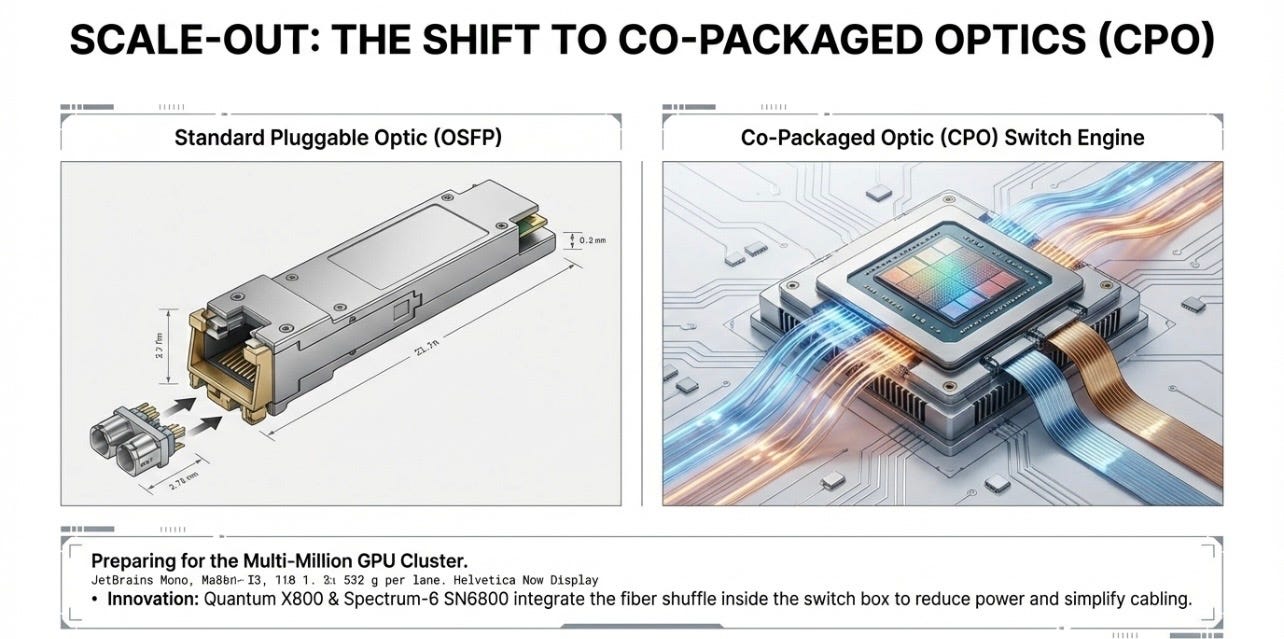
針對乙太網路叢集,推出具備共封裝光學(CPO)技術的 SN6800 交換機。透過直接在封裝上整合光學引擎,可提供高達 409.6T 的交換能力。
二、 運算托盤的「無纜化」(Cableless Design)革命與 PCB 材料大升級
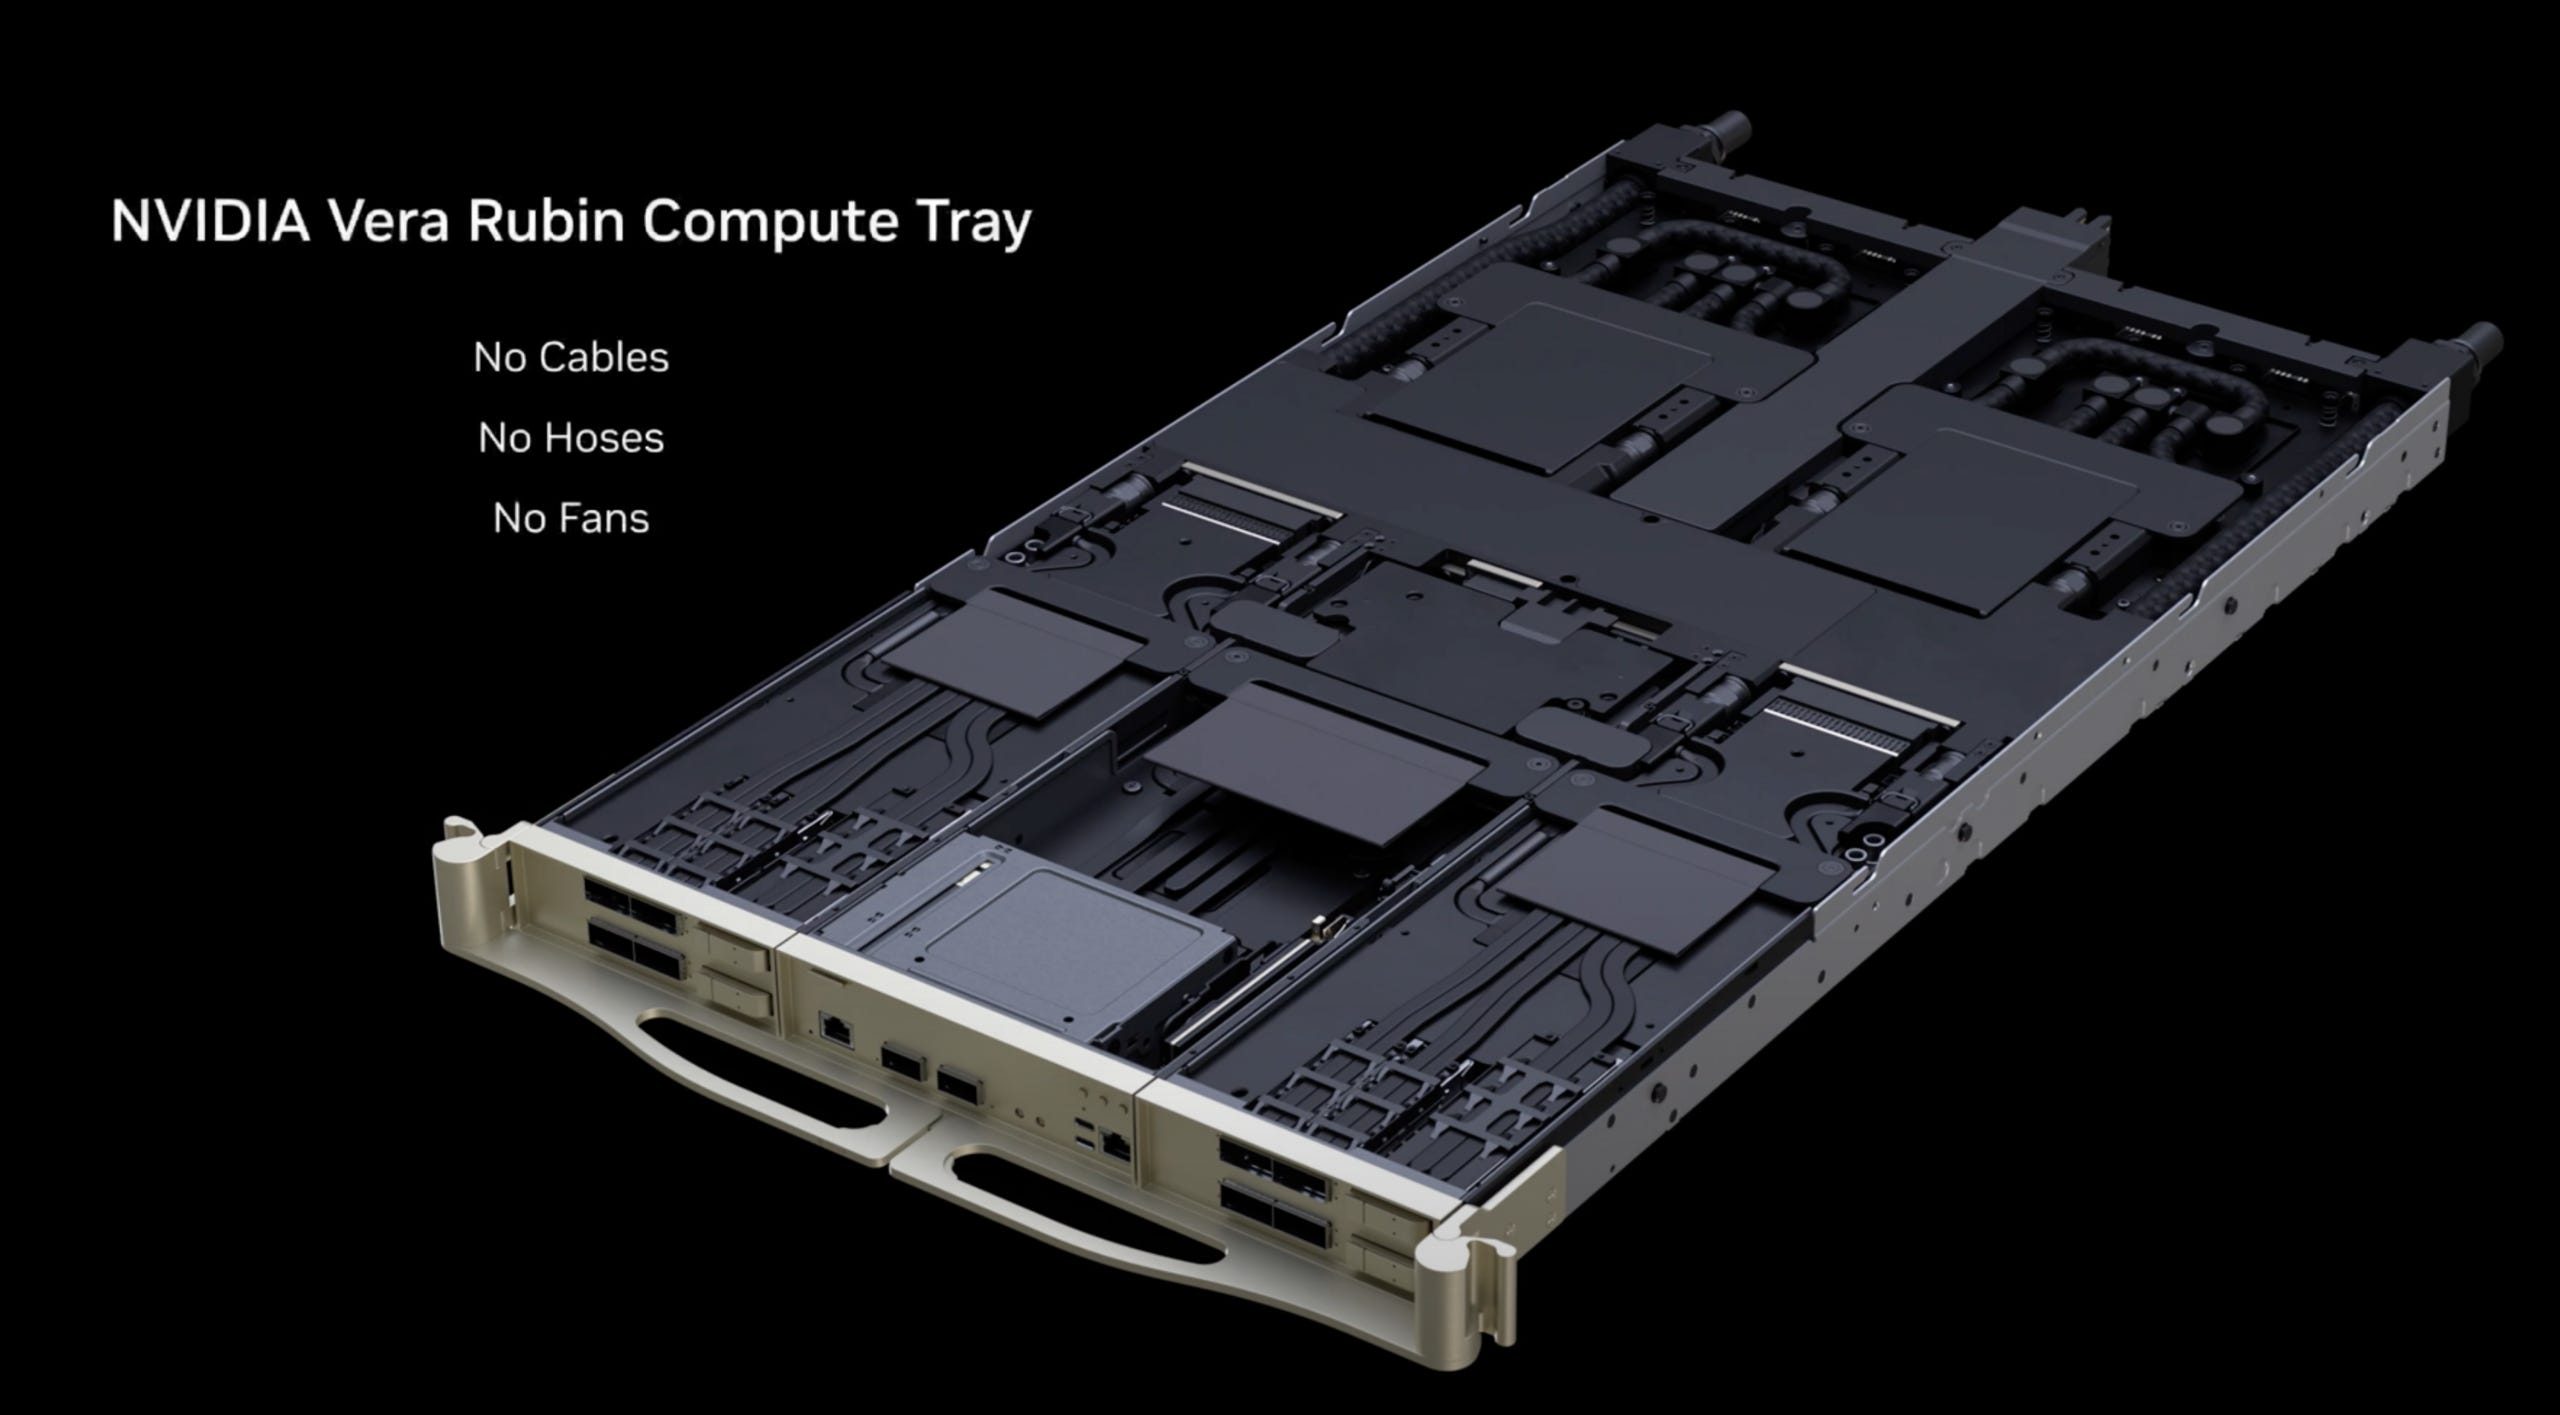
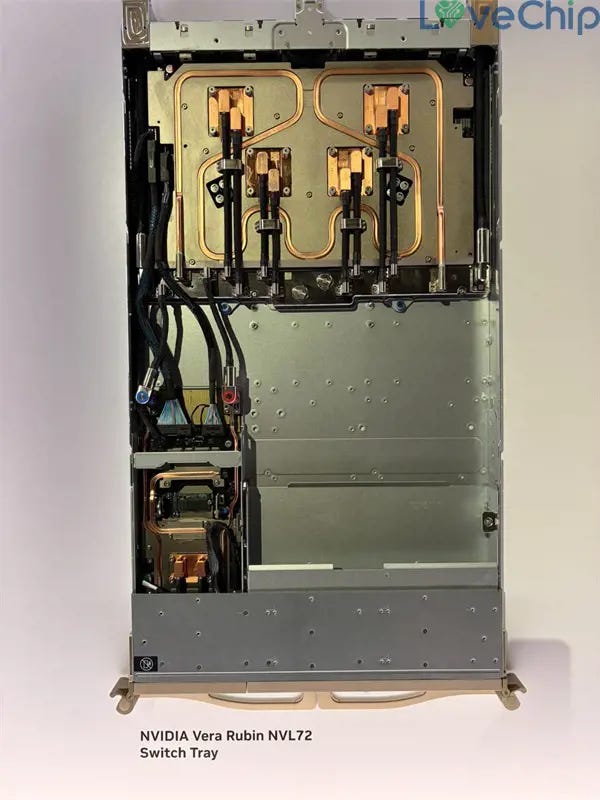
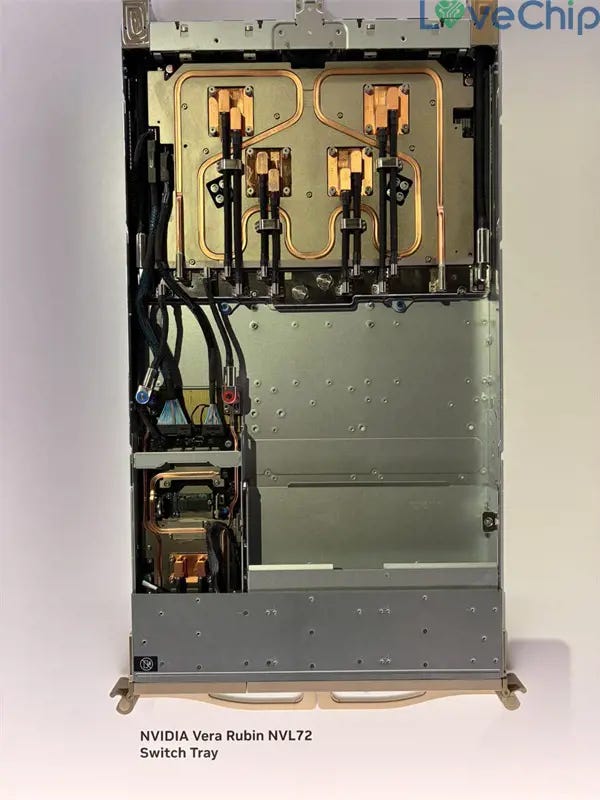
Vera Rubin 僅提供高密度的 VR NVL72 機架配置(72 顆 GPU、36 顆 CPU、36 顆 NVLink 交換晶片)。為了降低製造與組裝難度,Nvidia 對運算托盤進行了顛覆性的重新設計:
無纜化設計(Cableless Design):
過去 GB200 內部的飛線(Flyover cables)是故障的高發點。VR NVL72 採用模組化盲插設計,透過 Amphenol ($APH) 的 Paladin HD2 板對板連接器與中央 PCB 中介板(Midplane)連接,將托盤的組裝時間從 2 小時大幅縮短至 5 分鐘。
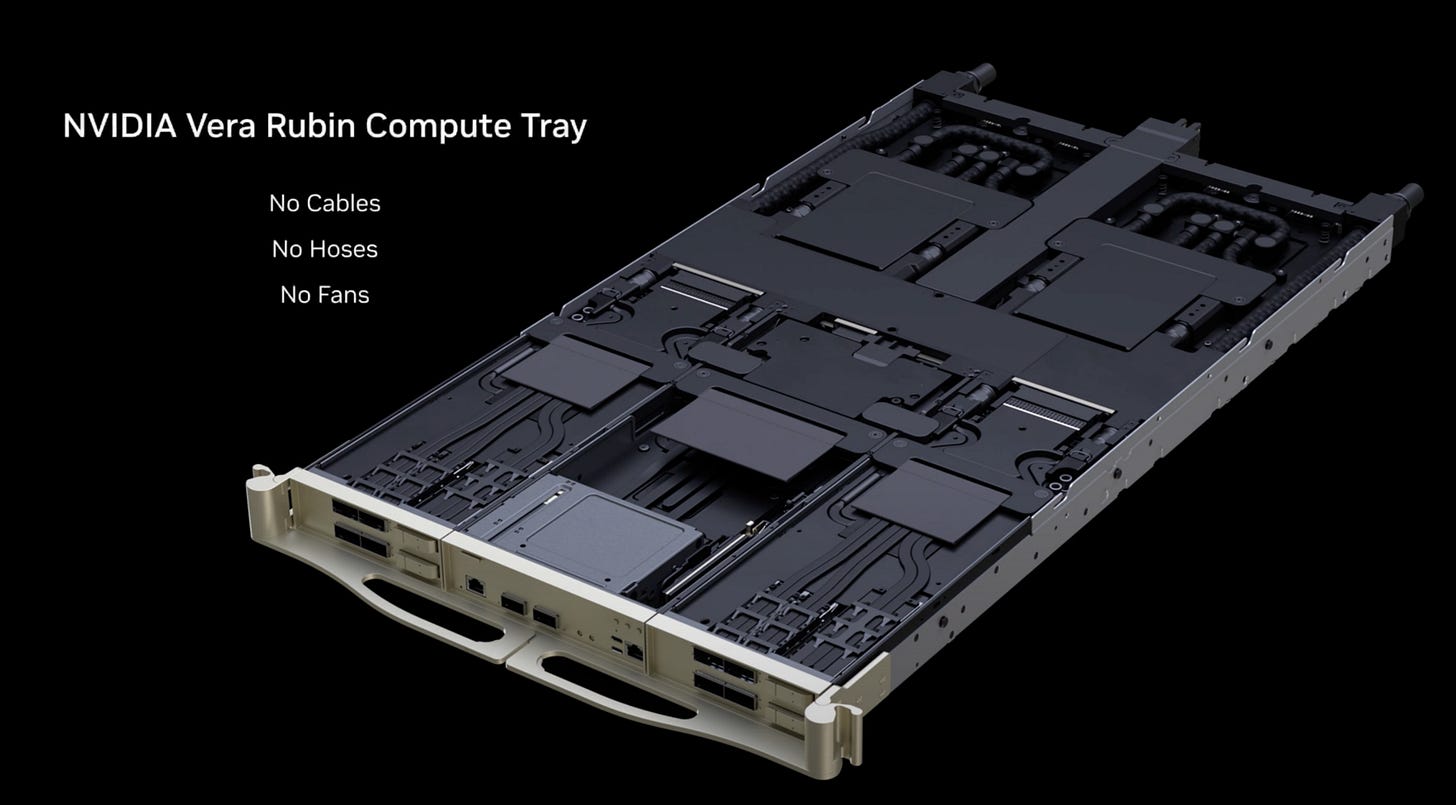
模組配置:
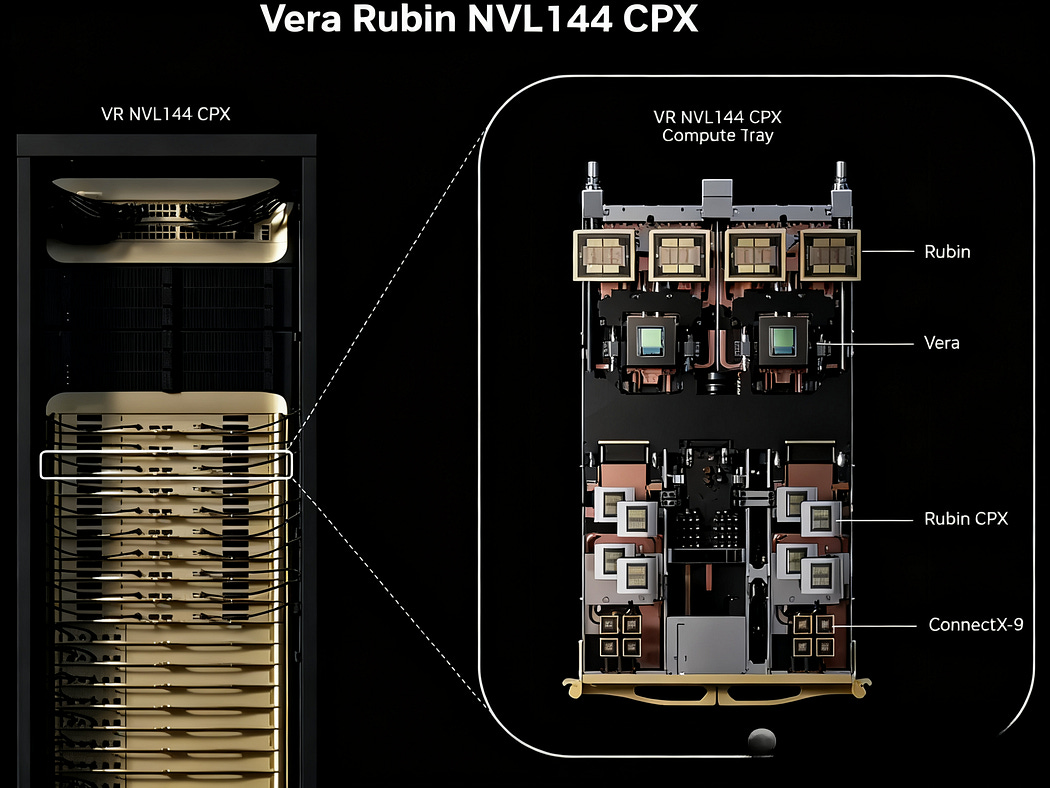
後方為 Strata 模組(含 2 顆 GPU、1 顆 CPU 與 SOCAMM);前方為 Orchid 模組(包含 CX-9 網卡與 800G 收發器)。將網卡移至前方是為了縮短高速乙太網路/InfiniBand 的實體傳輸距離。
SOCAMM(全稱 Small Outline Compression Attached Memory Module)是 NVIDIA 為了應對 AI 運算需求,與 Micron(美光)、Samsung(三星)及 SK Hynix 等存儲巨頭合作開發的一種新型模組化記憶體標準。
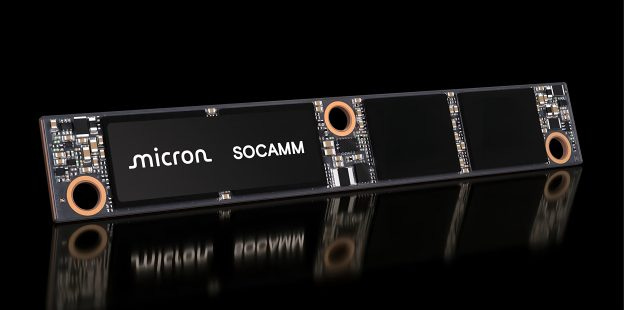
它結合了手機端使用的 LPDDR(低功耗記憶體)的高效能與傳統電腦記憶體的可更換性,被業界視為 AI PC 與 AI 伺服器的關鍵組件。
PCB 材料的全面升級:
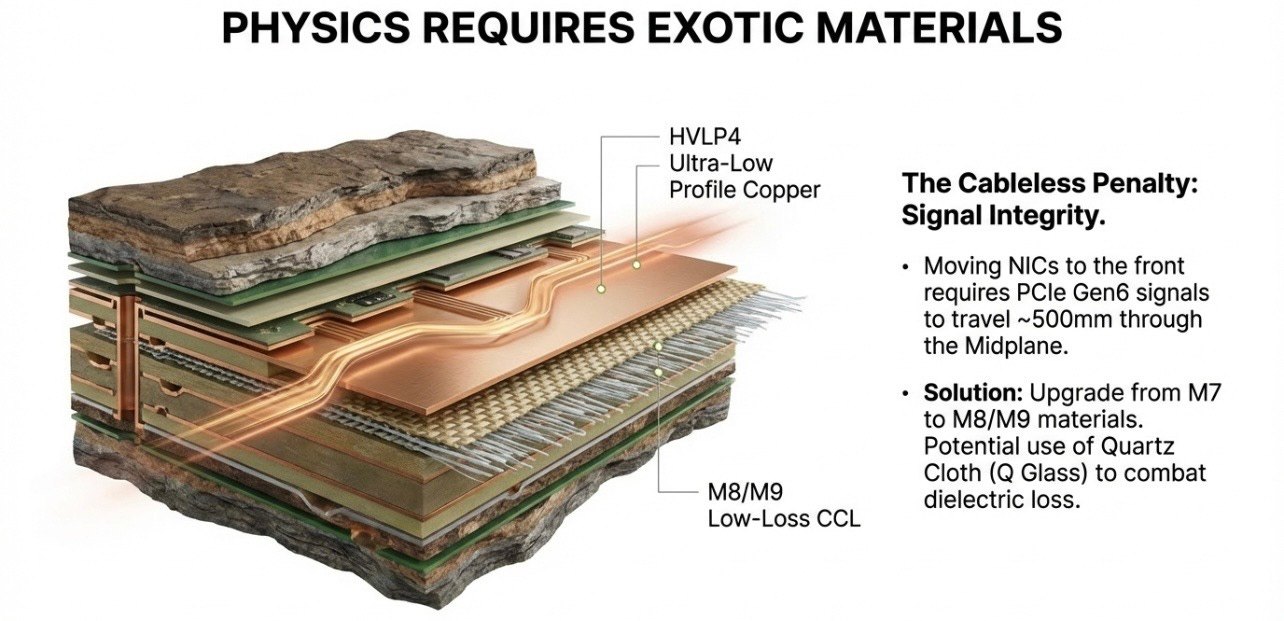
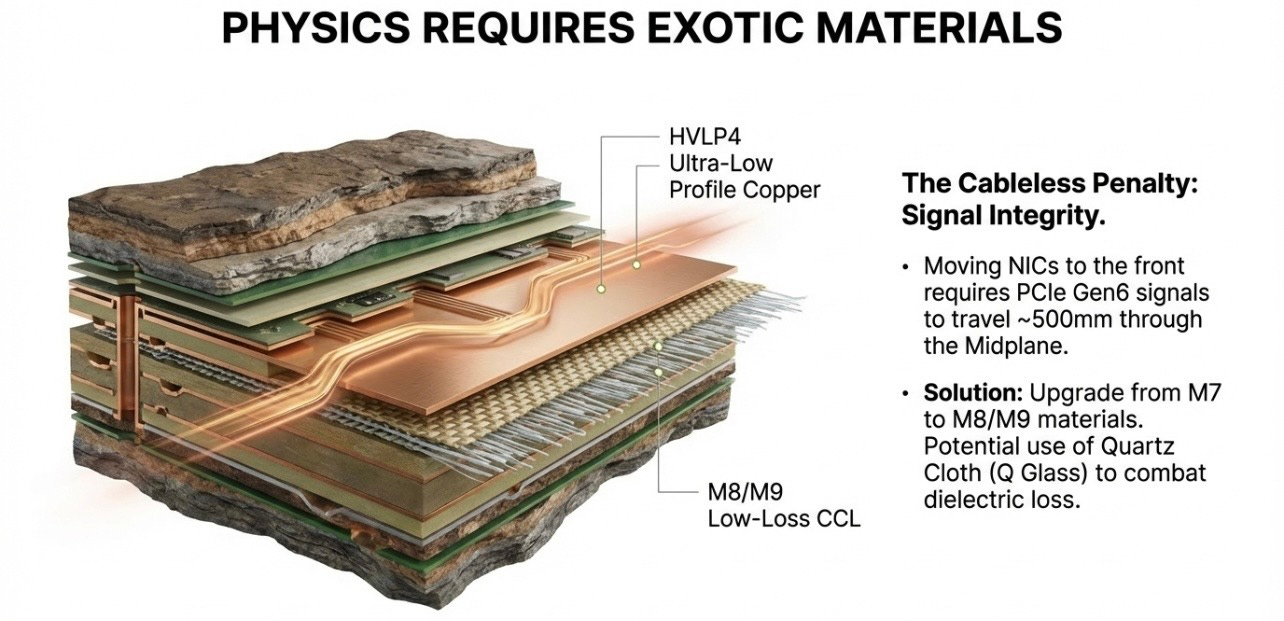
消除內部纜線意味著 PCIe Gen 6 訊號必須在 PCB 上行進約 500mm。為了克服嚴重的損耗,Nvidia 強制進行了大規模材料升級:
銅箔:全面升級至超平滑的 HVLP4 等級,以降低導體損耗。
銅箔基板(CCL):從 M7 升級至 M8/M9 規格。
玻璃纖維布:為降低介電常數,Nvidia 正在測試採用成本極高且加工困難的石英布(Q glass),但受限於良率,未來也可能降級回高階玻璃纖維。
整體而言,VR NVL72 內部的高階 PCB 面積比起 GB300 暴增了約 2.3 倍。
三、 突破極限的散熱與供電架構
隨著 Rubin GPU 的 TDP 攀升至 2,300W,單一機架的總功耗高達 180kW 至 220kW,散熱與供電架構面臨巨大挑戰。
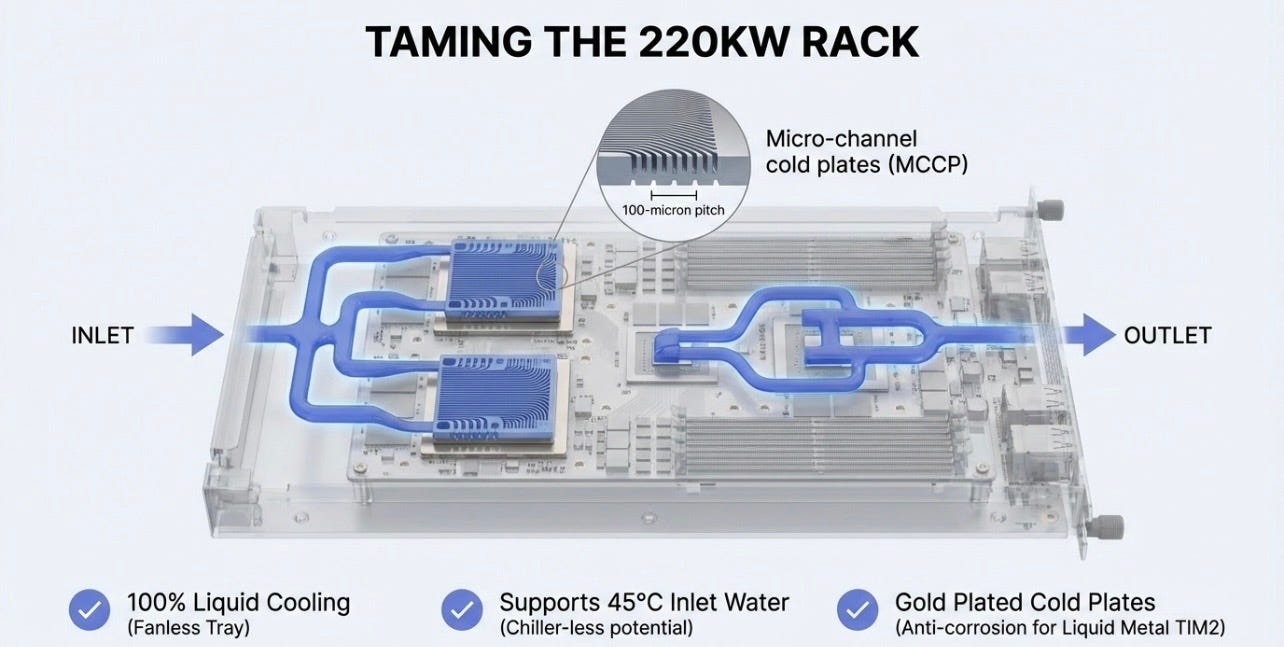
100% 液冷與「無冰水機」潛力:
運算托盤完全取消了風扇,採用 100% 液冷設計。GPU 採用了通道間距縮小至 100 微米的微通道冷水板(MCCP),表面鍍金以防止液態金屬散熱膏(TIM2)腐蝕。
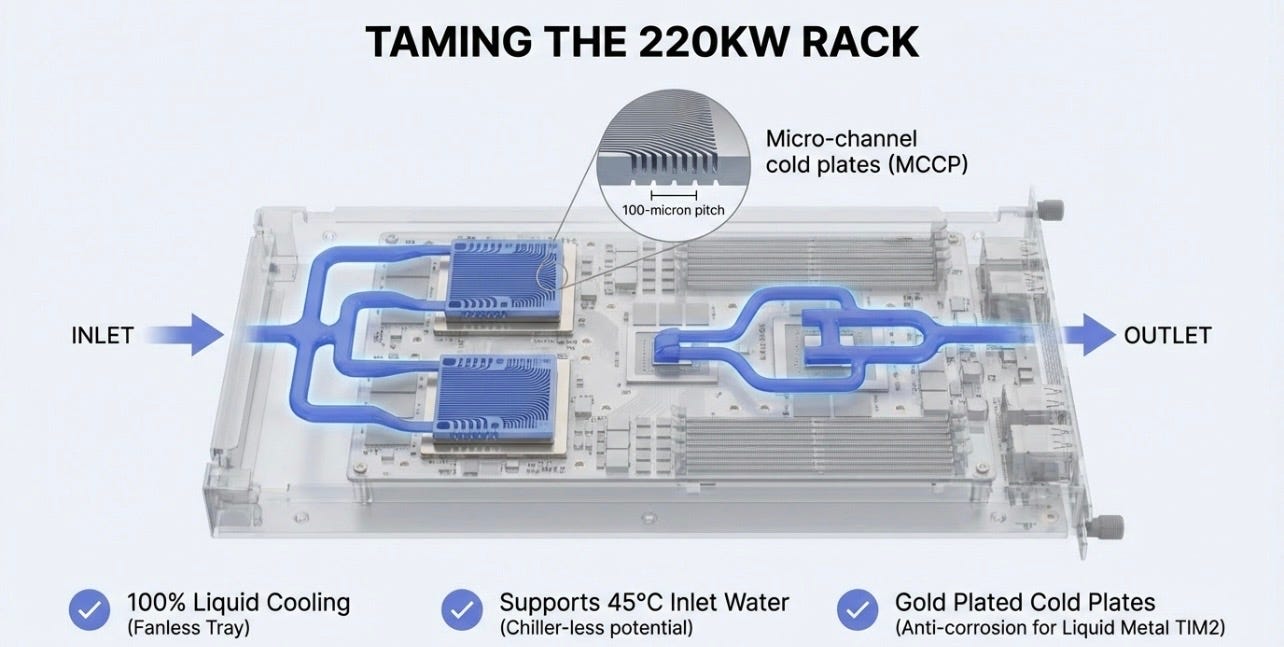
最震撼業界的是,VR NVL72 可承受高達 45°C 的入水溫度(出水溫度可達 65°C)。這讓資料中心得以建置免用機械壓縮式冰水機(Chiller-less)的冷卻迴路,大幅節省設施耗能。為應對緊湊的溫差,冷卻液流速需增加 2 到 2.5 倍,連帶推動了 2 吋快拆接頭(QD)、大型幫浦以及高達 3-6 MW 容量的冷卻分配單元(CDU)的需求。早前也有分享過”熱水”其實是PG25 冷卻液。
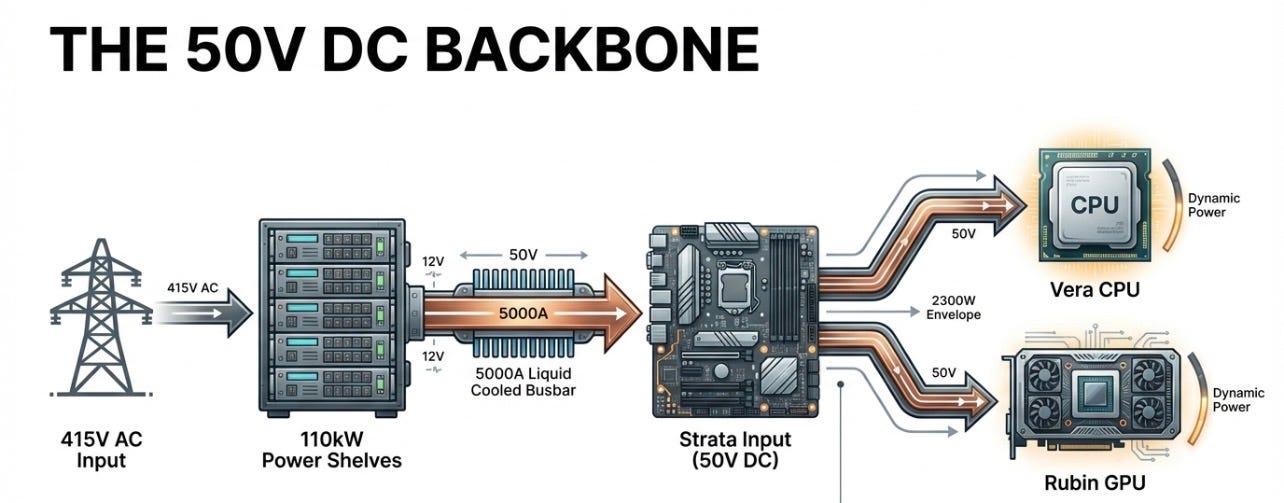
50V 直接供電與能量分配:
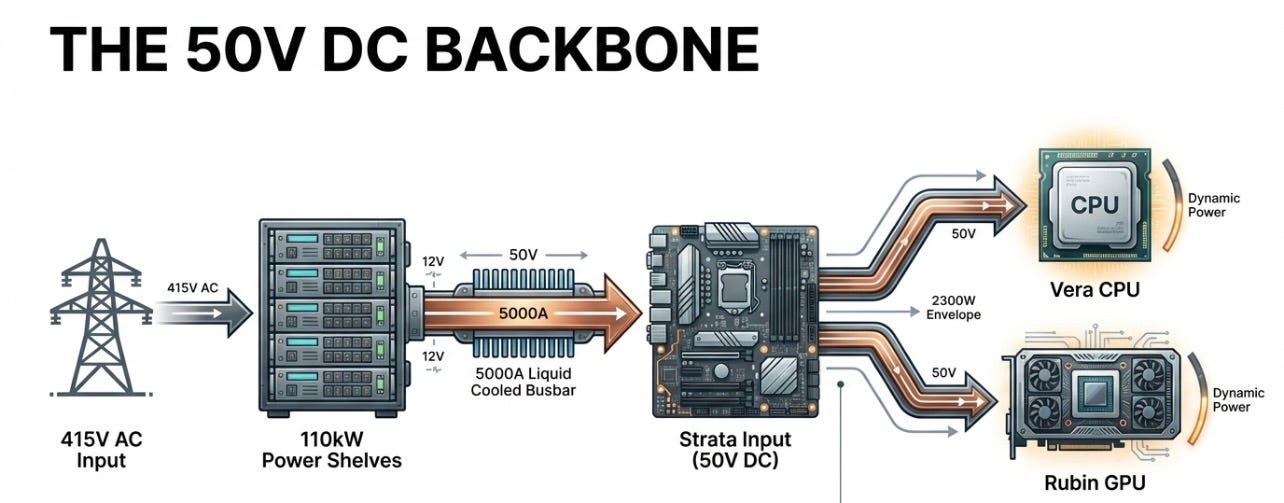
機架配備 4 個 110kW 電源架,將設施電壓轉換為 50VDC,並透過可承受 5000A 以上電流的液冷匯流排傳輸。
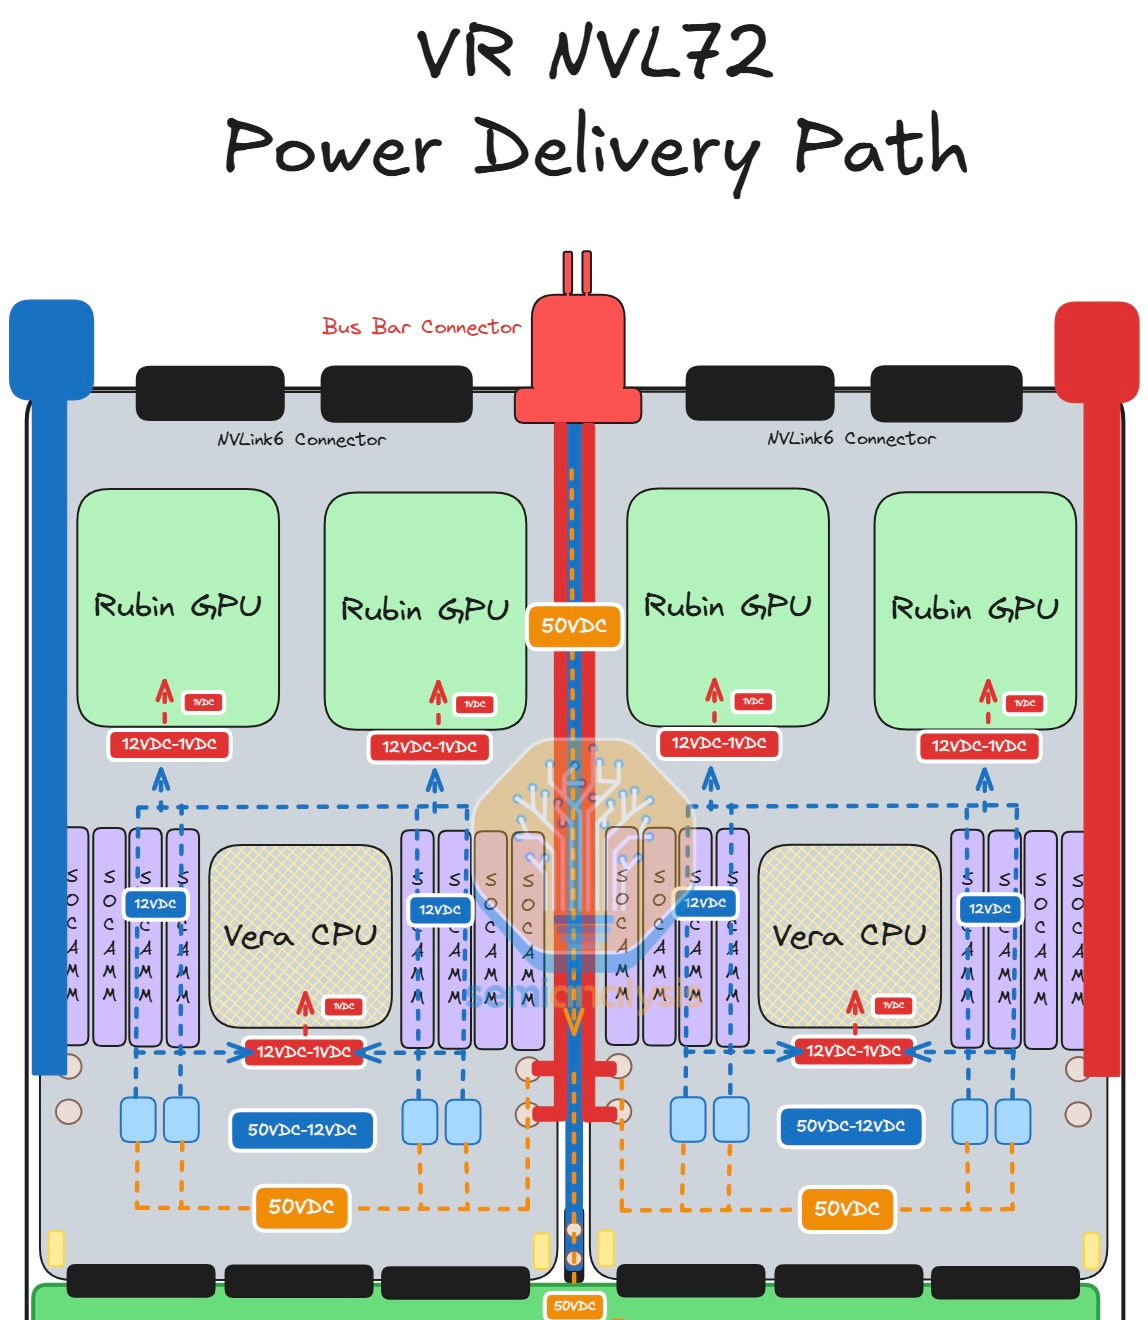
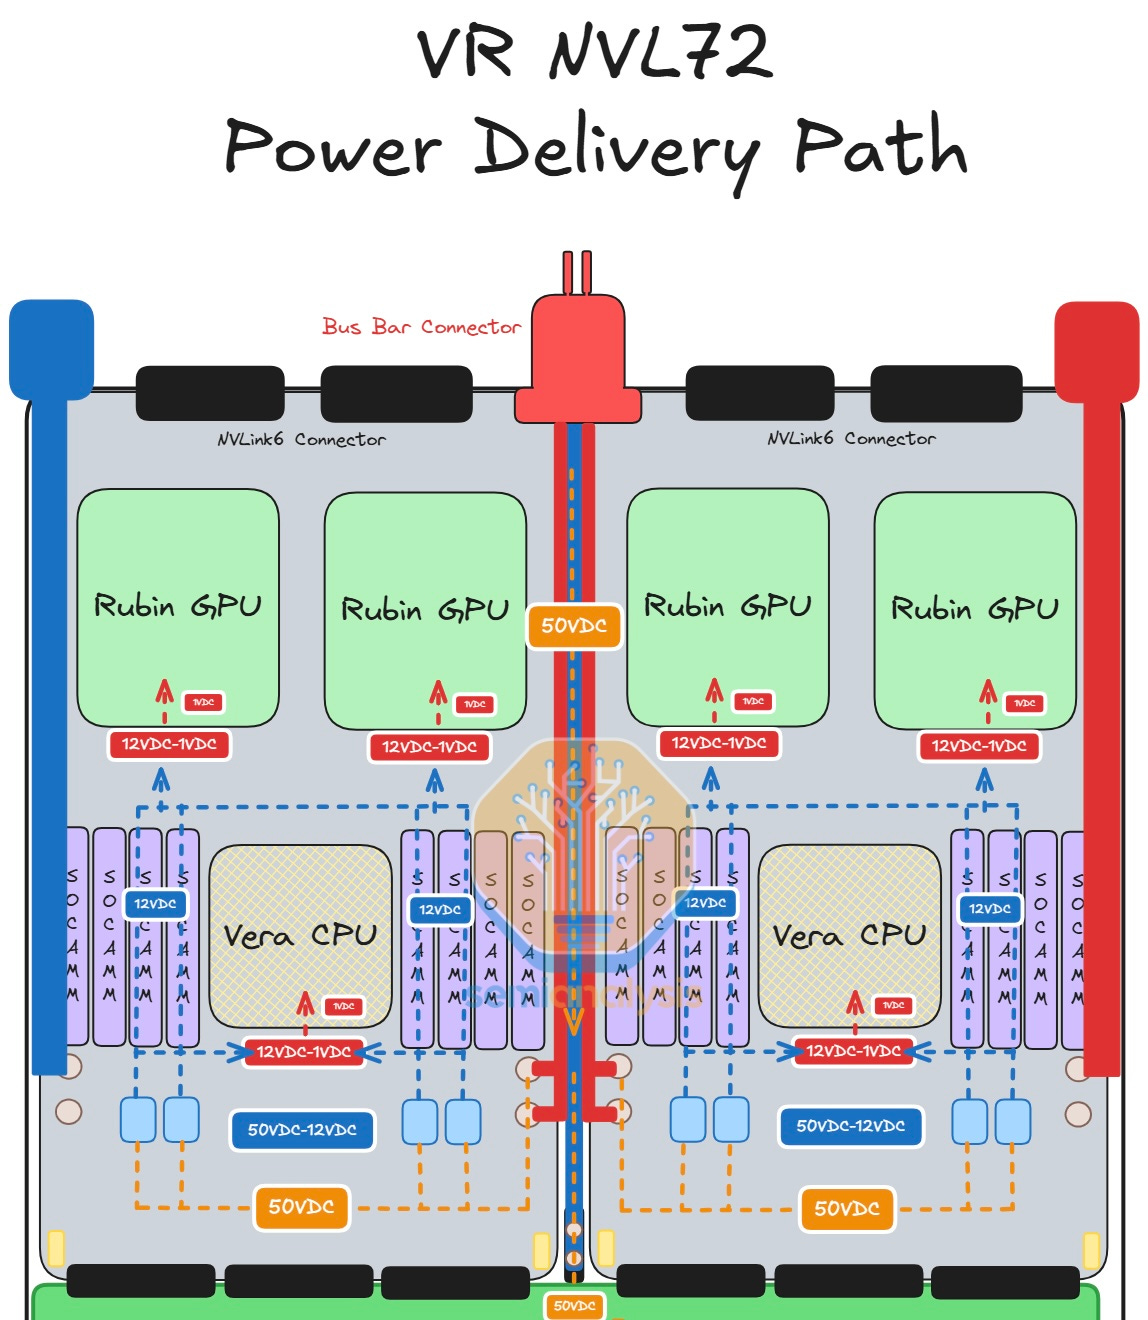
在托盤內部,50VDC 會直接送入 Strata 板後再降壓至 12V。這種做法( 96A@50V vs 400A@12V)能有效減少電力傳輸的損耗。
系統支援 「電源池化切換」(Power Sloshing):CPU 與 GPU 共用 4800W 的電源額度,當 GPU 閒置時,CPU 可動態借用電力以提升效能,避免過度配置供電。
Credit to SemiAnalysis
四、 次世代網路與全新記憶體
VR NVL72 在Scale-Up與Scale-Out 網路擴充上均有創新突破:
NVLink 6 銅線背板的雙向 SerDes:
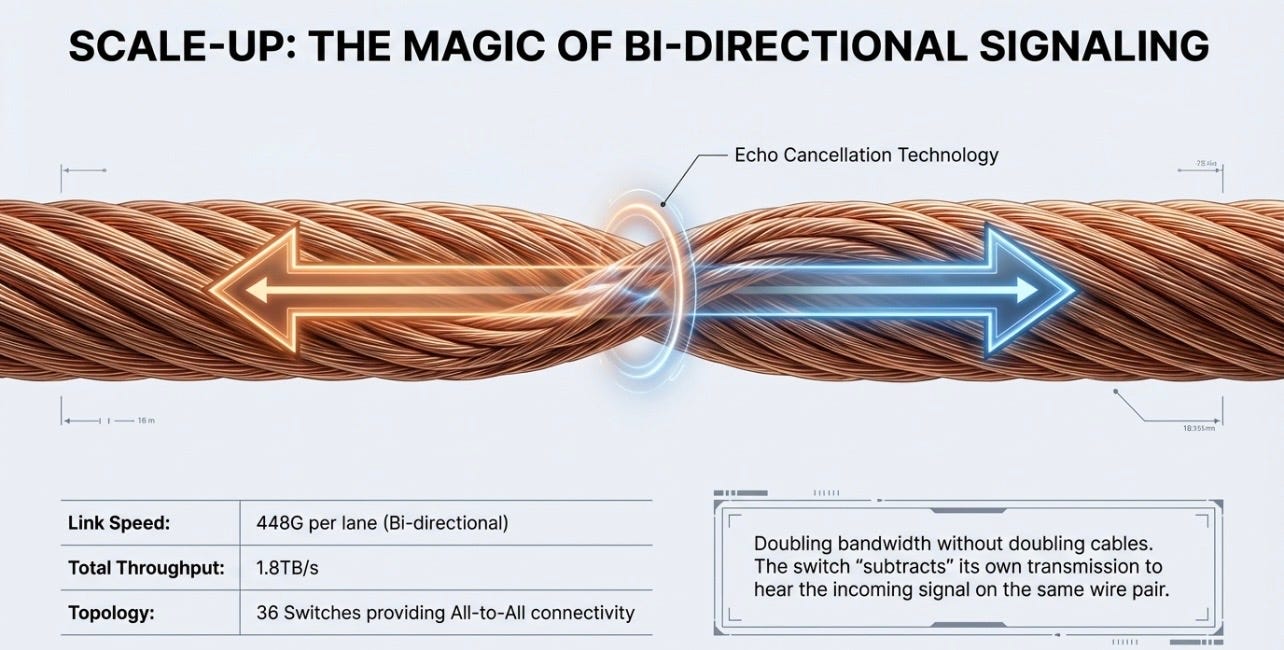
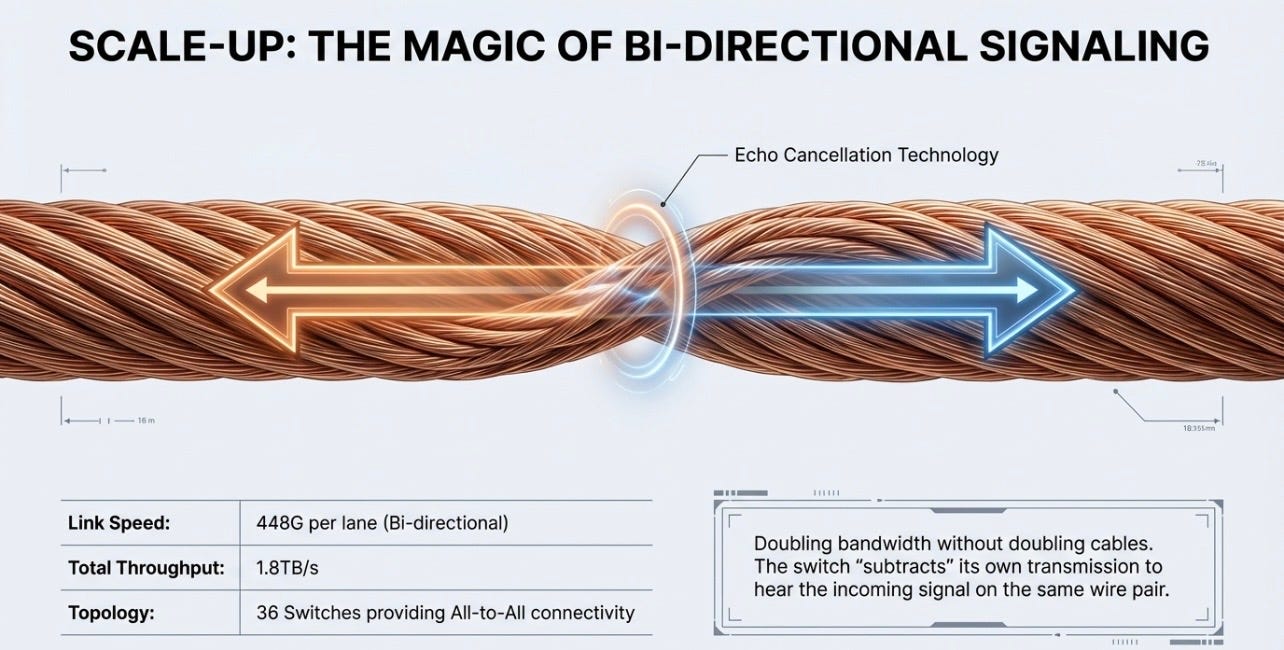
為了在不增加實體銅纜數量(避免裝配災難)的前提下使機架內頻寬翻倍,Nvidia 在銅線背板採用了 「雙向 SerDes」 技術。
允許訊號在同一條導線上同時雙向傳輸(每條 400G)。這需要在線路兩端安裝極其精密的「混合器(hybrids)」來生成反向的本地訊號副本,藉此進行回音消除(Echo Cancellation),防止自我干擾。
Scale-Out Multi-Plane 網路 (Max: 746,496 GPU):
每顆 GPU 具備兩個 800G OSFP 介面(總計 1.6T)。這種將頻寬分割的設計,讓超大型企業能輕易建構Multi-plane 網路,三層交換架構下,InfiniBand 能擴展支援高達 746,496 GPU。
共封裝光學(CPO)的崛起:Nvidia 強推如 SN6800 等 CPO 乙太網路交換機不僅降低了約 70% 的網路設備功耗與 75% 的收發器成本,交換機內建的Fiber Shuffle 設計也讓工程師免於處理外部雜亂的「章魚纜線」。
新興生態系:CPX 與 CMX/ICMS:
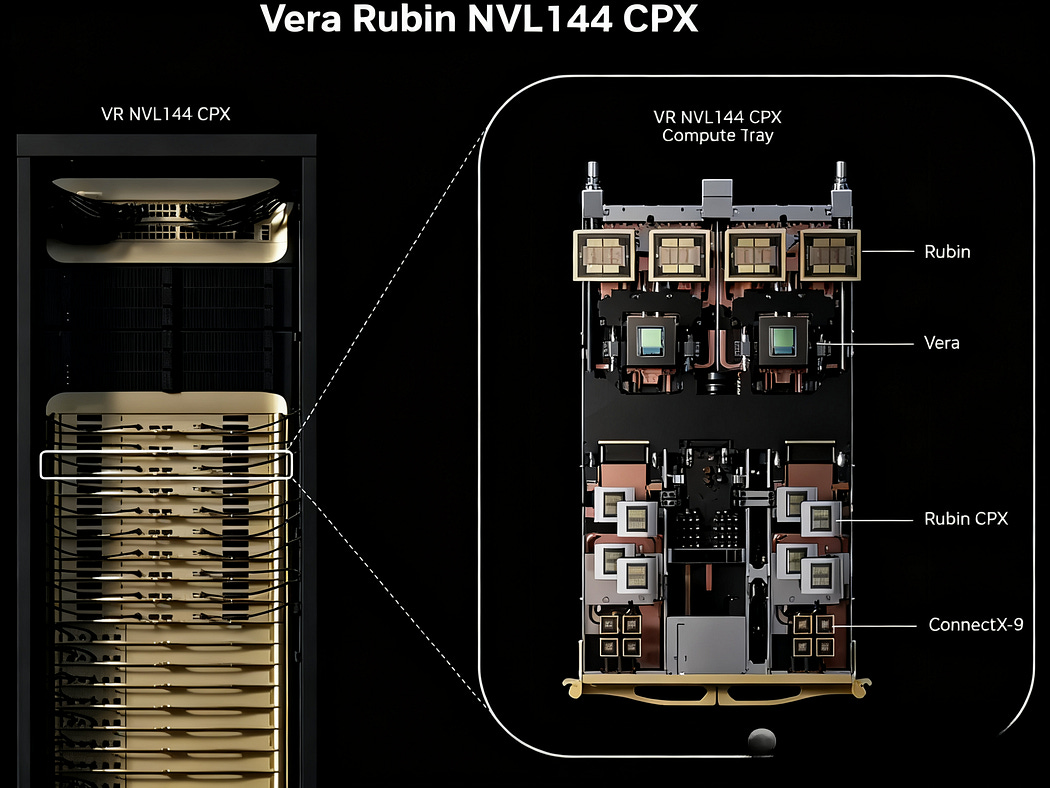
CPX 預填充機架:為了優化資料中心電力與故障域,Nvidia 將原本計畫內建的 CPX 加速器拆分為獨立的雙機架配置,將受限於算力的「推論預填充(Prefill)」與受限於頻寬的「解碼(Decode)」工作負載在硬體上徹底分解。
推論上下文記憶體儲存(CMX/ICMS):為了解決超長上下文與代理 AI 帶來的 KV Cache 儲存危機,Nvidia 引入了專門的快取記憶體網路層。此架構由 BlueField-4 DPU 直接在儲存陣列上處理 RDMA 流量,將 KV 數據移動從主機 CPU/GPU 中獨立出來。
五、 TCO 總體擁有成本與市場護城河
Vera Rubin 平台的效能極強,但造價也同樣驚人。VR NVL72 單顆 GPU 的資本支出比 GB300 高出約 45%,比 AMD 的 MI400 系列高出約 14-15%。然而,Nvidia 在供應鏈與軟體優勢上築起了難以跨越的護城河:
記憶體供應鏈的價格避險: Nvidia 透過其 SOCAMM 模組,直接向供應商採購 LPDDR5X 記憶體。憑藉巨大的採購量,Nvidia 能鎖定長期優惠價格,等同於幫客戶扛下了記憶體市場漲價的風險(充當 AI 界的中央銀行)。相反地,AMD 的架構依賴機架組裝廠自行去現貨或合約市場採購大量 DDR5 記憶體,使買家完全暴露在記憶體漲價的風險中。
軟體效能兌現 TCO 的關鍵: VR NVL72 的 TCO 競爭力高度取決於其動態 FP4 精度效能。如果自適應壓縮引擎發揮其作用,伺服器的營運成本可降低約 20%。
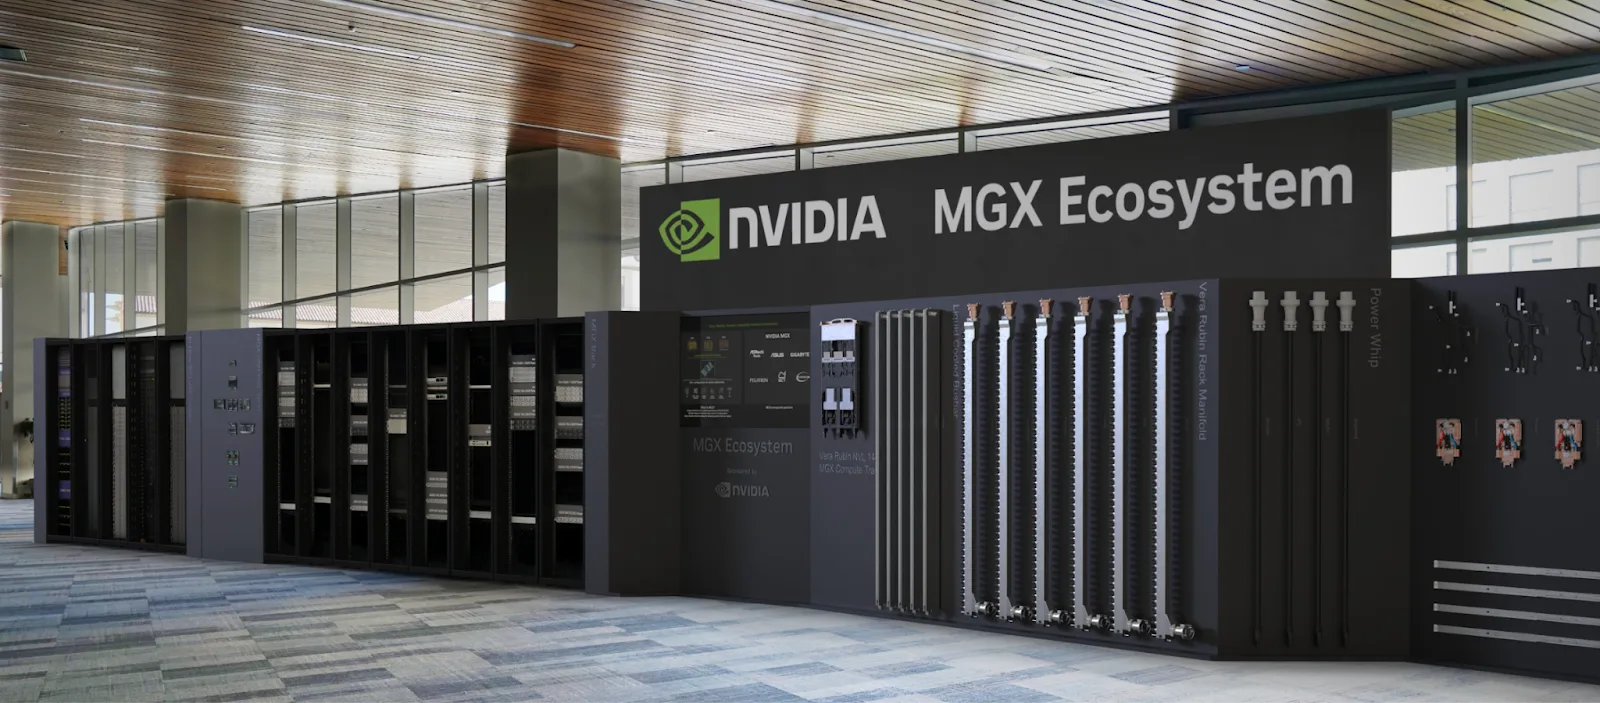
總結來說,Nvidia Vera Rubin 透過極端協同設計,從晶片、無纜化 PCB、45°C 液冷、雙向銅線背板,一路包辦到專屬的快取網路儲存架構。這種高度封閉且環環相扣的生態系統,正是對手難以單靠一顆晶片的升級就能輕易突破的終極壁壘。
全新Groq LPU 架構傳聞及個人觀察
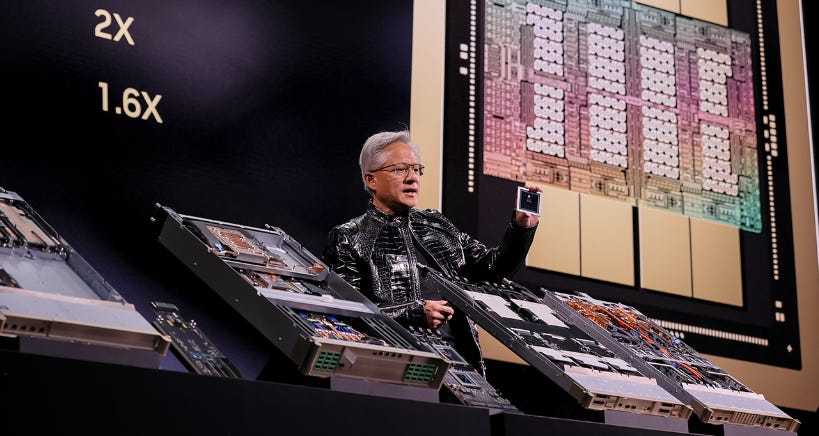
根據目前 2026 年 3 月初的市場傳聞與供應鏈流出的消息,NVIDIA 即將在 3 月 16 日開幕的 GTC 2026 發表一場「震撼世界」的演說。
目前市場對於 NVIDIA 整合 Groq LPU(Language Processing Unit)技術(12月透過一筆高達 200 億美元的授權協議獲得)的預測主要集中在 Feynman架構,並延伸出幾種截然不同的硬體形態。
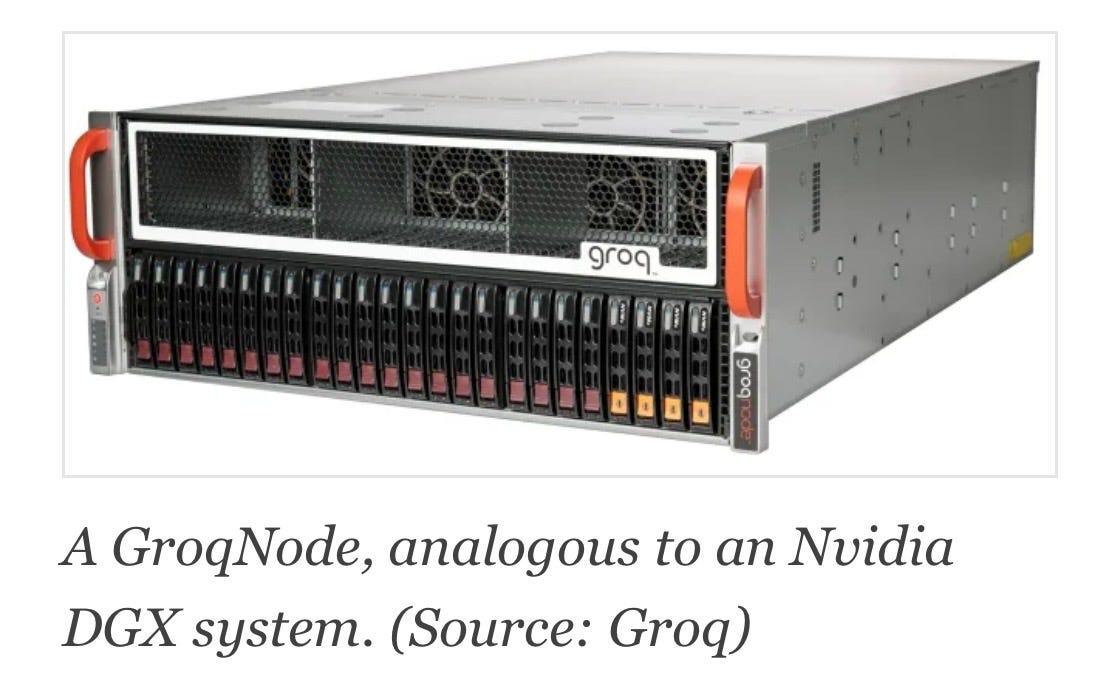

市場上流傳的6種主要版本:
隨著 GTC 2026 的大幕即將拉開,市場對於 NVIDIA 與 Groq 技術融合的傳聞已達到沸點。黃仁勳對筆記型電腦消費級產品的野心,與 Jonathan Ross 對「零延遲確定性運算」的痴迷,正透過 Feynman(費曼) 架構及一系列衍生產品交織成一場硬體革命。
以下是針對市場傳聞整理的 6 大 LPU 整合版本深度分析:
1. 旗艦整合架構:Feynman + On-Package SRAM
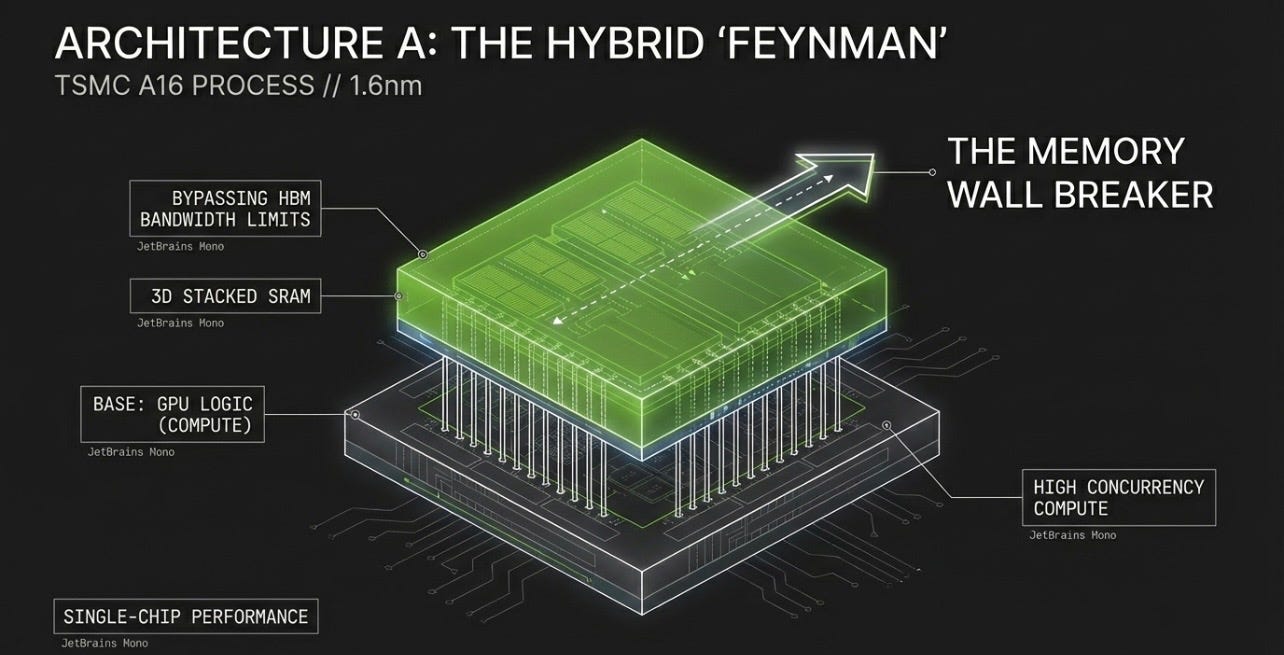
這是技術討論度最高的核心方案,旨在攻克大型語言模型(LLM)最致命的「記憶體牆」難題。傳聞 NVIDIA 將 Groq 的 LPU 技術直接以3D 先進封裝技術整合在 TSMC A16 (1.6nm) 製程的 Feynman 晶片中。日前博通($AVGO) 已率先公佈及交付3.5D 封裝晶片予富士通。
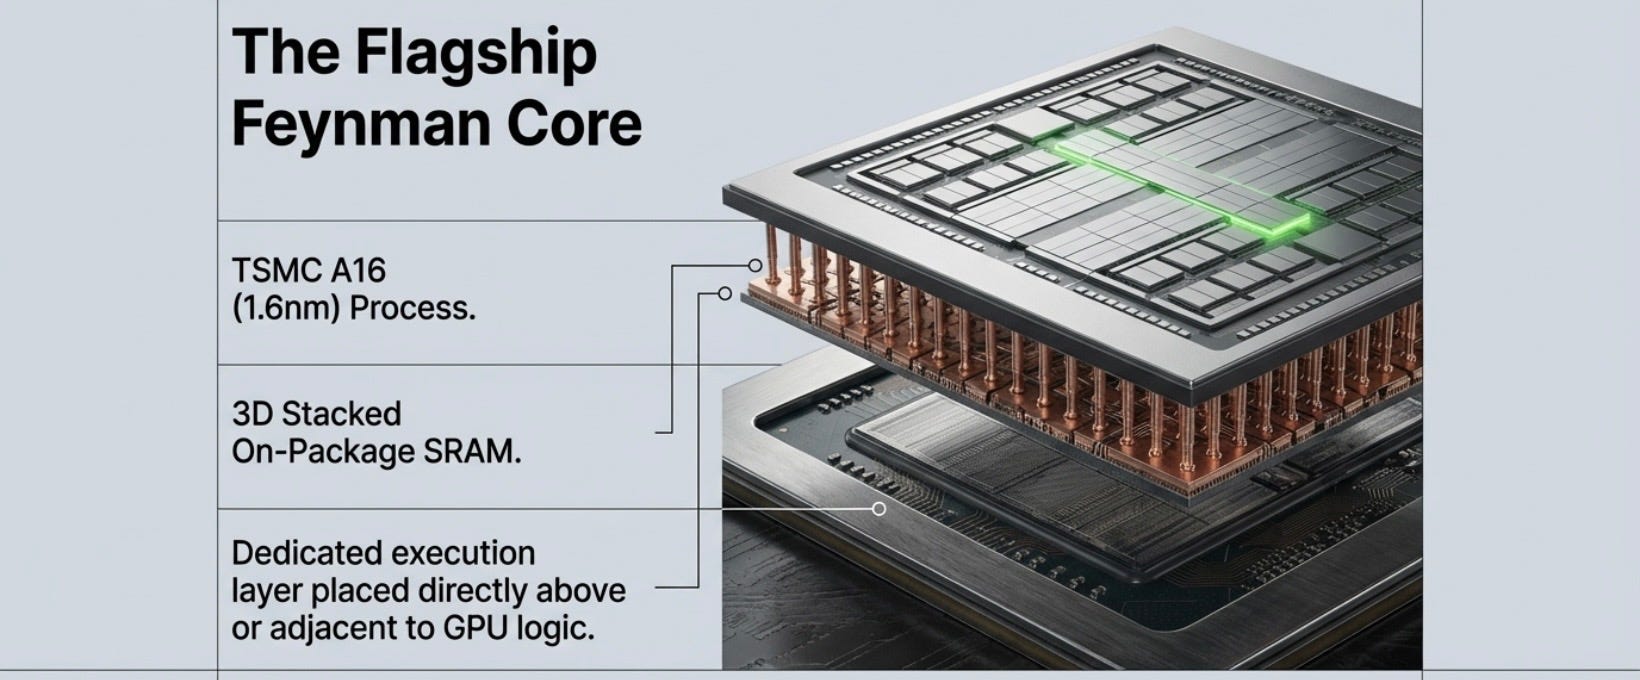
透過 3D 堆疊技術,在 GPU 邏輯層上方或側面放置極大規模的 SRAM 專用運算層。這項設計的妙處在於利用 SRAM 納秒級的超高頻寬與極低延遲,專門用來存放生成過程中的 KV-Cache。這讓推理過程徹底繞過 HBM 的頻寬限制,成為單機高併發推理任務的終極神經網路加速器。
坊間以這個版本傳得最廣,但我認為這個版本只是用Groq 授權的SRAM 技術或Complier 相關的專利,實際未必是把LPU跟GPU及CPU 整合,而台積電也暫時未有3D 先進封裝的正式公佈。
2. 獨立機架方案:Disaggregated LPU Rack (256 LPU)