


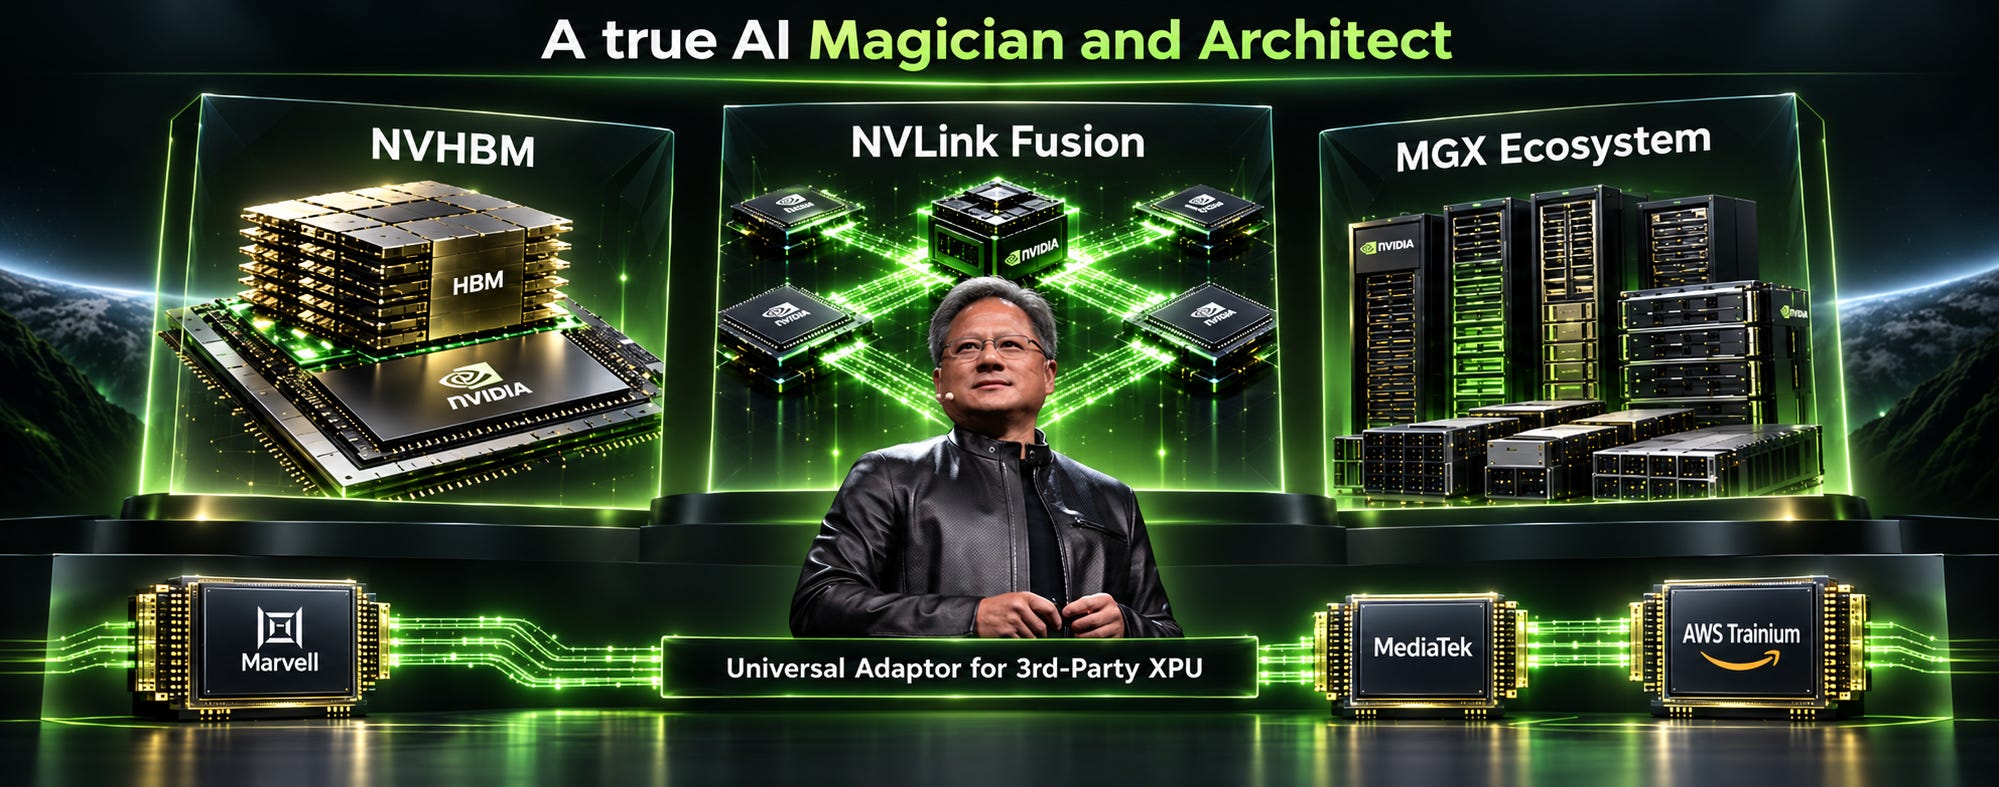

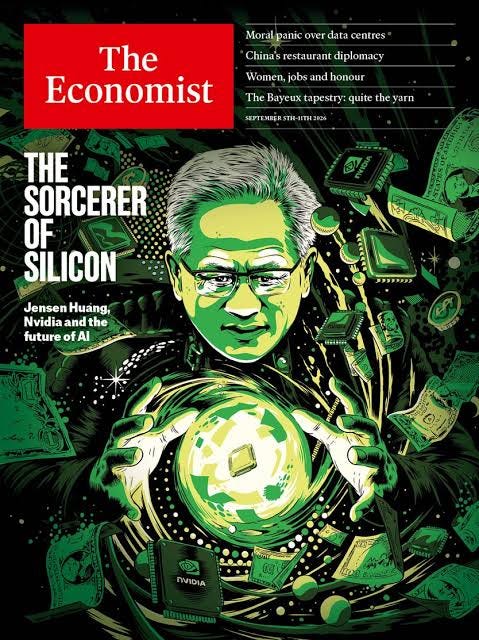
《經濟學人》最新一期封面是黃仁勳,標題是 「The Sorcerer of Silicon(矽之魔法師)」,顯然「AI 教主」已不足以形容黃仁勳的地位,但這不是替 NVIDIA 造神,而是代表市場對 NVIDIA 的定位已經由「賣 GPU 的晶片公司」,提升為 AI 時代的系統架構師與資本配置者。《經濟學人》的核心觀點甚至相當鮮明——「Nvidia is driving the AI boom. Good」,NVIDIA 對晶片、網路、AI 工廠與整個 AI 生態系所作的巨額押注,正是資本主義應有的高風險、高回報創新模式。 Sorcerer 這個字也選擇得非常到位,如果用 RPG 的語境來解讀,Sorcerer 往往帶有強烈的主動進攻色彩,我自己也覺得這與黃仁勳近年的架構擴張策略頗為貼切。
對投資者而言,這個封面的意義是:未來判斷 NVIDIA 的價值,已不能只看 GPU 銷量,而要看它能否透過 CUDA、NVLink Fusion、NVHBM、MGX 等技術與生態系,把自己變成第三方 XPU、記憶體、網路與資料中心都必須接入的「AI 基礎設施標準層」;一旦成功,它的護城河會比單純的晶片效能領先更深。不同於蘋果時代擠牙膏式創新、股東回報最大化、供應鏈「極致性管理」;黃仁勳選擇以「Speed of Light」速度創新及推出新產品系列,70%以上毛利率的背後,除了平衡股東回報外,更積極投資未來及生態,無論是台灣為主的硬件供應鏈,還是軟件應用的開源生態都全力支持,眼光是放到人類少數革命式創新的時代上,心態上是以生態合作,共同創造為優先。
什麼是 AI 資料中心的架構設計(Architecture Design)?
如果把 AI 資料中心比喻成一棟摩天大樓,GPU 只是其中最重要的建材之一;「AI Architect」就是總建築師,決定整棟大樓要怎麼蓋才能效益最大化就是架構設計,包括 GPU、CPU、記憶體、網路、散熱、電力與軟體如何彼此配合。NVIDIA 現在做的已不只是賣「磚頭」,而是連大樓的結構、管線、電梯和施工「標準」都一起設計,甚至讓其他廠商按照它的規格接進來,就是「極致共同設計」(Extreme Co-Design),也是 NVIDIA 的核心競爭力,已經從單一晶片性能,逐步提升到主導整個 AI 基礎設施的架構。
什麼是 NVLink /NVLink Fusion、Ethernet ?
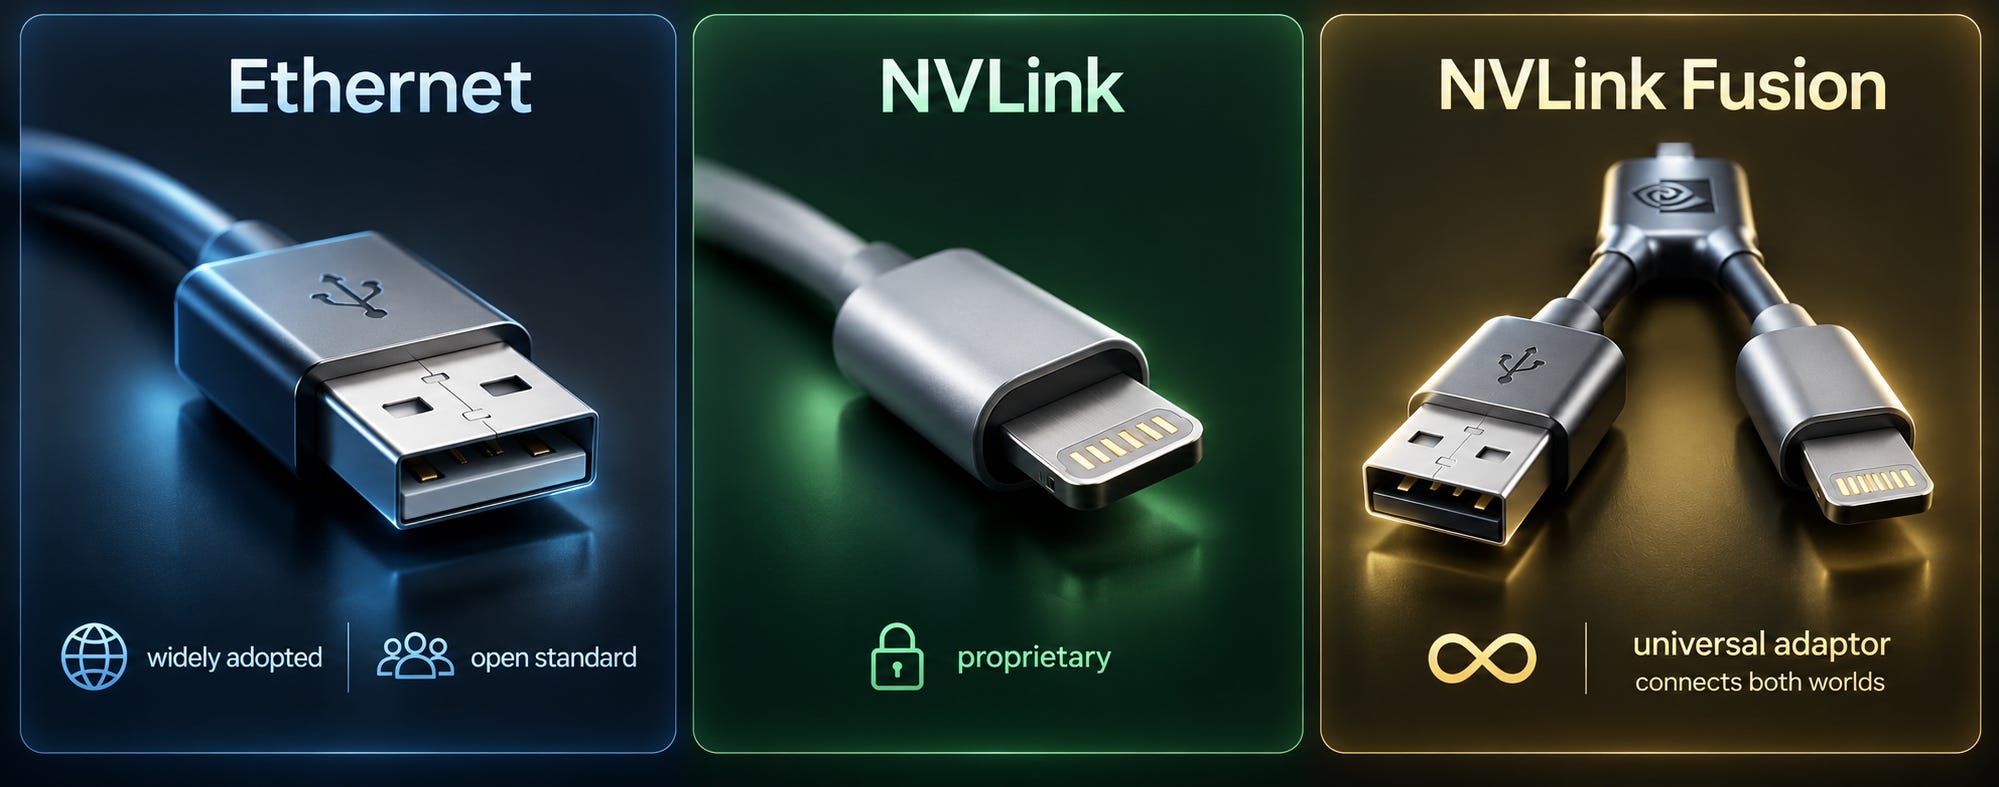
Ethernet 是目前最普及的有線網路技術與標準,就像 USB:通用、標準化、跨品牌。
NVLink 就像 Apple 的 Lightning Cable: Apple 自己設計,生態深度優化,相容範圍較封閉。
這只是簡單比喻,Lightning 本質上仍然只是外部 I/O cable,而 NVLink 的角色遠比 Lightning 深,NVLink 更像只存在於 Mac 內部的超高速專用匯流排,外人不一定能用,但因為 CPU、記憶體、晶片和軟體全部由 Apple 一起設計,所以可以做得非常緊密。NVLink 不只是「接線」,而是讓大量 GPU 進行高頻率、低延遲的資料交換,甚至形成接近「一個大型運算系統」的 Scale-up fabric。
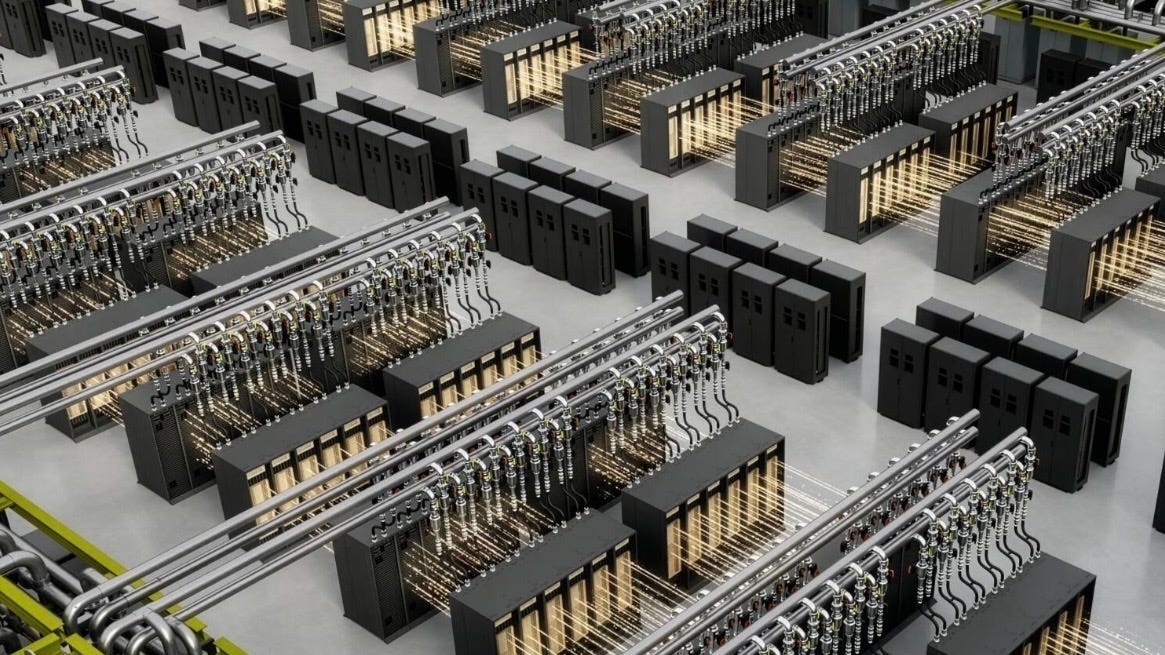
AI 發展最重要的驅動力之一是 Scaling Law:隨著模型、數據與算力持續擴張,運算需求呈高速增長。但當單顆 GPU 已無法滿足需求,如何把大量 GPU 高效率連接起來,就成為 Scaling 能否持續的關鍵,NVIDIA 的 NVLink 是為大規模高效能運算而設計的 GPU Scale-up 高速互連技術,相較傳統 PCIe,提供更高頻寬與更低延遲;而 NVLink Spine 則是機架內承載這些高速連線的實體互連骨幹,配合 NVSwitch,讓大量 GPU 可以在單一 Scale-up Domain 中高度協同運算。
NVLink = 通訊技術 / Protocol + PHY
NVSwitch = 中央交換樞紐
NVLink Spine = 機架內實體互連骨幹
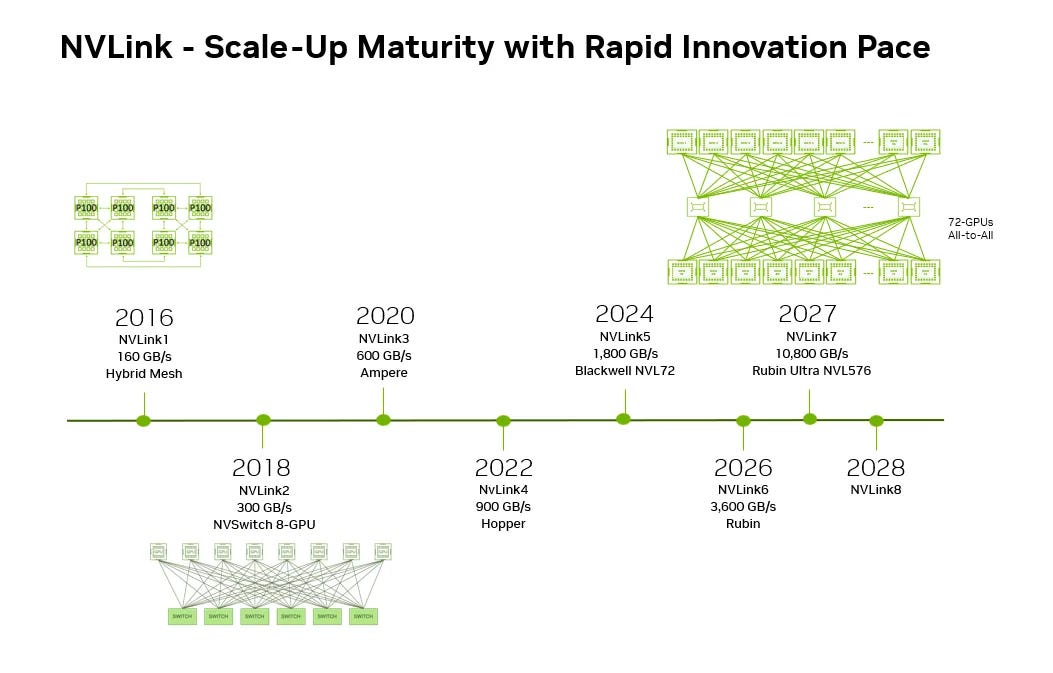
透過 NVLink 與 NVSwitch,一整櫃 GPU 可以在邏輯上更接近「一顆巨型加速器」般協同運算。2025 年 GTC 展示這個概念時仍是 Grace Blackwell 世代;到了 2026 年,Vera Rubin 已進入全面量產(Full Production);同樣以 72 顆 GPU 的 NVL72 比較,在 Dense FP8/FP6 訓練峰值算力上,相較 GB200 NVL72 約提升 3.5 倍。
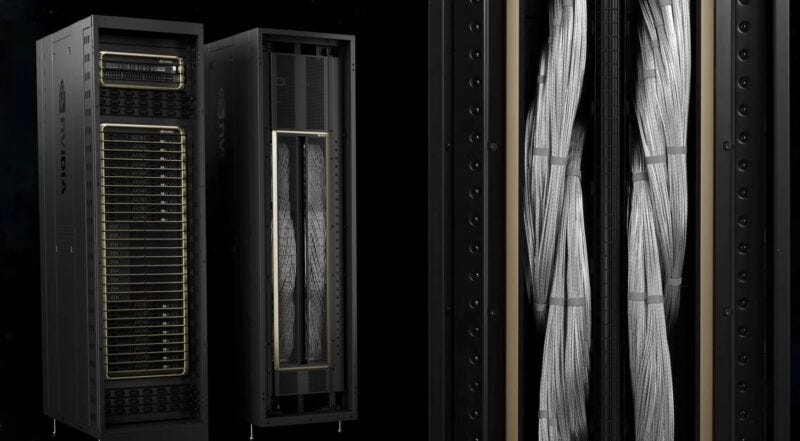
Blackwell 已經是相當革命性的設計。GB200 NVL72 首次在機櫃後方放入 4 個垂直 NVLink cartridges、超過 5,000 條 coaxial copper cables,透過 9 個 NVLink Switch Trays 把 18 個 Compute Trays 內的 72 顆 GPU 形成單一 NVLink domain。Vera Rubin 沿用這套 Copper-Spine 架構,但透過 NVLink 6 將每 GPU 與整櫃 Scale-up 頻寬翻倍。
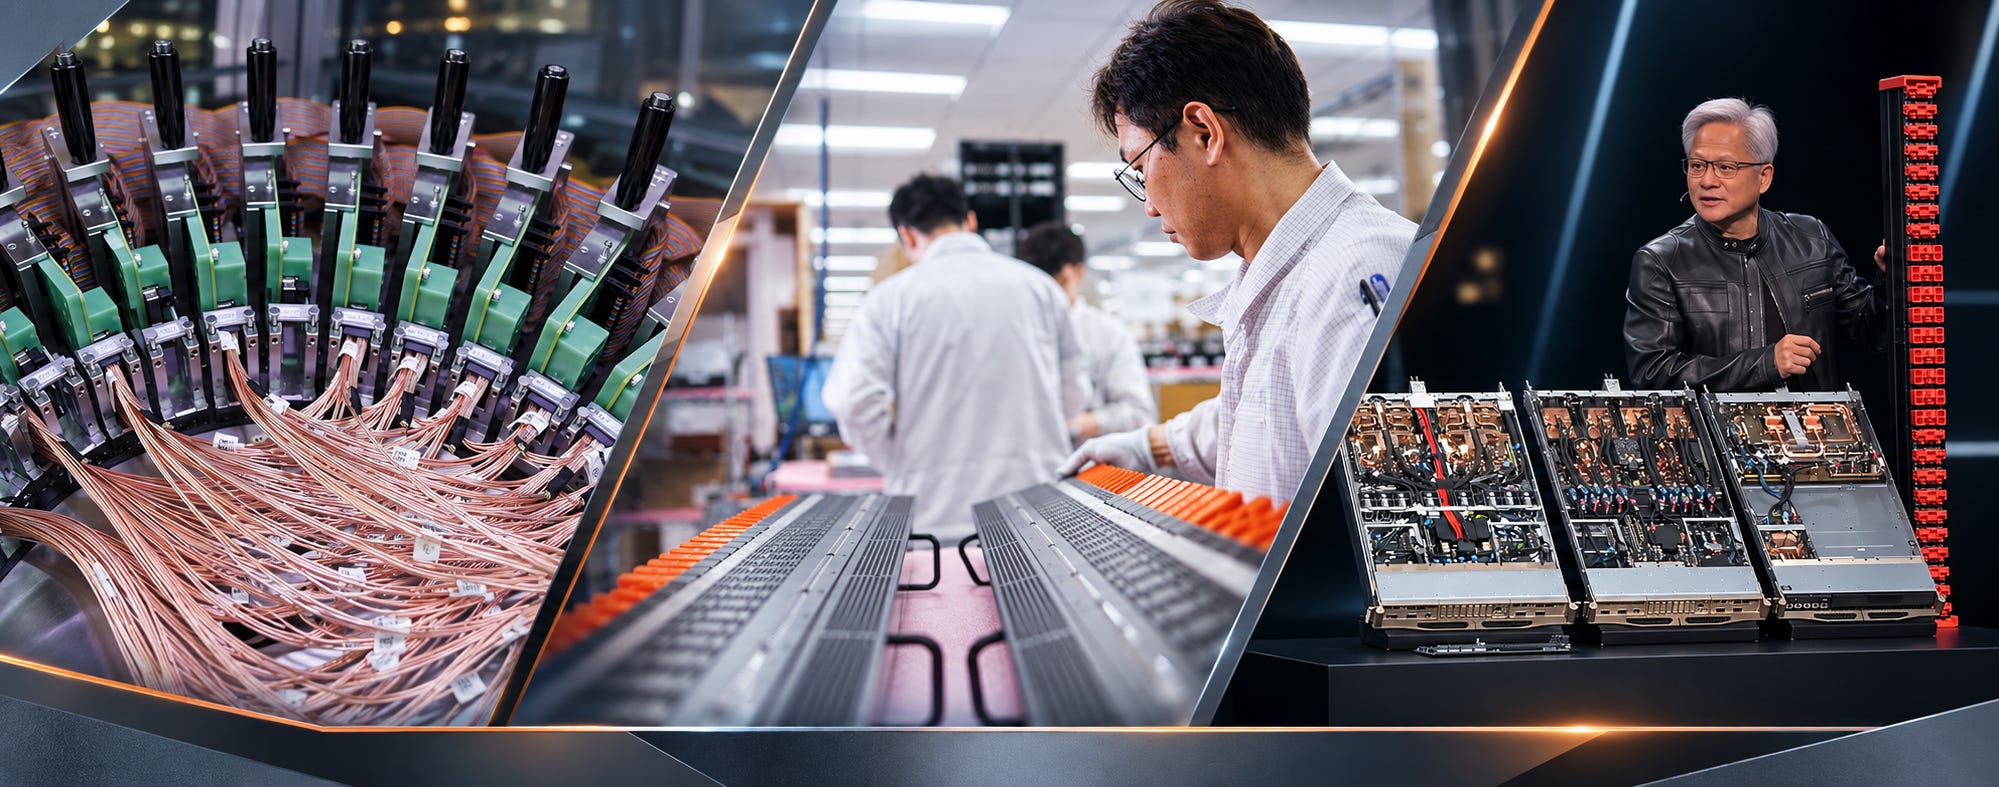
Rubin 透過第三代 MGX 將 NVLink Spine 的 Cable Cartridges 進一步模組化、預整合及預驗證;同時在 Compute Tray 內導入 PCB Midplane,大幅減少內部線纜與組裝複雜度。換言之,Rubin 並非把整個 NVLink Copper Spine 改成 PCB Midplane,而是在保留 rack-level copper spine 的同時,重新設計 tray-level connectivity。
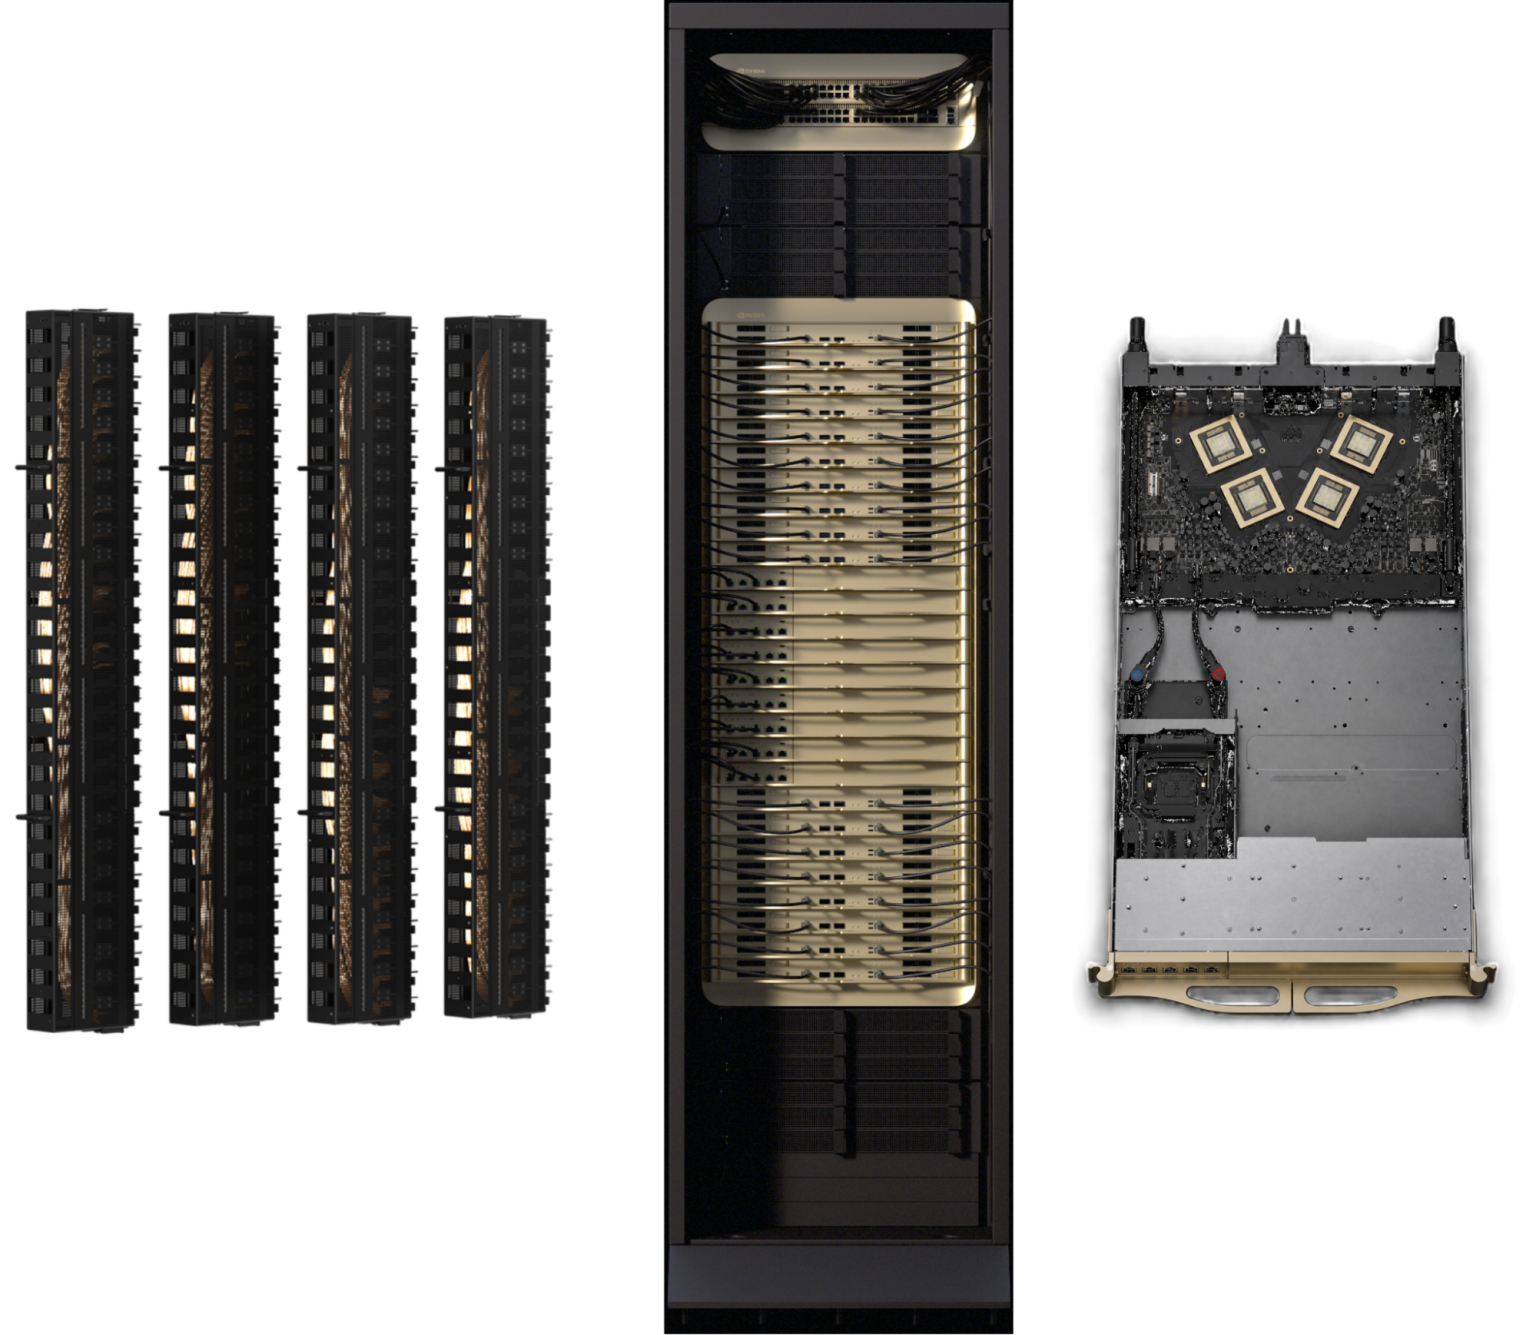
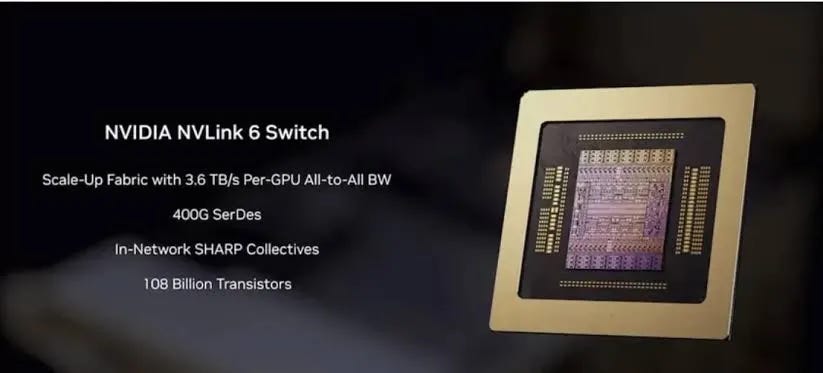
NVLink 6 架構支援熱插拔交換器托盤(Hot-swappable Switch Trays),無須讓整個機架停止運作即可維護個別組件。更重要的是,NVLink 的 Scale-up 已準備由單一機櫃走向 Multi-Rack:Vera Rubin NVL72 為每櫃 72 顆 GPU,下一代 Kyber 單櫃將提升至 144 顆 GPU(NVL144);透過 Direct Optical Interconnect,未來可將多個機櫃連成 NVL576,甚至最高 1,152 顆 GPU 的單一 NVLink Scale-up Domain,而 NVIDIA 的 NVLink 技術藍圖亦將進一步導入 CPO。
NVLink-C2C (CPU 到 GPU 互連)
NVLink-C2C 可以理解為:「把 CPU 與 GPU 從兩個經 PCIe 溝通的獨立元件,變成更像一顆大型 Superchip 內的兩個運算單元。」在 Vera Rubin NVL72 平台中,Vera CPU(具備 88 個 custom Olympus 核心、高頻寬且低能耗)與 GPU 之間透過 NVLink-C2C 提供 1.8 TB/s 的 coherent bandwidth/一致性互連頻寬(達 PCIe Gen6 的 7 倍)。這建立了統一的一致性記憶體架構,大幅降低控制、記憶體與運算間的瓶頸,同時簡化軟體編程,並支持 KV Cache 卸載、多模型執行、數據處理與代理協調(agentic orchestration)。
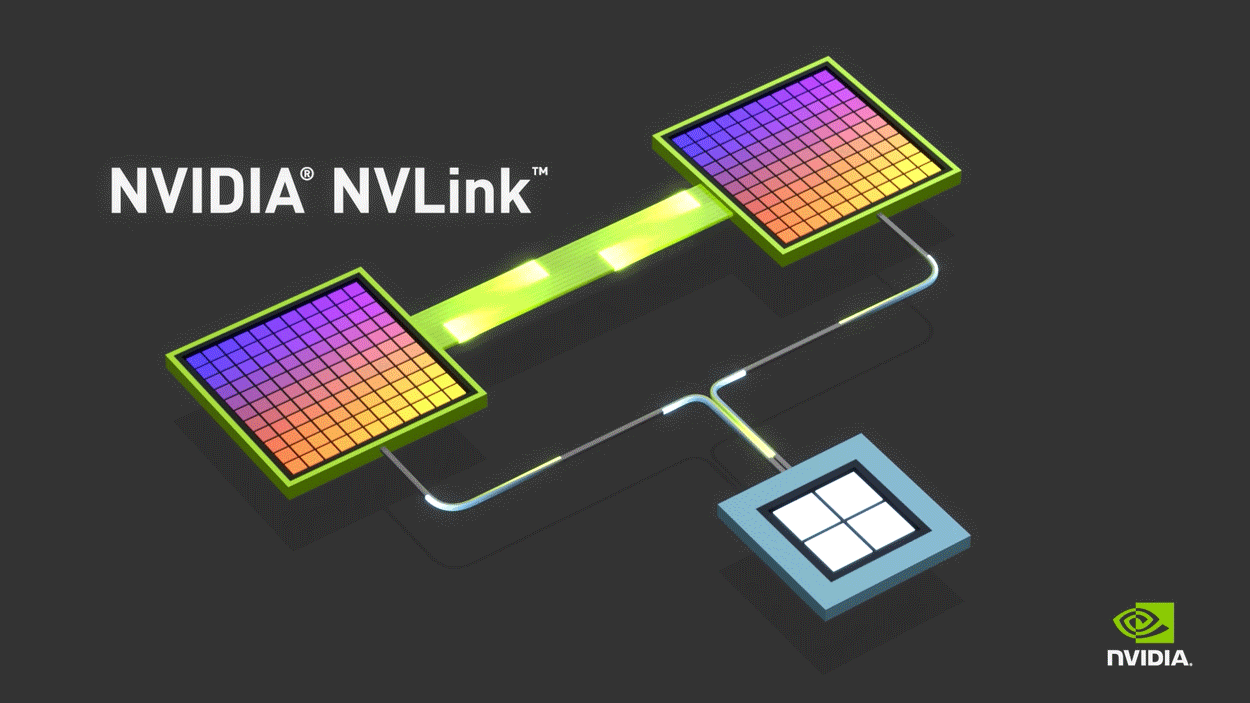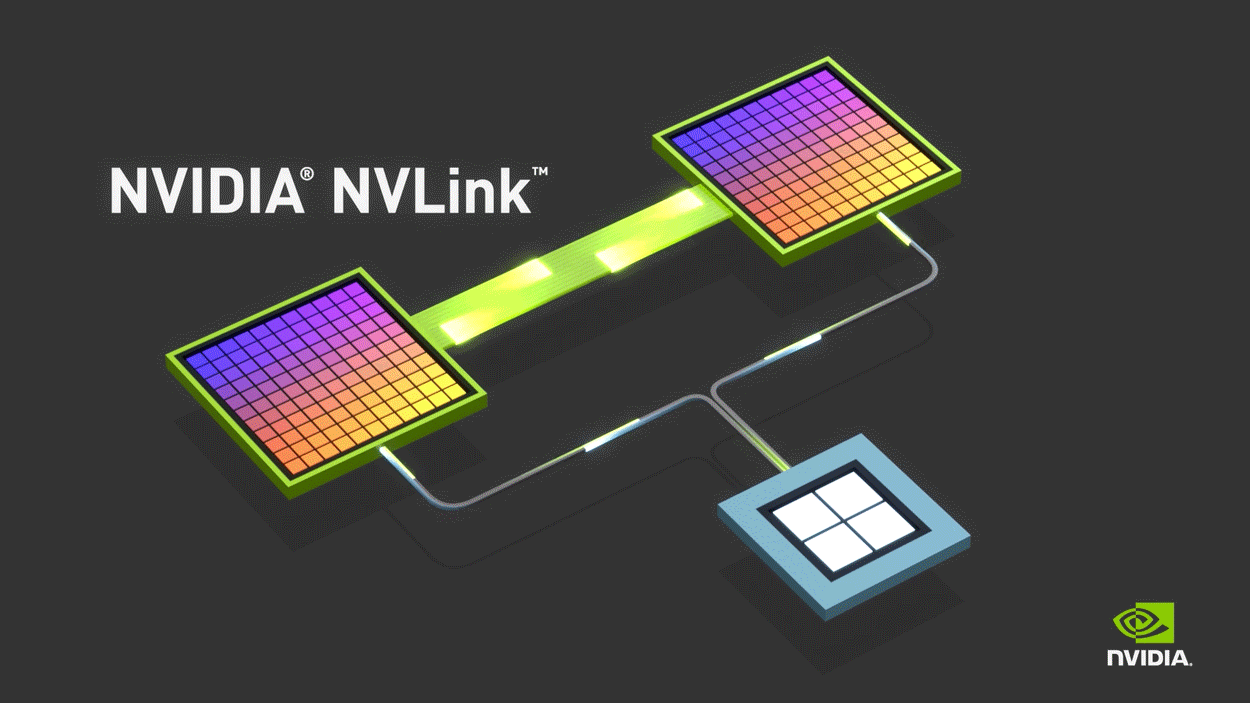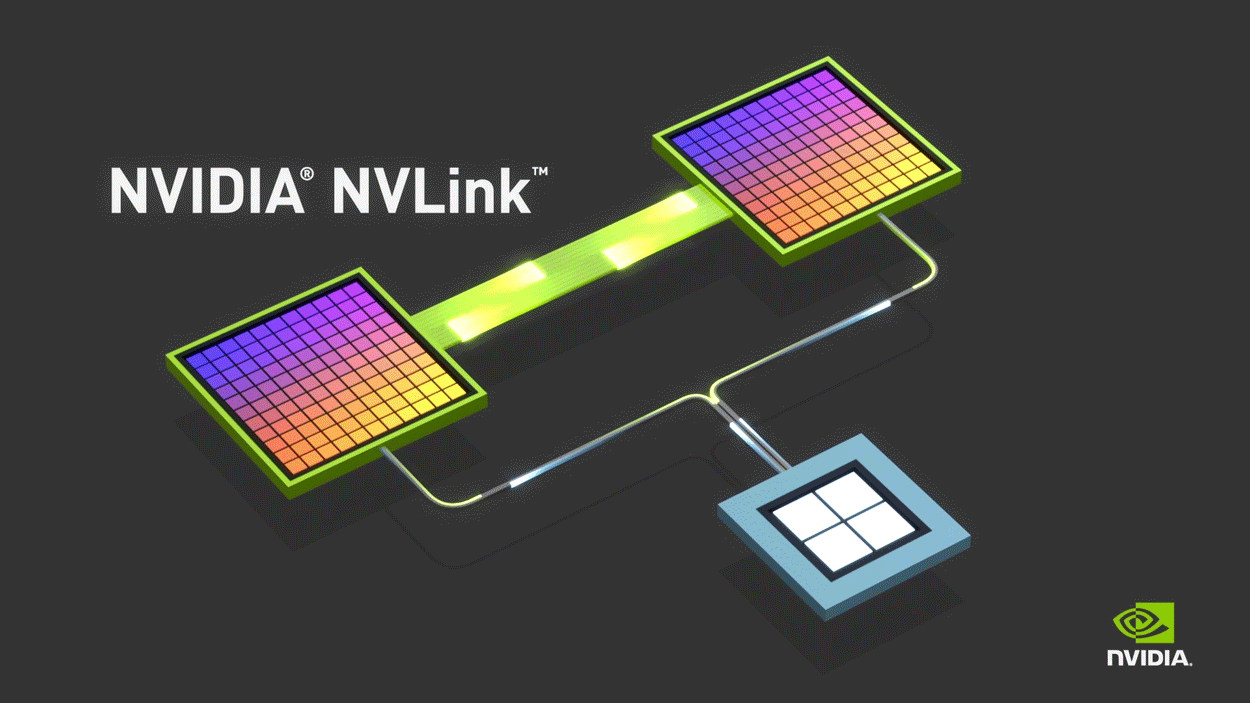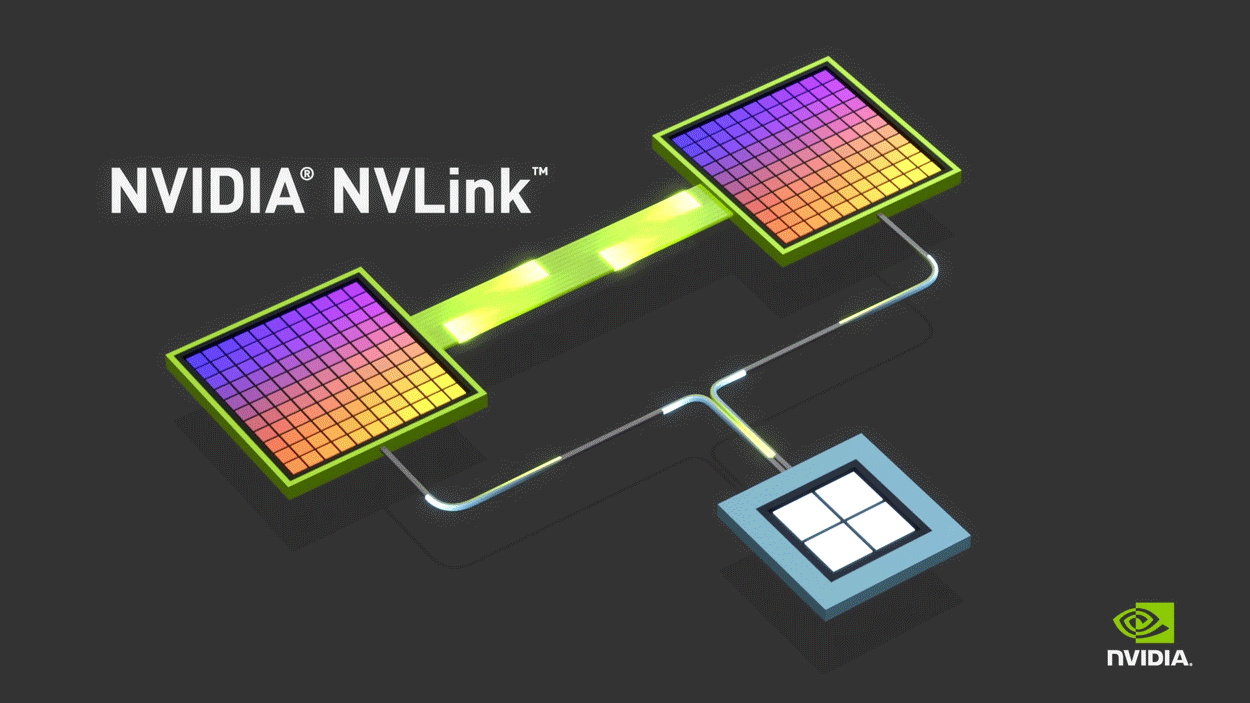
Memory Coherency 才是 NVLink-C2C 的核心價值,CPU 與 GPU 能在 coherent address space / coherent memory system 下直接存取彼此的記憶體,例如把 KV Cache offload 到 CPU memory,而不需要傳統 CPU↔GPU 那麼繁瑣的 Explicit Copy。
因為 NVLink-C2C 是針對緊密 chip-to-chip / die-to-die connectivity 設計,而不是像 PCIe 要兼顧通用 add-in cards、主機板 routing、各種裝置與 backwards compatibility,因此可以更密集、更省電。NVIDIA 最新資料稱,NVLink-C2C 在 NVIDIA 晶片上可做到相較 PCIe Gen6 最高約 6× energy efficiency 及
約 3.5× area efficiency。這對幾千瓦的 AI compute tray 很重要,因為 interconnect PHY 本身已經成為不可忽視的功耗來源,代表省下的互連功耗可以轉化為更多運算功率空間,進而改善整體 TCO 與 AI Factory 的經濟效益。
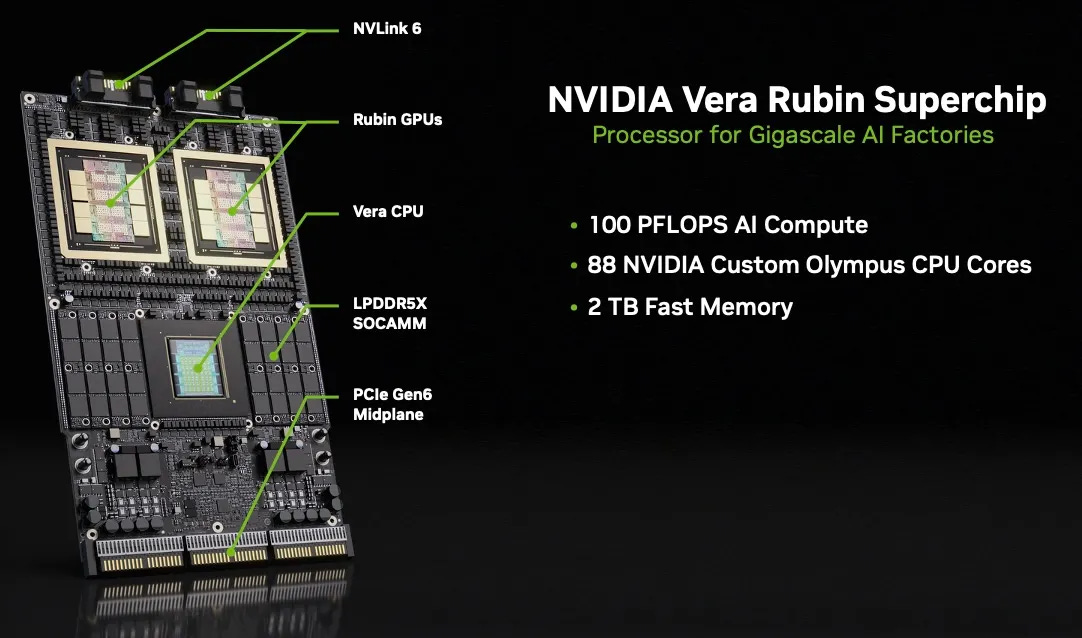
評估 Scale-up 網路架構的三大核心指標
在評估適用於 AI 工廠的 Scale-up 技術時,不能僅流於規格表上的硬體頻寬數字,必須從工廠級視角檢視以下三項指標:
1. 交付效能 (Delivered Performance)
包含全對全頻寬、GPU HBM 到 HBM 的端到端延遲、網路內集體運算(Collectives)能力,以及能優化路由、負載平衡並支持主流 AI 庫的全疊層軟體整合。
2. 工廠韌性 (Factory Resiliency)
在追求高頻寬的同時,必須確保系統能長時間運作、支援持續的健康監測、組件級在線維護(而不中斷整機運行),將交付效能轉化為工廠生命週期內的「實質產能(Goodput)」。
3. 平台成熟度與供應鏈驗證
在超大規模的部署壓力下,使用未經廣泛部署驗證的技術將面臨效能不達標、意外當機與供應鏈中斷等高風險。
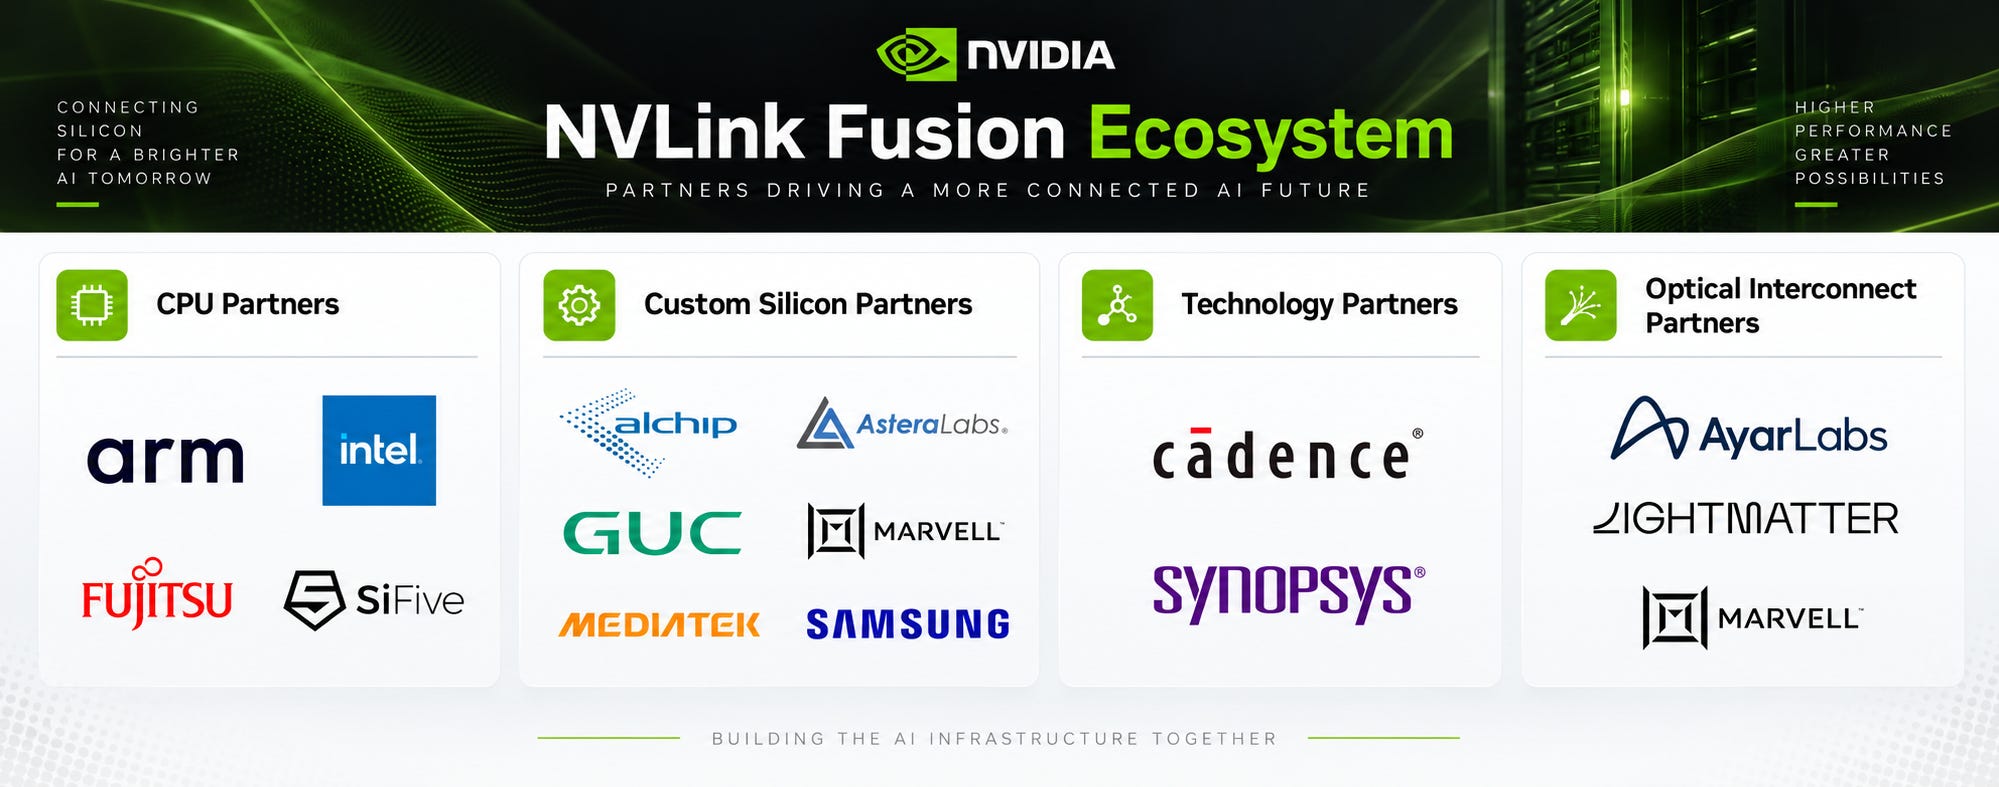
NVLink Fusion(自研晶片互連)
為了解決 Hyperscalers 與 AI Labs 開發客製化晶片(Custom XPUs)時面臨的部署複雜度與供應鏈風險,NVLink Fusion 提供高頻寬、低延遲的互連技術與 IP,讓客製晶片能無縫融入 NVIDIA 成熟的 NVLink Scale-up 網路生態與機架級架構中。這不僅縮短了客製晶片的上市時間、簡化了數據中心營運,還可支援 Custom XPU 與 NVIDIA GPU 組成的異質運算,以及解耦式推論(disaggregated inference)架構。
簡單比喻,就像 Apple 突然開放自己的整套硬體架構,甚至容許客戶把 Apple 自家的處理器換成第三方晶片——是不是很難想像?
NVLink Fusion 讓客戶自研晶片接入 NVIDIA 的核心技術與整合架構
高速擴展網路技術(Scale-up Fabric):提供對 NVLink SerDes、NVLink 小晶片(chiplets)及 NVLink 交換器(Switches)的完整存取能力。
高密度機架級架構(Rack-Scale Architecture):包含 NVLink 骨幹(spine)、銅纜線系統(copper cable system)、機構創新、先進的電源與液冷技術,以及具備高度供應鏈準備度的生態系。
模組化設計:作為模組化 OCP(Open Compute Project)MGX 機架解決方案提供,可靈活整合任何網卡(NIC)、資料處理器(DPU)或向外擴充(Scale-out)交換器,賦予客戶自定義架構的彈性。
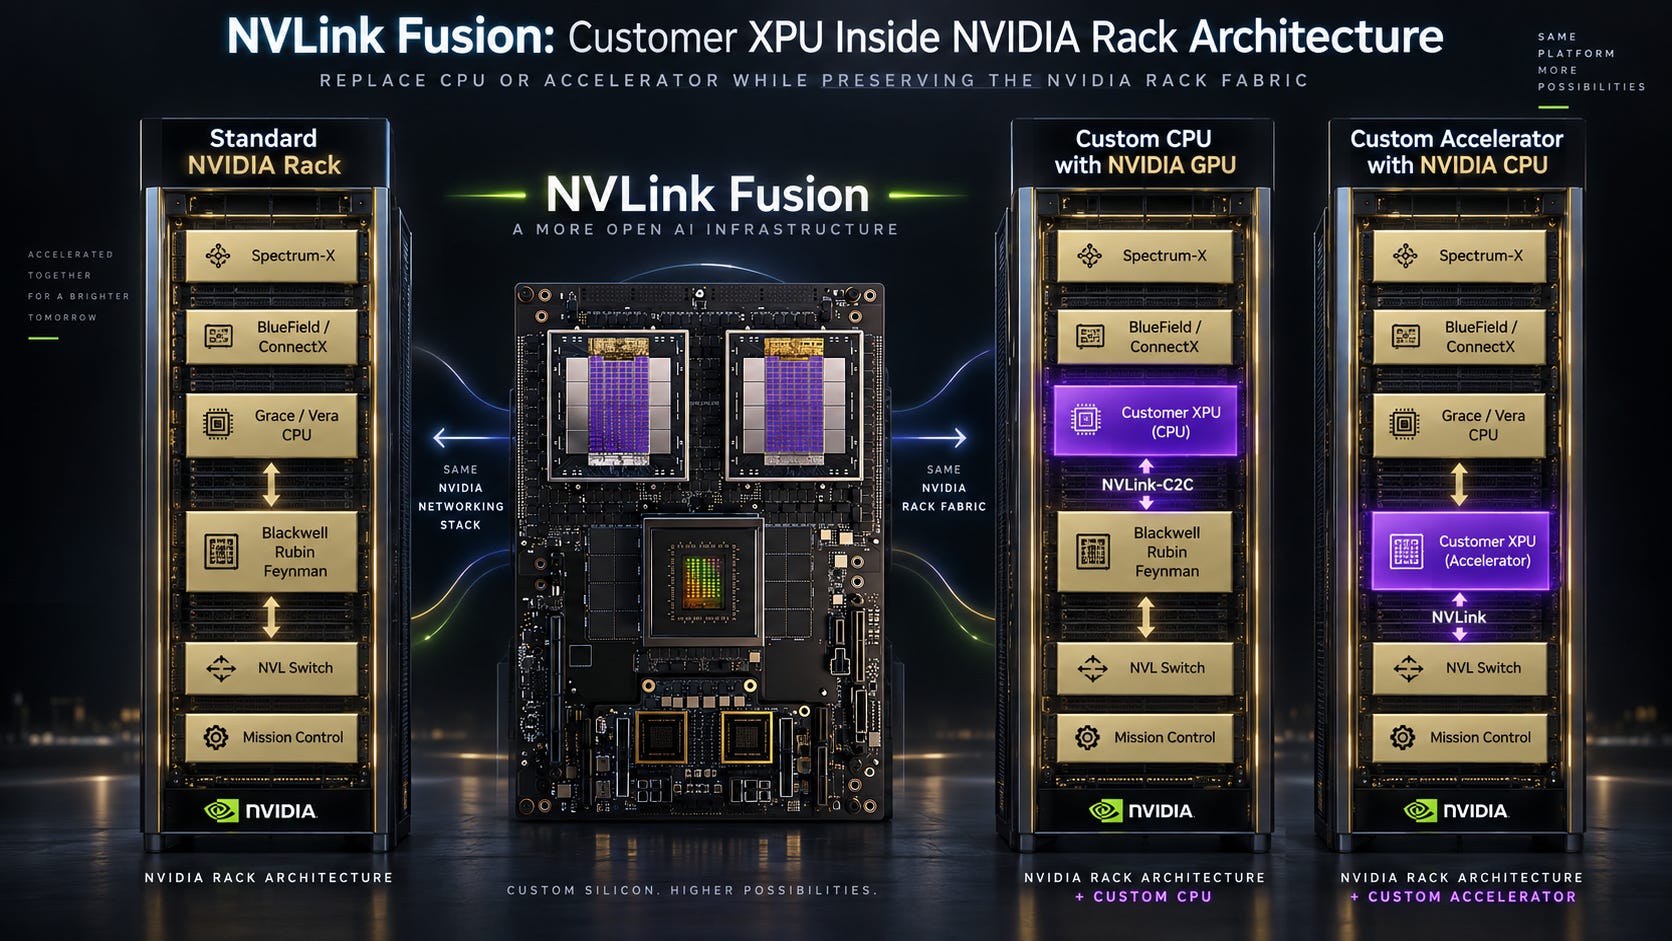
NVLink Fusion 針對不同的自研晶片架構,提供了靈活且高效能的連接解決方案:
自研 XPU(加速器)
利用開放標準 UCIe(Universal Chiplet Interconnect Express) 的 IP 與介面進行整合。NVIDIA 提供 UCIe 轉 NVLink 的橋接小晶片(Bridge Chiplet),降低 XPU 導入 NVLink 的整合門檻,讓採用者取得與 NVIDIA 相同層級的 NVLink 功能存取權。基於 UCIe 的開放性,客戶能靈活保留在未來平台中更換或升級 XPU 的空間。
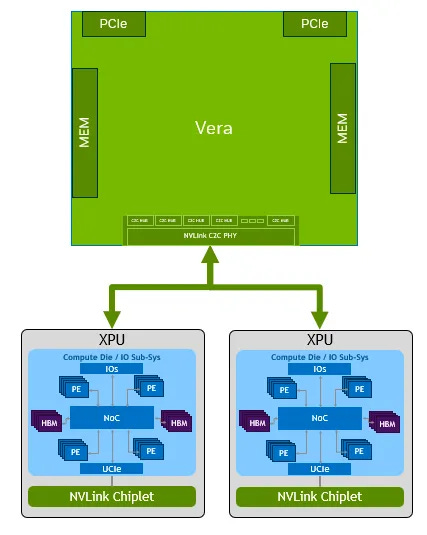
自研 CPU
對於自研 CPU,NVIDIA 建議採用 NVLink-C2C IP 連接 NVIDIA GPU,以取得最佳效能。系統亦可存取 CUDA 平台中數百個 NVIDIA CUDA-X 函式庫,進一步強化加速運算效能。
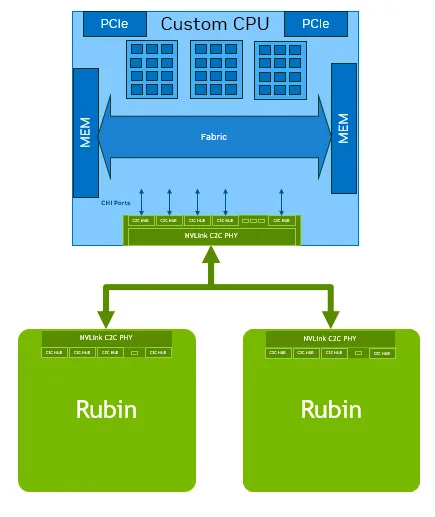
Amazon Web Services (AWS) 案例:
AWS 先前已大規模部署 MGX 機架,藉由 NVLink Fusion,可進一步利用既有的 MGX 機架架構、設計經驗與成熟供應鏈,大幅降低 Trainium4 系統的部署與管理複雜度。結合 NVLink 擴展效能與 NVIDIA MGX 機架,部署其全新的 Trainium4 AI 晶片、Graviton CPU、EFA(Elastic Fabric Adapters)以及 Nitro 虛擬化系統。
加速產品上市時間(Time to Market):直接受惠於已成熟量產 NVIDIA GB200 NVL72 與 GB300 NVL72 系統的合作夥伴網絡與供應鏈,顯著縮短硬體調試(bring-up)與部署時間。憑藉 NVIDIA 十年在 NVLink 擴展技術的深厚累積,NVLink Fusion 能夠有效解決 AI 推理(AI reasoning)時代對極致算力互聯的迫切需求。結合了開放部署的 OCP MGX 架構,在賦予超大規格客製化彈性的同時,也提供了無與倫比的擴展效能。
AWS 是有意思的案例,因為同一家 Hyperscaler 同時可以存在 AWS NeuronSwitch、NVIDIA NVSwitch 和 Broadcom Tomahawk 三種 switch silicon,各自負責不同層級。從 Broadcom 公開披露的 Hyperscalers 採用情況判斷,AWS 可能也是 Tomahawk 的重要 Scale-out 客戶之一,但目前沒有公開資料確認其具體部署規模。至於 Trainium 的 Scale-up 層,目前並非採用 Broadcom Tomahawk Ultra:Trainium3 使用自家的 NeuronSwitch,而 Trainium4 則進一步導入 NVIDIA NVLink Fusion / NVLink Switch。
Broadcom 的 Scale-up 應對方案
Tomahawk Ultra 是 Broadcom 專門拿來攻 NVSwitch / NeuronSwitch 這種 Scale-up 市場:
51.2 Tbps
~ 250 ns switch latency
Scale-Up Ethernet(SUE)/ low-latency Ethernet
rack-scale XPU Scale-up
Broadcom 9 月 2 日最新業績會表示,Tomahawk Ultra 已開始進入 Scale-up deployment,並預計 FY2027 明顯增加。戰略是利用 Tomahawk 6/Ultra 把 Ethernet 從既有的 Scale-out 層逐步往 Scale-up 滲透。
相比 NVIDIA 的 Scale-up 方案,尤其協同性方面,博通的方案感覺較為單一,而當 NVIDIA 先在 8 月 26 日公布 NVHBM 技術方案,再於 8 月 31 日宣布對 MediaTek 的 35 億美元 convertible bonds 投資與擴大合作,兩者的戰略疊加效應開始浮現,在 HBM 供給持續偏緊、先進 HBM 資源日益珍貴的背景下,NVLink Fusion + NVHBM 吸引力大增,如果 NVLink Fusion + NVHBM 成功提高 NVIDIA 在第三方 XPU 平台中的滲透率,NVIDIA 對整體 AI Factory 架構的控制力將進一步提升,長期亦可能增加 Spectrum-X 向 Scale-out 層滲透的機會,從而加大 Broadcom 在 Ethernet Switching 市場面對的競爭壓力。
下一篇 Part 2,將會再詳細分析及拆解 NVHBM 對博通帶來的衝擊,在 Custom XPU 市場,Broadcom 面對 Marvell、MediaTek 等競爭者;在高速互連與 CPO 領域,競爭版圖亦快速擴大,這亦是目前市場重新評估 Broadcom AI 業務競爭優勢時值得留意的風險之一。 (-完-)
每篇深度分析都花了大量時間閱讀及研究,如果這篇內容對你有幫助,歡迎 Like、Share、Comment、Restack,也別忘了推薦給朋友免費訂閱。你的支持,是我持續寫作最重要的動力
NVLink Fusion is the move that reframes the whole Broadcom question. Opening the interconnect to third-party XPUs, Marvell and MediaTek and even Trainium on the diagram, means Nvidia stops fighting to be the only accelerator and starts collecting a toll on everyone else's. The fabric becomes the moat rather than the chip.
Which is precisely where it pressures a custom-silicon story. Broadcom's pitch is that hyperscalers route around Nvidia with their own ASICs, but if those ASICs plug into Nvidia's fabric to scale, the escape hatch leads back through the tollbooth.