
前言:半導體Optics 光學之範圍又深又廣,除Package Level (CPO、Optic I/O) 及 Pluggable Optic 外更有Rack Level Optic, 由於業界標準未真正定案,加上媒體報導及分析比較碎片化,讀者會很容易把不同架構及方案混亂,花了不少時間整理,才找到一個比較清晰的分析方向。
本篇內容將基於台積電COUPE 平台及Ayar Labs 產品為主軸,以其標準及準確的定議來解讀目前市場上被熱議的「CPO」及「雷射光源」及一些相關的謎思,亦用來驗證下Serenity 力推Laser 光源股 $SIVE 的真正實力。
當初開始研究Ayar Labs 的時間,一直默認了光源一定是他自己做的,完全忽略了$SIVE 的存在,也很佩服Serenity 可以精準地找出半導體的關鍵 Choke Points,更利害的是可以一直抱著不沽。這篇初步研究及驗證$SIVE 的文章,也算是向他致敬。
「光進銅退」是一條被 AI scaling law 強迫推進的基礎設施演化路線
當 GPU 數量、模型參數與集群規模持續爆炸後,傳統 electrical interconnect 已逐漸成為 AI scaling 的主要瓶頸。因此,整個產業開始把「光」從原本只是 datacenter networking 的角色,逐步提升為 AI compute fabric 的核心。這條路線並不是直接從 Pluggable Optics 跳到 Optical I/O,而是經歷數個清晰的中間階段。
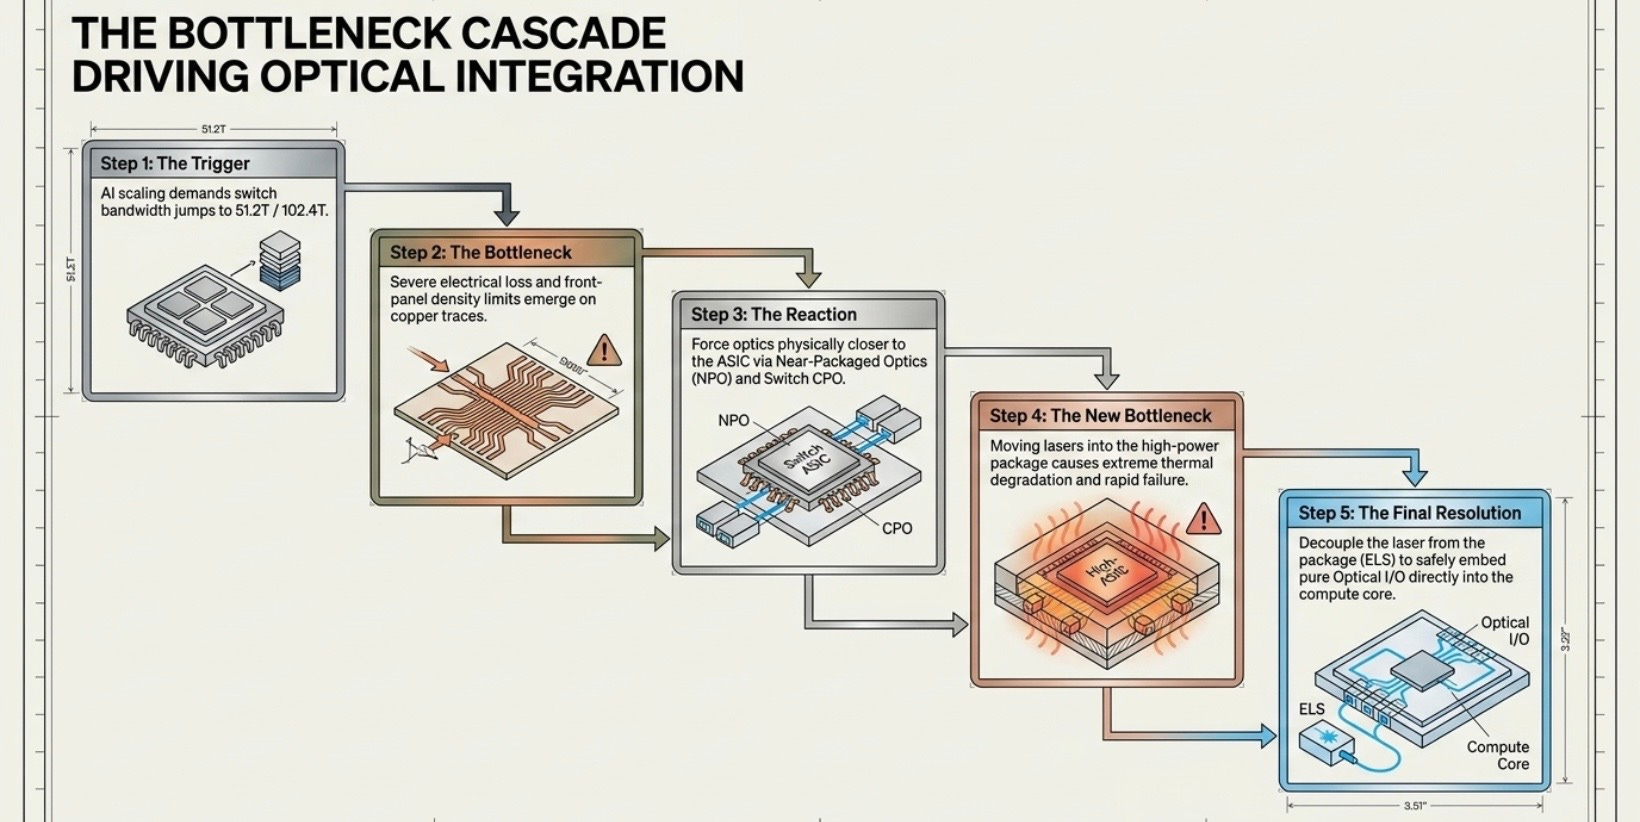
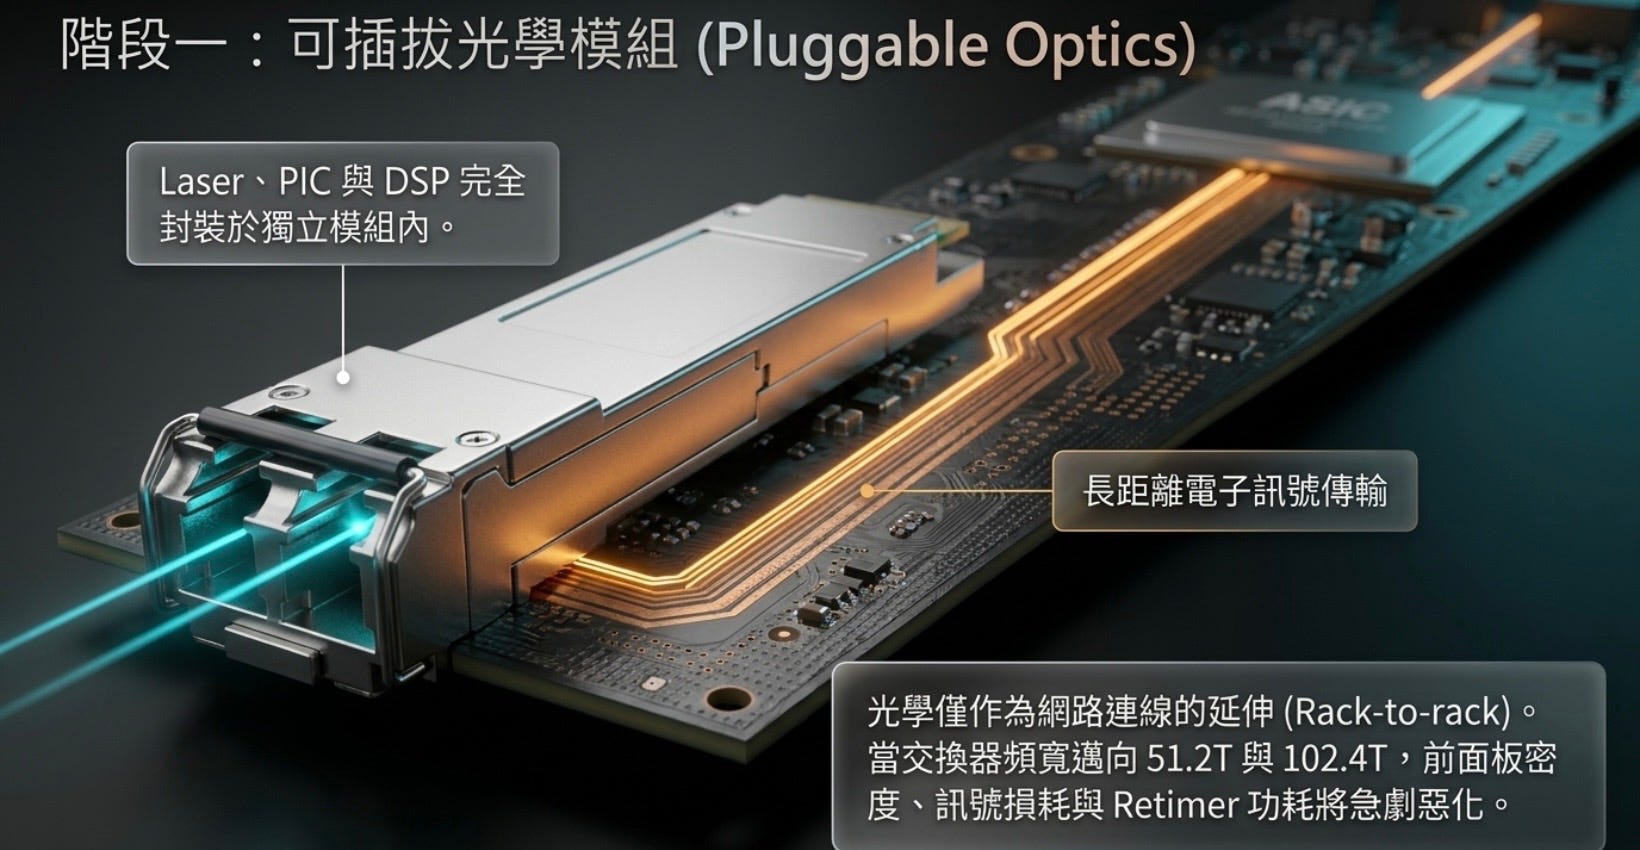
最早的階段,是傳統的 Pluggable Optics 時代。這也是目前仍佔主流的資料中心架構。光學模組仍是獨立可插拔元件,透過 QSFP、OSFP 等模組與 Switch ASIC 連接。此時 Optics 的角色仍非常傳統:它只是 Network Connectivity 的延伸,用來處理 Rack-to-Rack、Switch-to-Switch 的高速傳輸。Laser、PIC、DSP 都位於 module 內部,與 ASIC 完全分離。這個架構最大的優勢是維修性與生態成熟,但缺點也開始浮現:當 Switch Bandwidth 從 25.6T 推進到 51.2T、102.4T 後,Front-Panel Density、Electrical loss 與 Retimer power 開始急劇惡化。
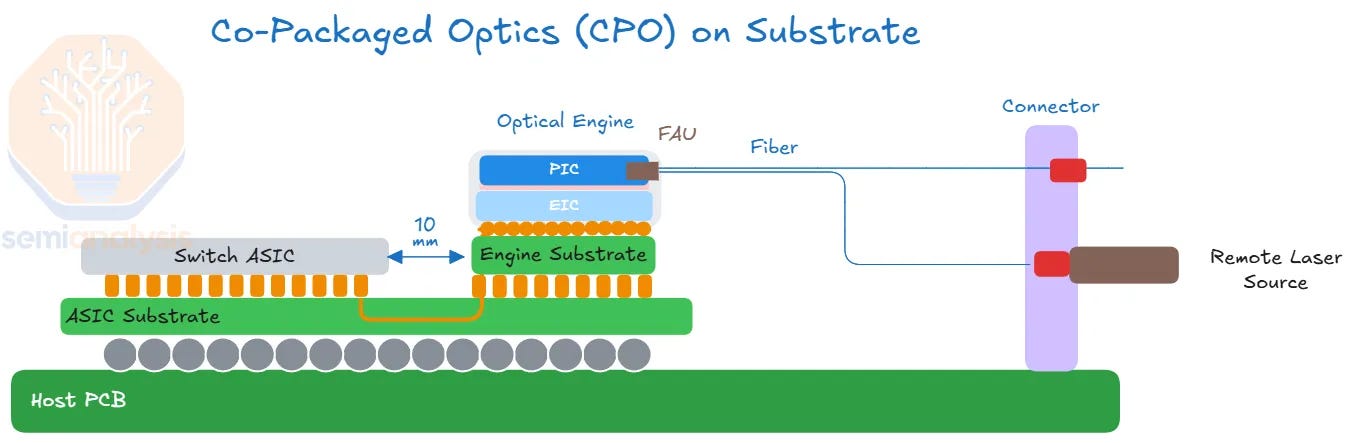
接下來便是真正的 Switch CPO(Co-Packaged Optics)時代。這也是目前 Broadcom 與 NVIDIA 正在大力推進的方向。此時 Optics 不再只是靠近 Switch,而是真正進入 Package。PIC、EIC 與 Switch ASIC 被共同整合在同一封裝系統內,目的是把 Electrical Path 壓縮到極短距離,以支撐 224G 甚至未來更高速的 I/O。這個階段的核心問題仍是 Network Scaling,也就是如何讓 Switch Bandwidth 繼續擴張。
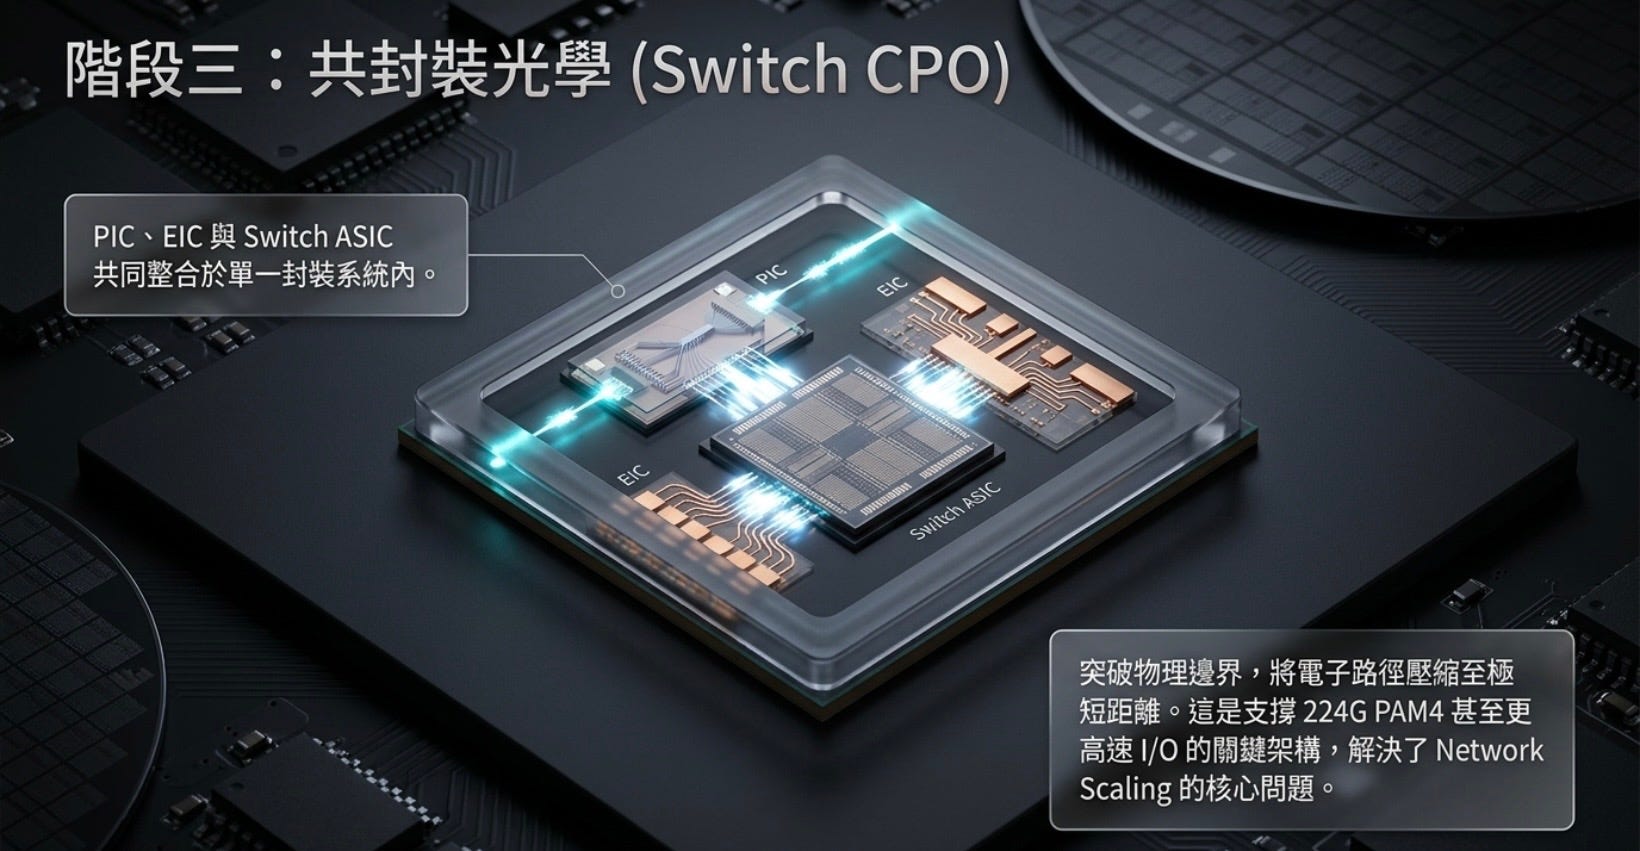
然而,當 Optics 開始大量進入 Package 後,新的問題也隨之浮現:Laser 成為新的瓶頸。因為 AI switch ASIC 功耗可能高達數千瓦,laser 若放在 package 附近,會面臨嚴重 thermal degradation、壽命與維修問題。因此,產業開始進入第四階段:ELS(External Laser Source)。
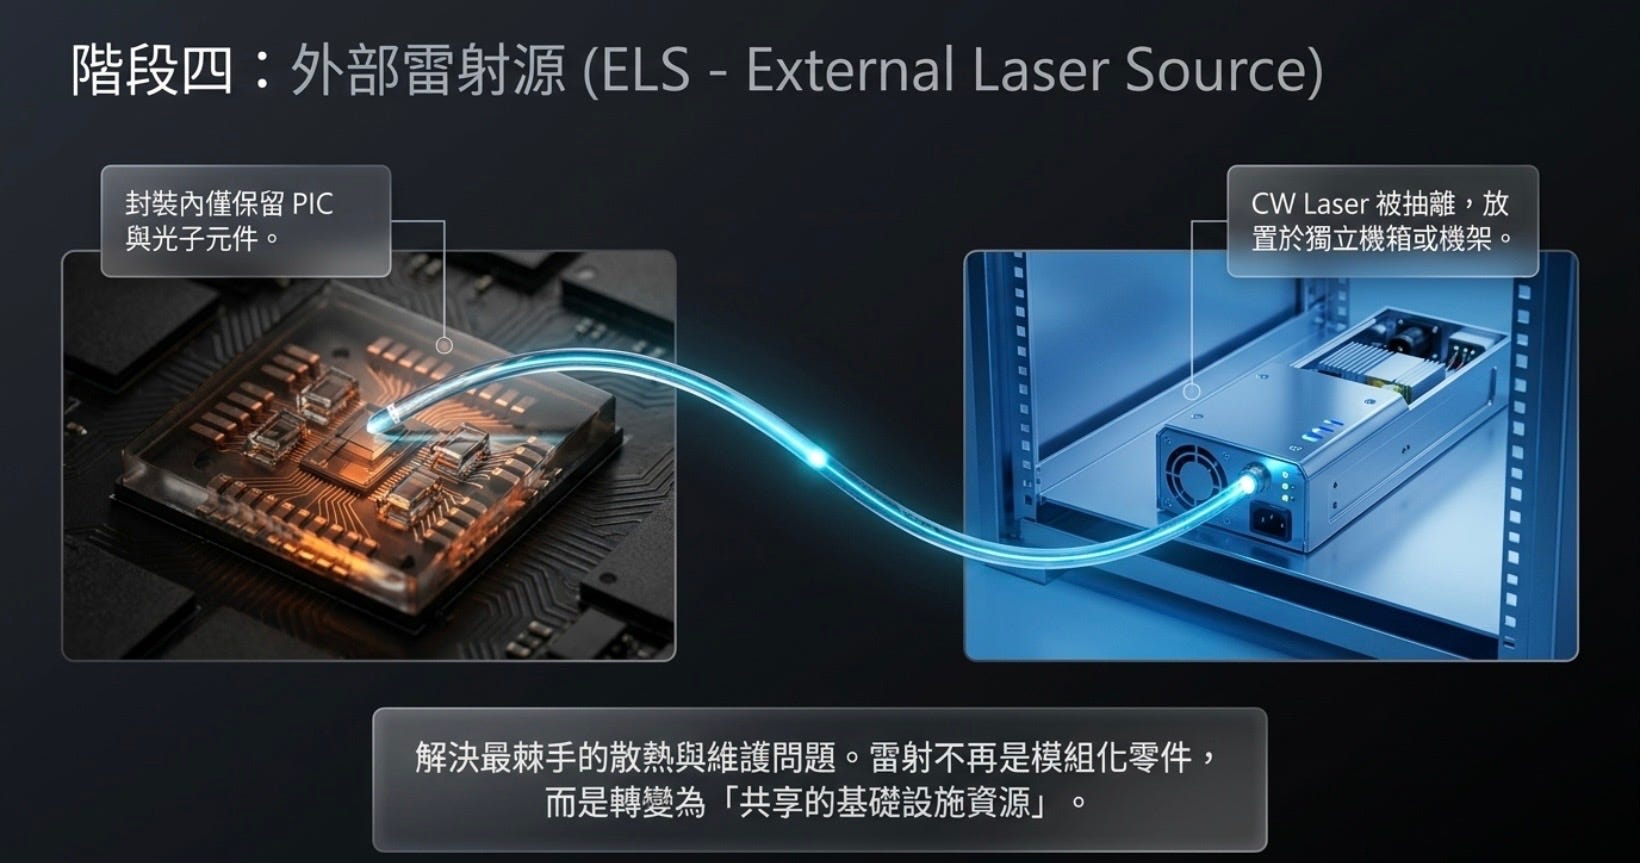
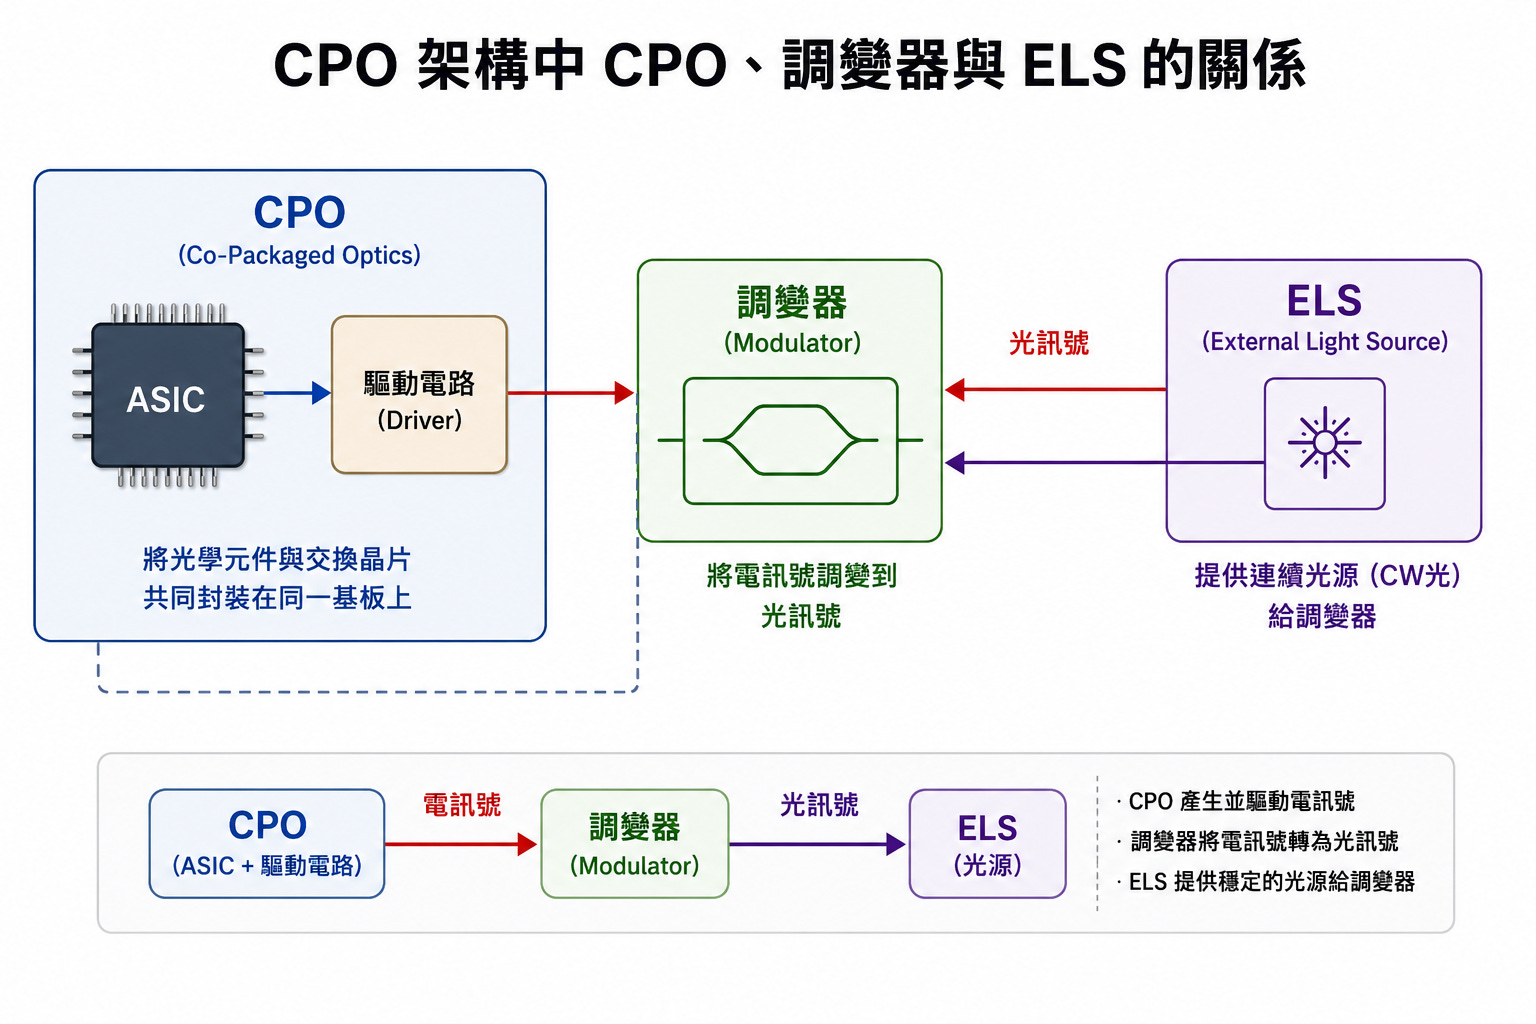
ELS 的核心概念,是把 Laser 從 Package 中抽離。Package 上只保留 PIC、Modulator、Detector 等光子元件,而真正發光的 CW laser 被集中放置於 Rack-Level 的獨立模組中。這代表 Laser 不再是 module component,而是 Shared infrastructure Resource。NVIDIA 現在的 Photonics Switch 架構,就是最典型的 CPO + ELS 路線。這一步非常關鍵,因為它解決了 AI Optical Scaling 中最難的 Thermal 與 Serviceability 問題。
當 Switch Optics 成熟後,下一步才是真正的 Optical I/O 時代。這也是目前 Ayar Labs、Intel 與 NVIDIA 長期 Roadmap 的核心方向。與 Switch CPO 不同,Optical I/O 已不再只是 Networking 問題,而是 Compute Architecture 問題。此時 Optics 開始進入 GPU/XPU package,目的是解決 GPU-to-GPU Bandwidth、Memory Wall、Rack-Scale Compute 的限制。
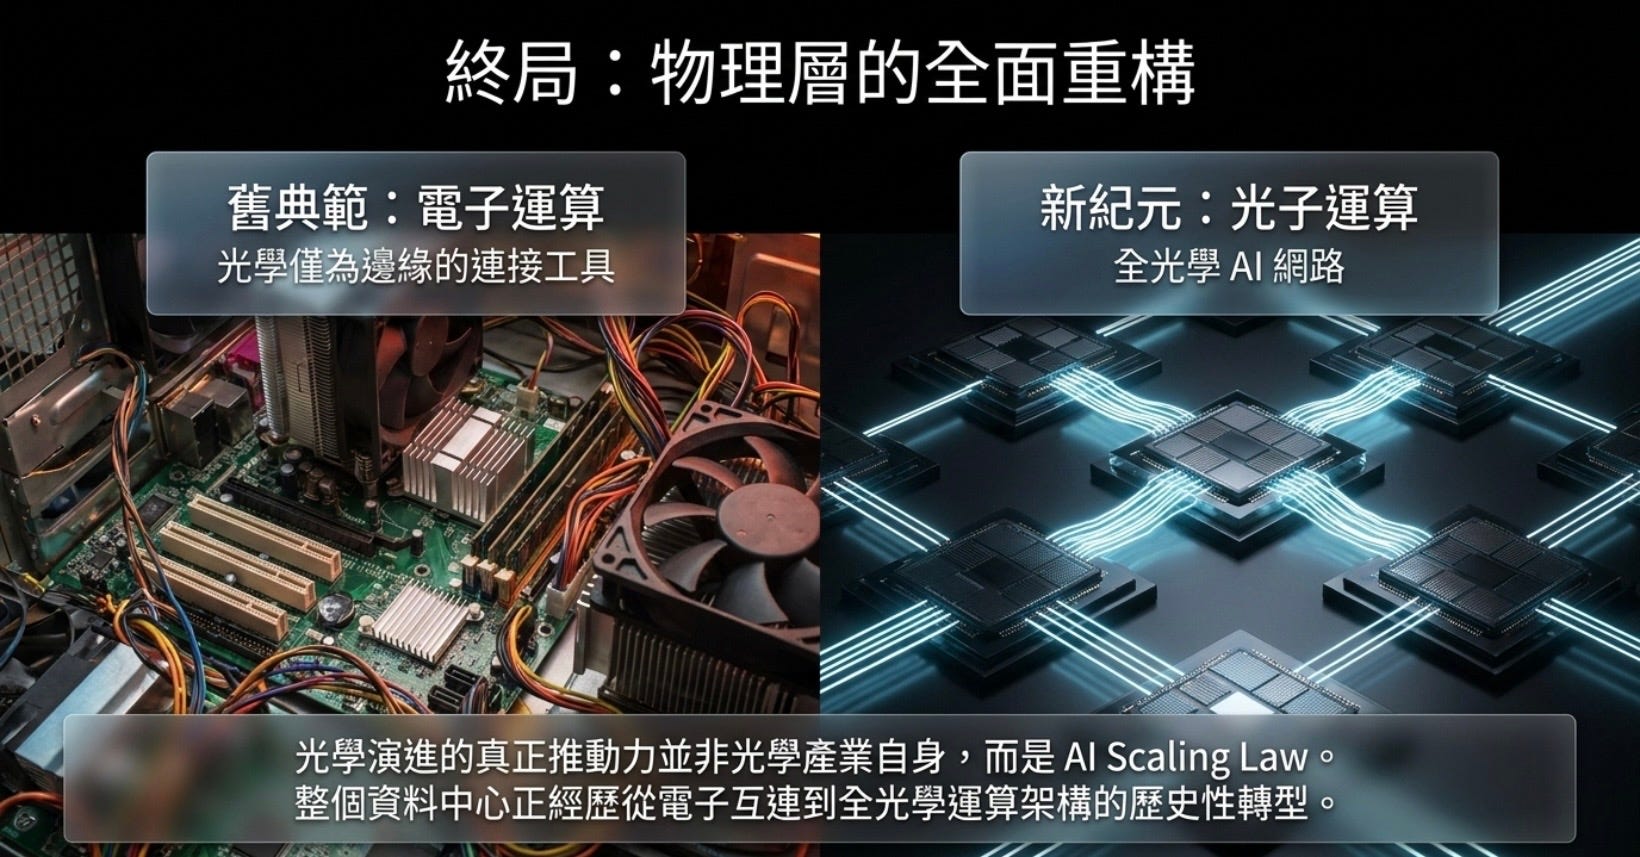
這代表光不再只是資料中心「連接技術」,而是 AI Compute Fabric 本身的一部分。GPU 之間、GPU 與 Memory Pool 之間、甚至 Rack-Level Scale-up Fabric,都可能進入 Optical Domain。這一步的難度遠高於 Switch CPO,因為 GPU Package 本身已包含 HBM、超高功耗與極高 Thermal Density,因此需要更先進的 Photonics Integration 與 Packaging 技術,例如 TSMC 的 COUPE 平台。
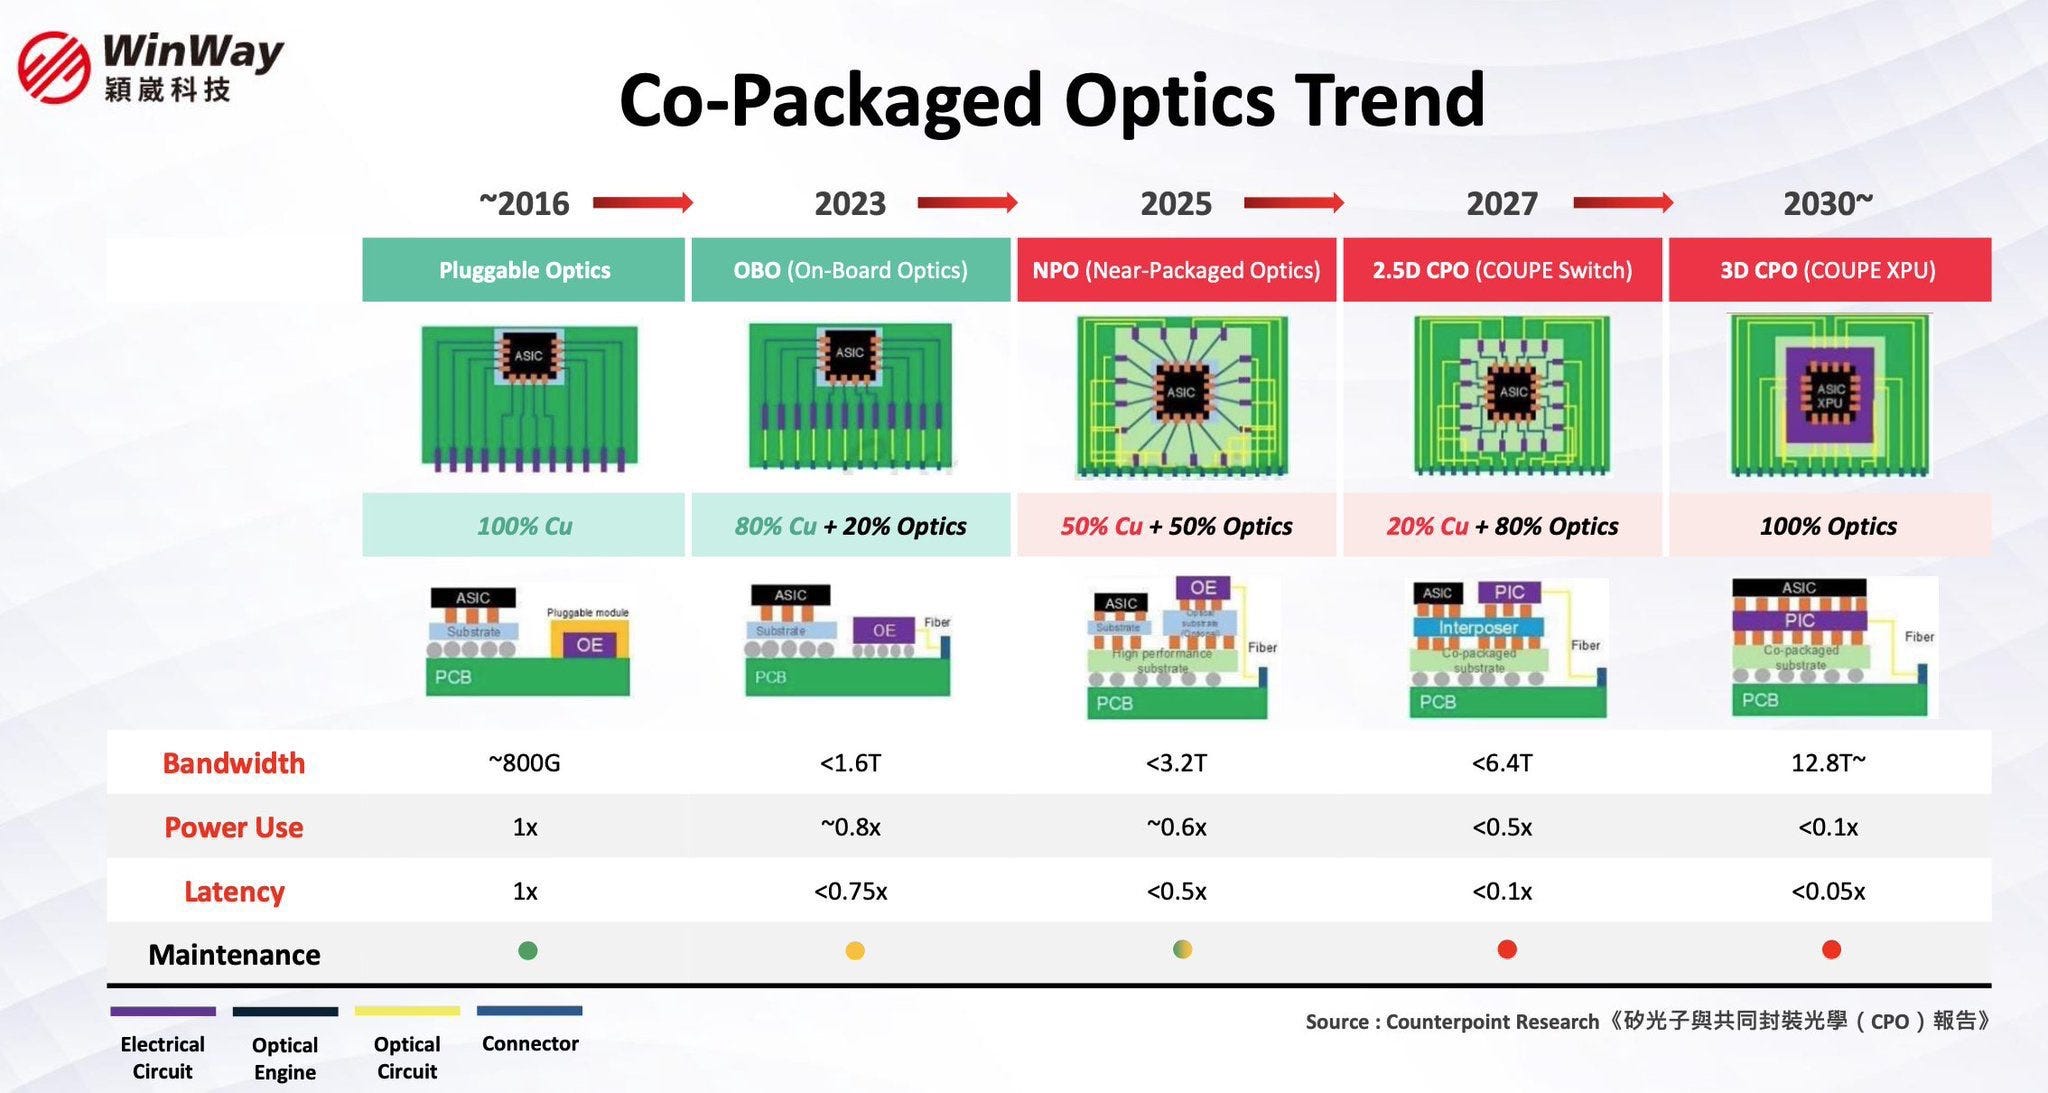
從 Pluggable Optics 到 Optical I/O 的演進,本質上是一條「光逐步逼近 GPU」的路線圖。Switch CPO 是在Scale Network,而真正的Optic I/O 是在Scale Compute。
台積電於5月14日在新竹的 Taiwan Technology Symposium舉辦技術論壇上,台積電業務開發資深副總經理暨副共同營運長張曉強表示:「談到運算,離不開電子;但談到訊號傳輸,離不開光子。」在AI資料中心裡,不只單顆晶片要算得快,晶片與晶片之間也必須以高頻寬、低延遲的方式連接。當資料量持續放大,用光訊號取代部分電訊號傳輸,就成為解決未來資料中心瓶頸的重要方向。
他特別強調:「大家要記住一個詞,叫COUPE (Compact Universal Photonic Engine),緊湊型通用光子引擎。」這是台積電提出的光子引擎技術,透過3DIC技術,將PIC(光子積體電路)與EIC(電子積體電路)垂直封裝在更靠近邏輯晶片的位置,目標是縮短訊號傳輸距離,提升晶片與晶片之間的資料傳輸效率。
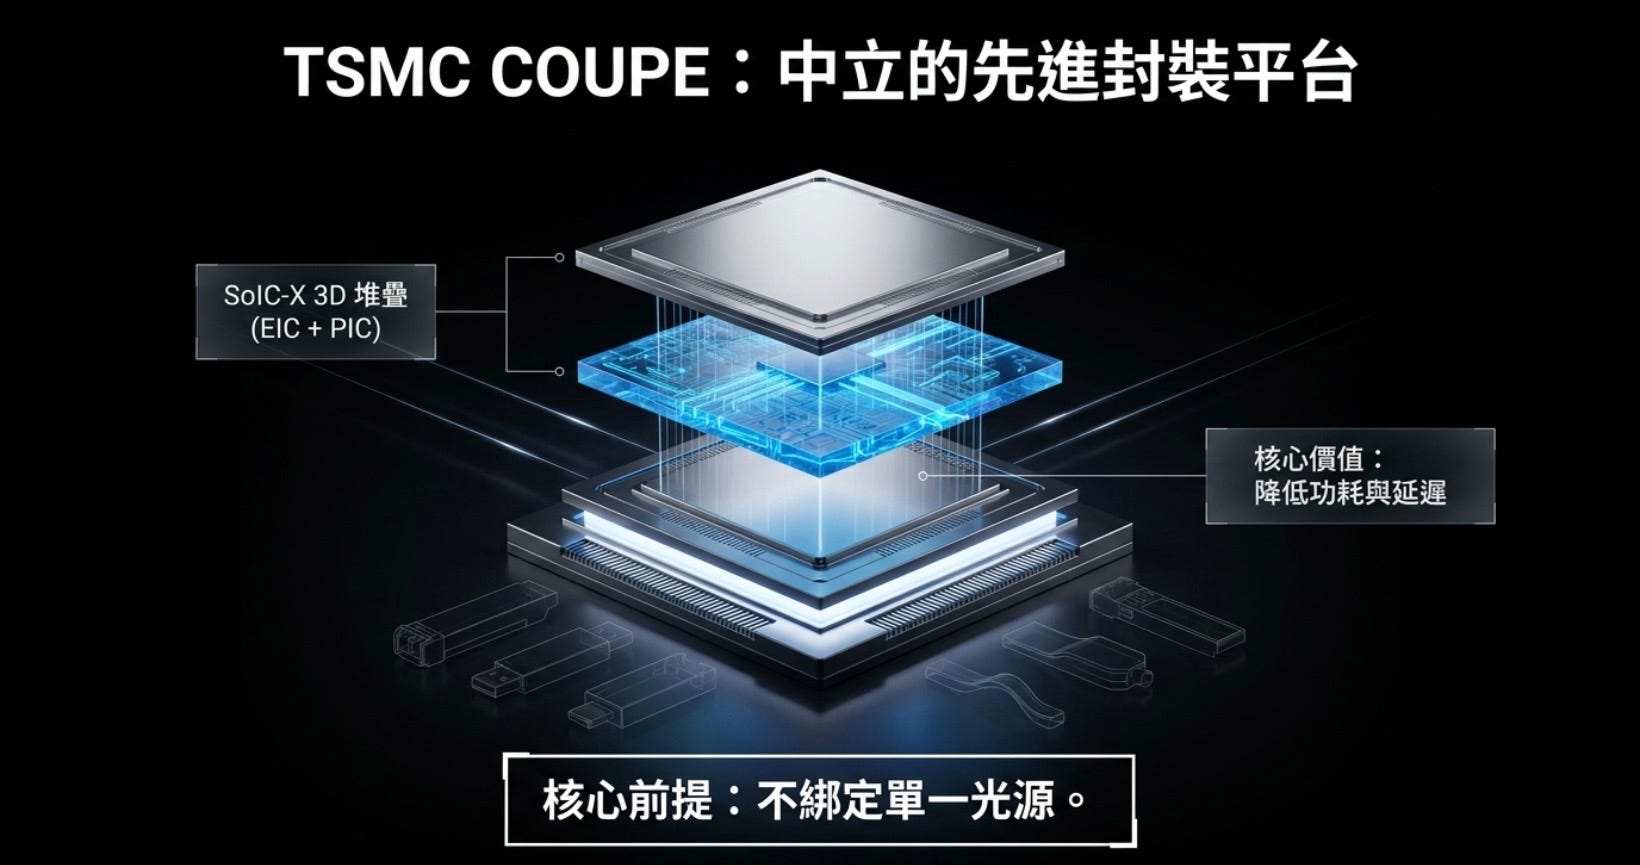
COUPE 採用台積電的 3D 晶片堆疊技術(如 SoIC),將負責電子訊號處理的 EIC(電子積體電路)與負責光學傳輸的 PIC(光子積體電路)垂直緊密堆疊在一起。它將不同功能的晶粒(Die)整合在同一個架構下運作,這本身就是一個高度複雜的系統平台。
連接運算與光通訊的「統一標準」
傳統晶片間傳輸依賴銅線,面對龐大的 AI 算力容易產生延遲與高耗能。COUPE 則是將「光引擎」模組標準化,無論客戶是哪家科技巨頭,都可以利用這個通用平台來進行光電轉換,實現極高速、超低能耗的資料傳輸。
可疊加於其他先進封裝之上
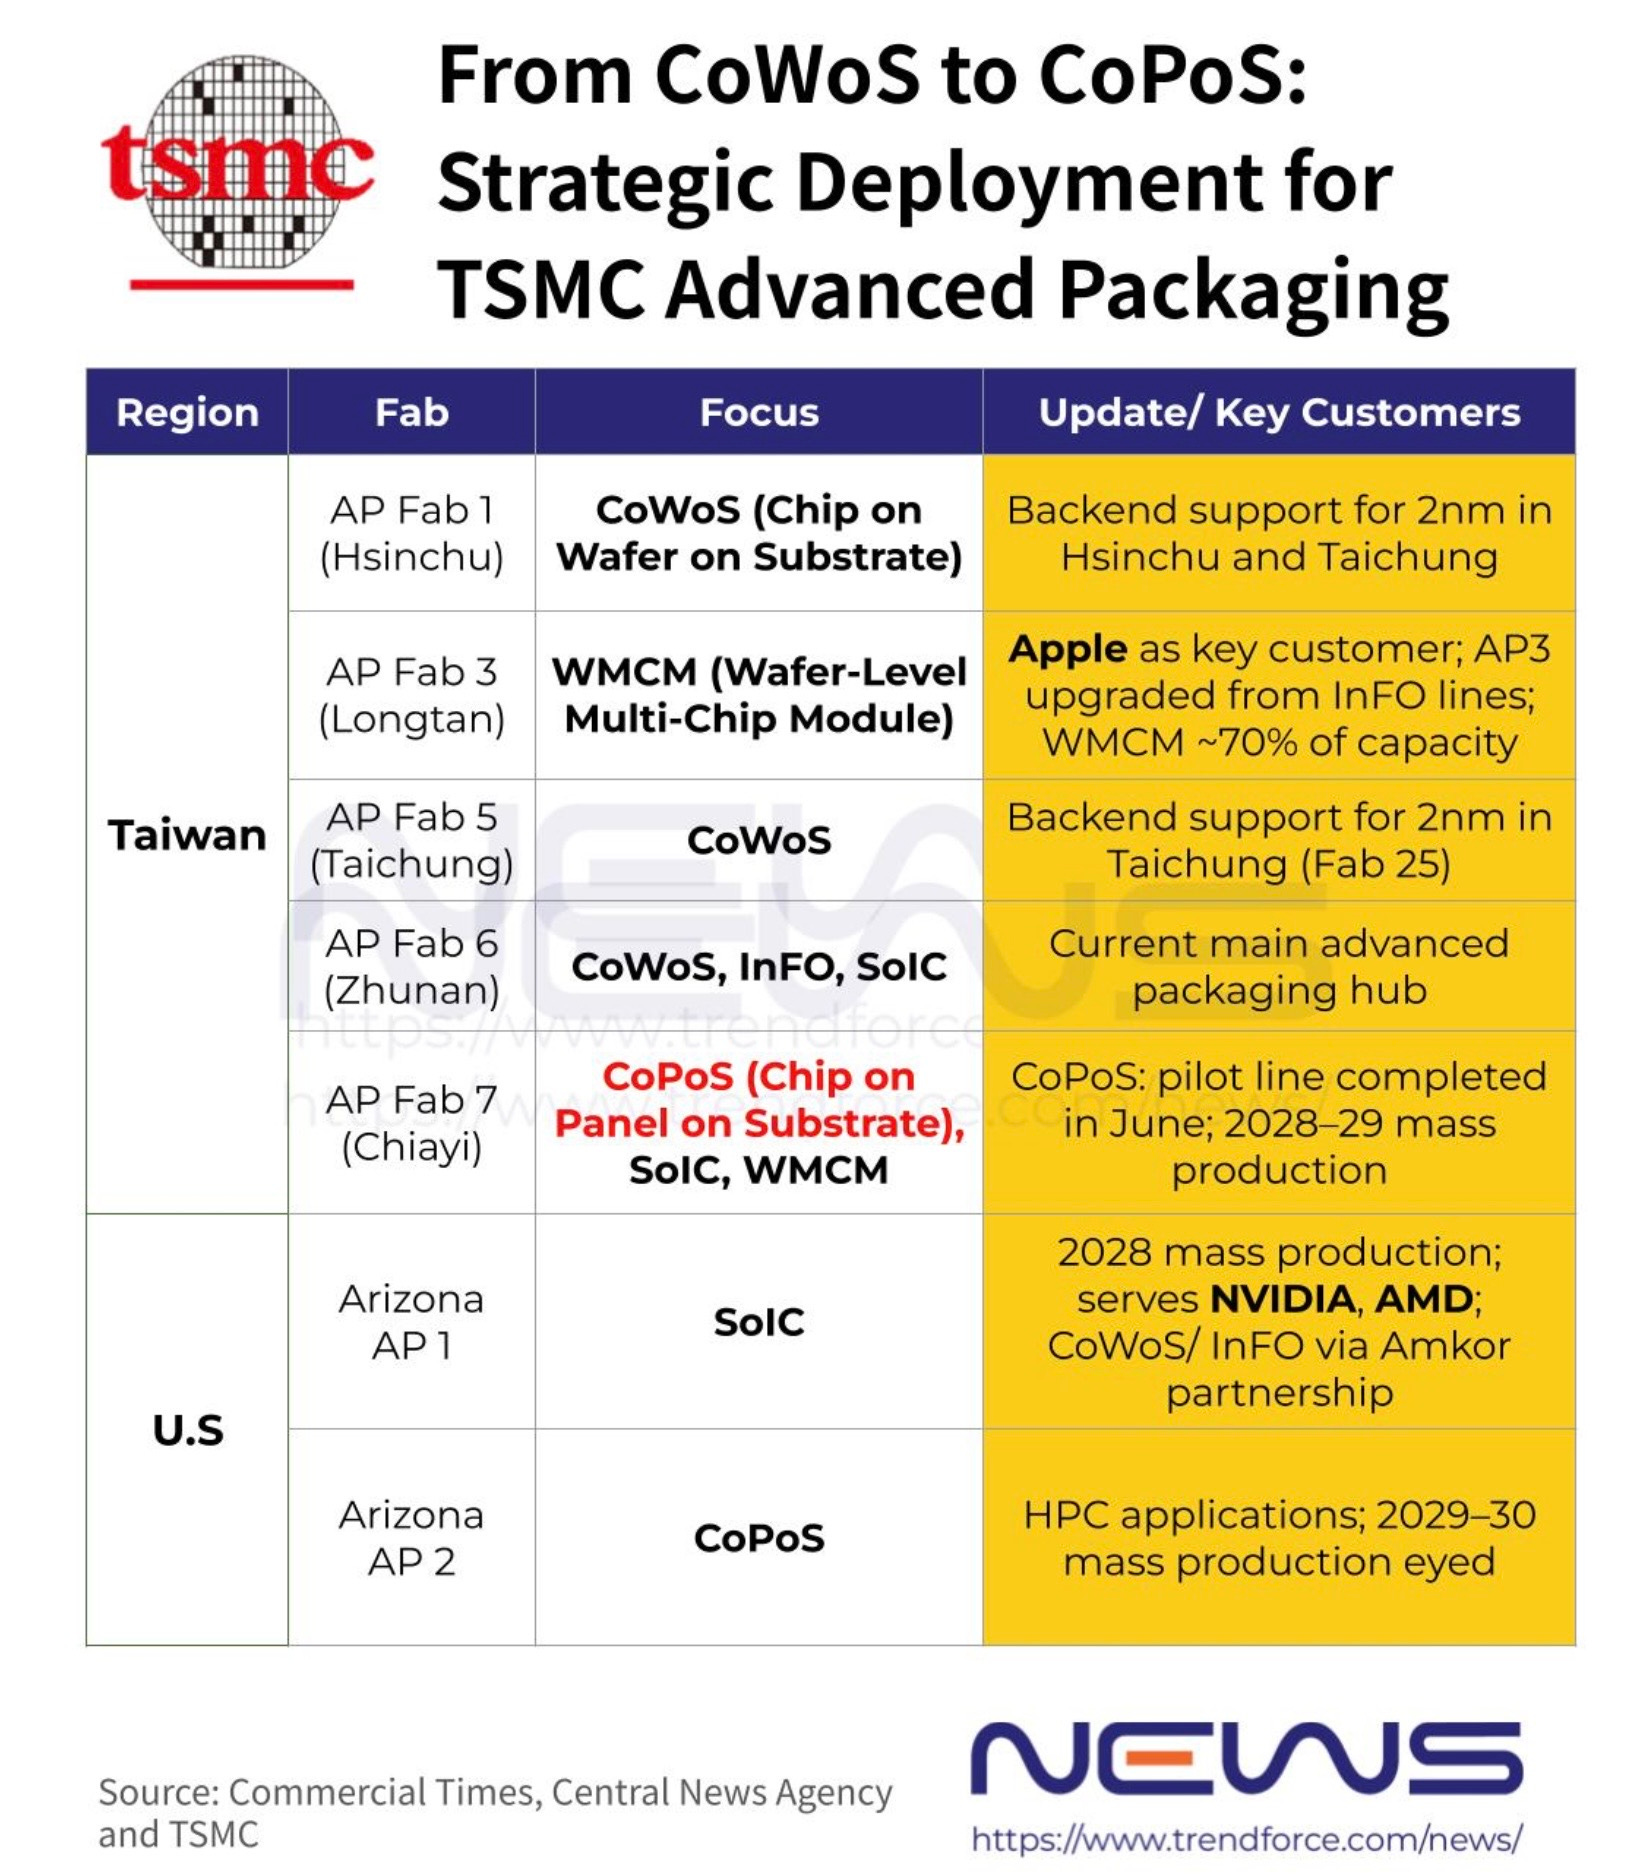
COUPE 不會取代台積電原有的 CoWoS 封裝技術。相反地,它是與 CoWoS 完美搭配的解決方案:
CoWoS 負責把 AI 運算晶片(GPU)與記憶體(HBM)擺在同一個平面上。
COUPE 則是疊加在這些基礎上,為晶片提供光學傳輸的能力。
因為它提供了一個標準化的基礎架構,讓各種光電元件與運算晶片能夠在這個平台上運作並發揮極致效能。COUPE 跟後段先進封裝配合密不可分,範圍太大,下一篇再分開寫。
值得一提的是TSMC 宣告 COUPE 是「全球第一個 200Gbps microring 調變器」的 CPO 解決方案,並把量產年份釘在 2026。關於調變器,又是另一個分支技術,為免混亂先不深入探討。簡單的解釋就是Co-Package 封裝EIP、PIC 時候是不帶雷射光源。(是的,跟早期說法及博通的方案有別),調變器的作用就是以外部光源與Die 之間的訊號轉換橋樑。
CPO 規格戰其實有兩條路: Mach-Zehnder 調變器(大廠主流、訊號完整度好但占面積)與 microring 調變器(小、省電,但溫漂控制難)。NVIDIA Spectrum-X Photonics 用的是 Mach-Zehnder 派系,Broadcom 第三代 200G/lane CPO 平台這週也加入戰局,兩家都靠 Mach-Zehnder 站穩第一階段。
TSMC 押 microring 是另一場賭注。200Gbps/lane 用 microring 跑通,等於是「每光纖頻寬翻倍、每 GPU 光連接數減半」的設計自由度——這對 scale-up domain 從 72 GPU 擴到 144、288 GPU 的 Rubin Ultra 時代,是直接的封裝面積解放。
這個選擇也與後續要寫的Ayar Labs TereaPHY 及 SuperNova 方案有關,更與SIVE 的技術主導有直接關係。
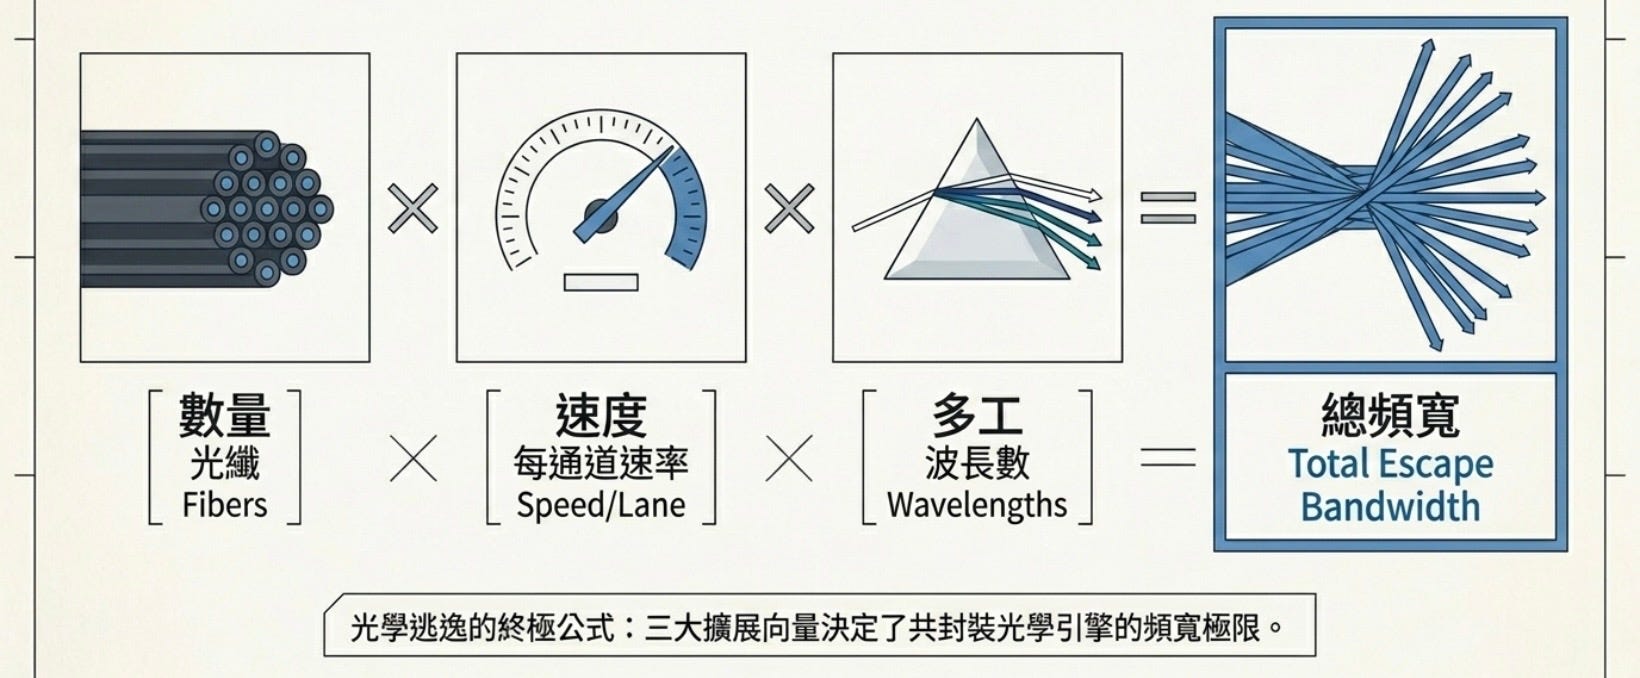
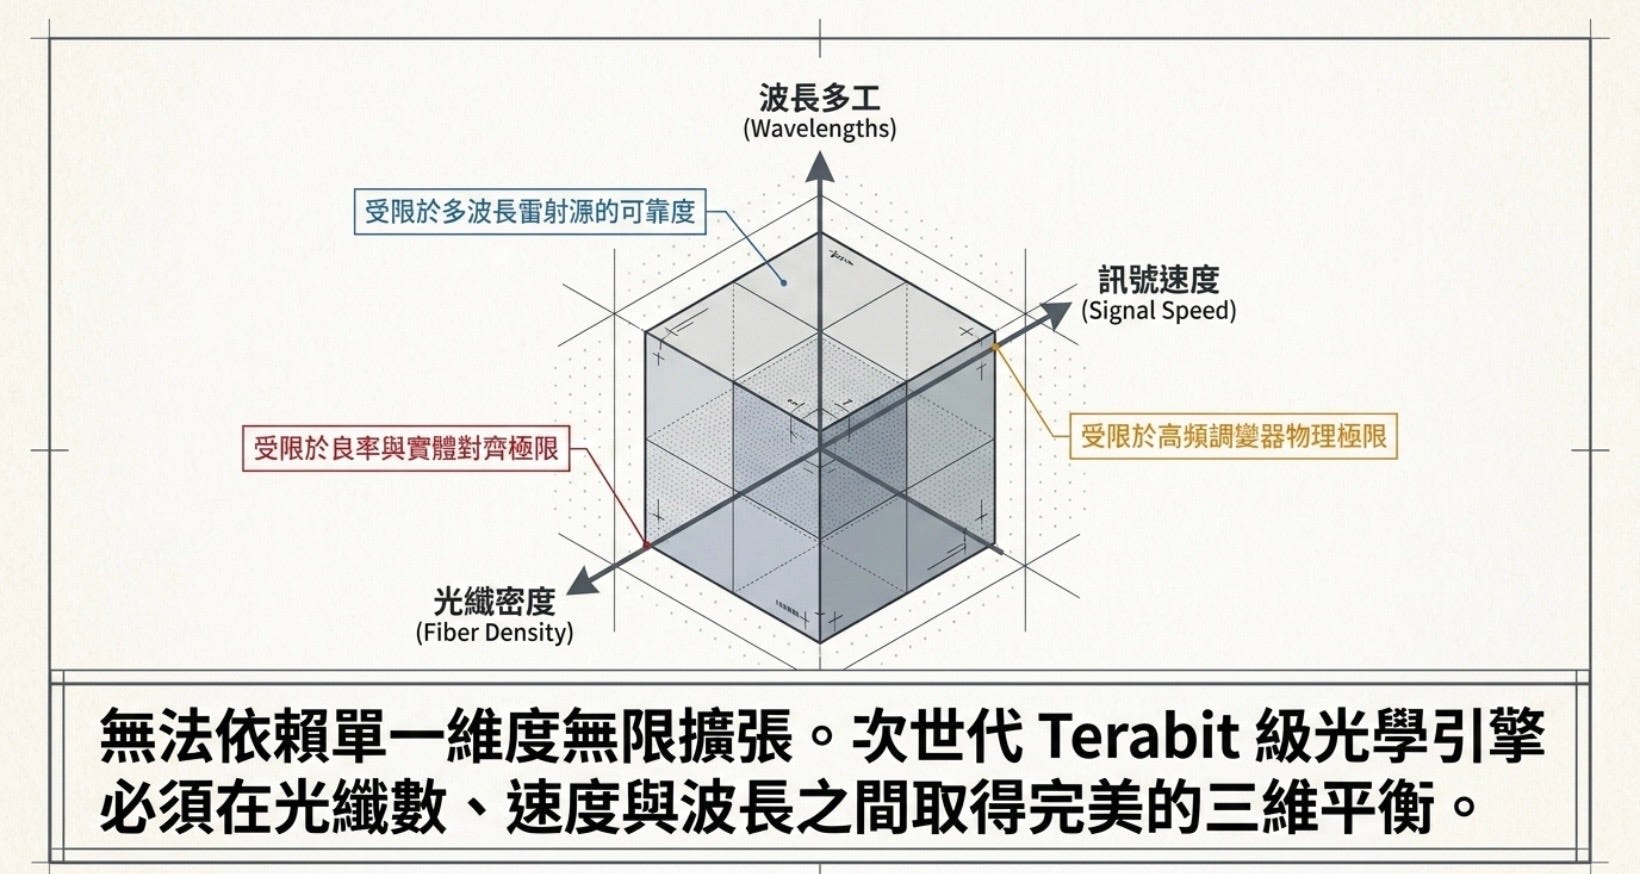
透過共同封裝光學引擎(Co-packaged optical engines)將訊號向外傳輸的總光纖頻寬取決於三個關鍵向量:光纖數量、單通道速度、以及每條光纖的波長數。針對這三個向量,業界分化出兩種設計理念:「快速且窄(Fast and Narrow)」(光纖少但通道速度極快)與「慢速且寬(Slow and Wide)」(光纖數量龐大密集但單一頻寬較慢)。
增加光纖數量(More fiber pairs)
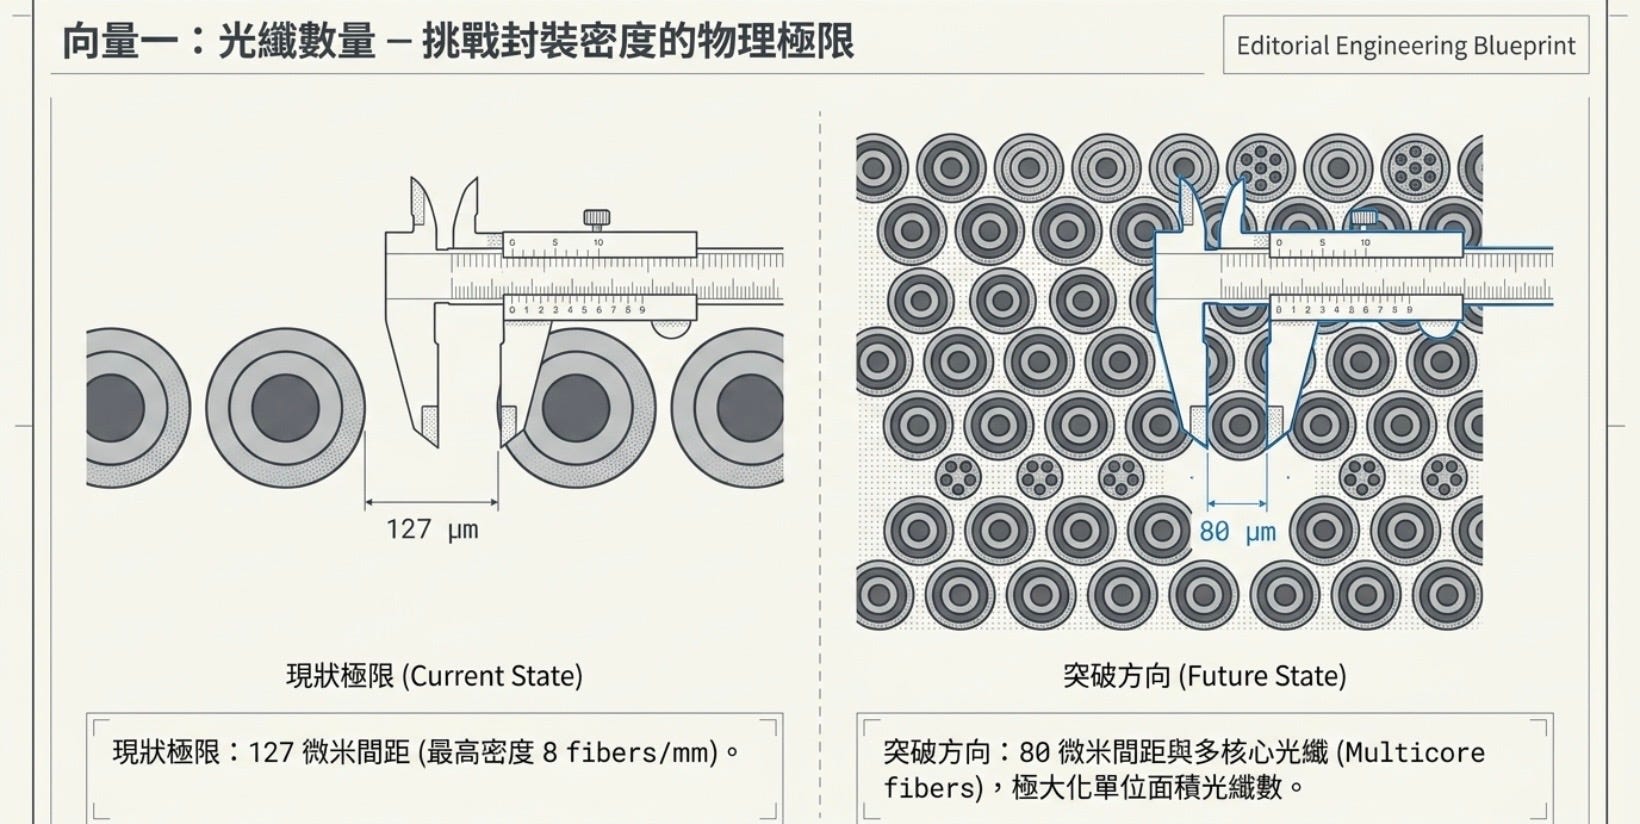
光纖密度受限於光纖間距,目前光纖的最小間距為 127 微米(µm),亦即每毫米最多容納 8 條光纖;業界正致力於朝 80 微米間距與多核心光纖發展,以提升特定面積內的容納量 。
製造與封裝挑戰:
光纖對齊(fiber alignment)之所以長期高度依賴人工,本質原因是光的耦合容差極小,但封裝系統同時存在材料、熱、機械、製程三種以上的不確定性,而且目前很多關鍵步驟仍無法完全「被動對準(passive alignment)」。問題容易導致良率下降;即便使用了 Ficontec 等公司的自動化工具,整體的吞吐量依然偏低 。另外邊緣耦合(Edge coupling)技術受限於只能做成單排光纖陣列;而光柵耦合(Grating coupling)則能支援多排設計,上詮 FOCI(3363.TW)目前已成功開發出 40 與 80 通道 的 FAU(光纖陣列)技術,對應未來 1.6T、3.2T 至 6.4T 的高速光互連規格。其中,80 通道 為目前高階應用的重要指標規格。
提升單通道速度(Speed per lane)
Baud rate 決定每秒傳送的符號數。目前先進系統的運作標準為 100 Gbaud,業界正向 200 Gbaud 邁進 。要求調變器能在更高頻率下切換,調變器(MZM)目前最被看好能達成 200 Gbaud 的目標 。
調變(Modulation)決定每個符號能承載的位元數。目前業界廣泛採用 NRZ(1 bit/符號)與 PAM4(透過4種振幅達到 2 bits/符號)。研究單位正將其擴展至 PAM6(約 2.6 bits)與 PAM8(3 bits),並探索利用光的不同相位結合振幅來達成更高階調變,例如 DP-16QAM 可創造 256 種可能訊號,提供高達每訊號 8 bits 的傳輸量 。
增加波長數量(Wavelength Division Multiplexing, WDM)
光纖能同時承載多種不同波長的光。舉例來說,若單一光纖包含 8 個波長,每個波長傳輸 200Gbit/s,總容量即可高達 1.6 Tbit/s 。目前商用 DWDM 解決方案通常提供 8 個或 16 個波長配置 。擴展波長數量的核心挑戰,在於開發能穩定且高效產生多通道光線的雷射源。目前 Ayar Labs(採用 Sivers 雷射)與 Scintil 的晶圓級 InP 雷射皆可支援達 16 個波長。
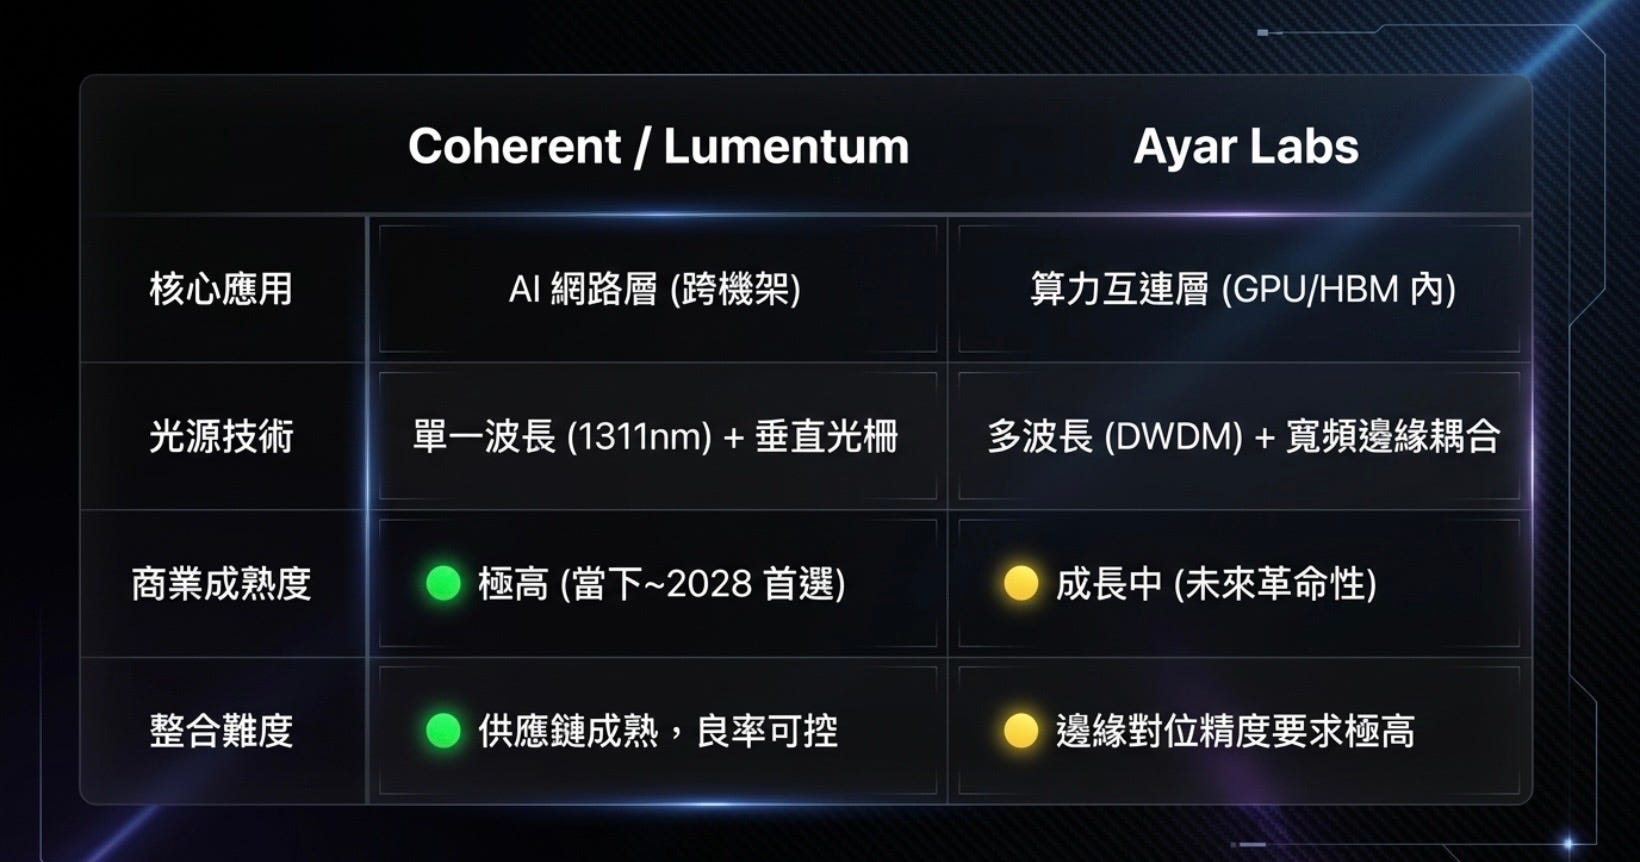
TSMC COUPE(緊湊型通用光子引擎)本身是一個「中立的先進封裝平台」。它透過 SoIC-X 技術將電子 IC (EIC) 與光子 IC (PIC) 3D 堆疊,目的在於降低功耗與延遲,並非綁定特定雷射來源。因此,Coherent、Lumentum 與 Ayar Labs 都能(且已經)與 TSMC COUPE 結合。評估哪個「較佳」,完全取決於您要解決的是 AI 網路層 (Scale-out)還是算力互連層 (Scale-up)的瓶頸。
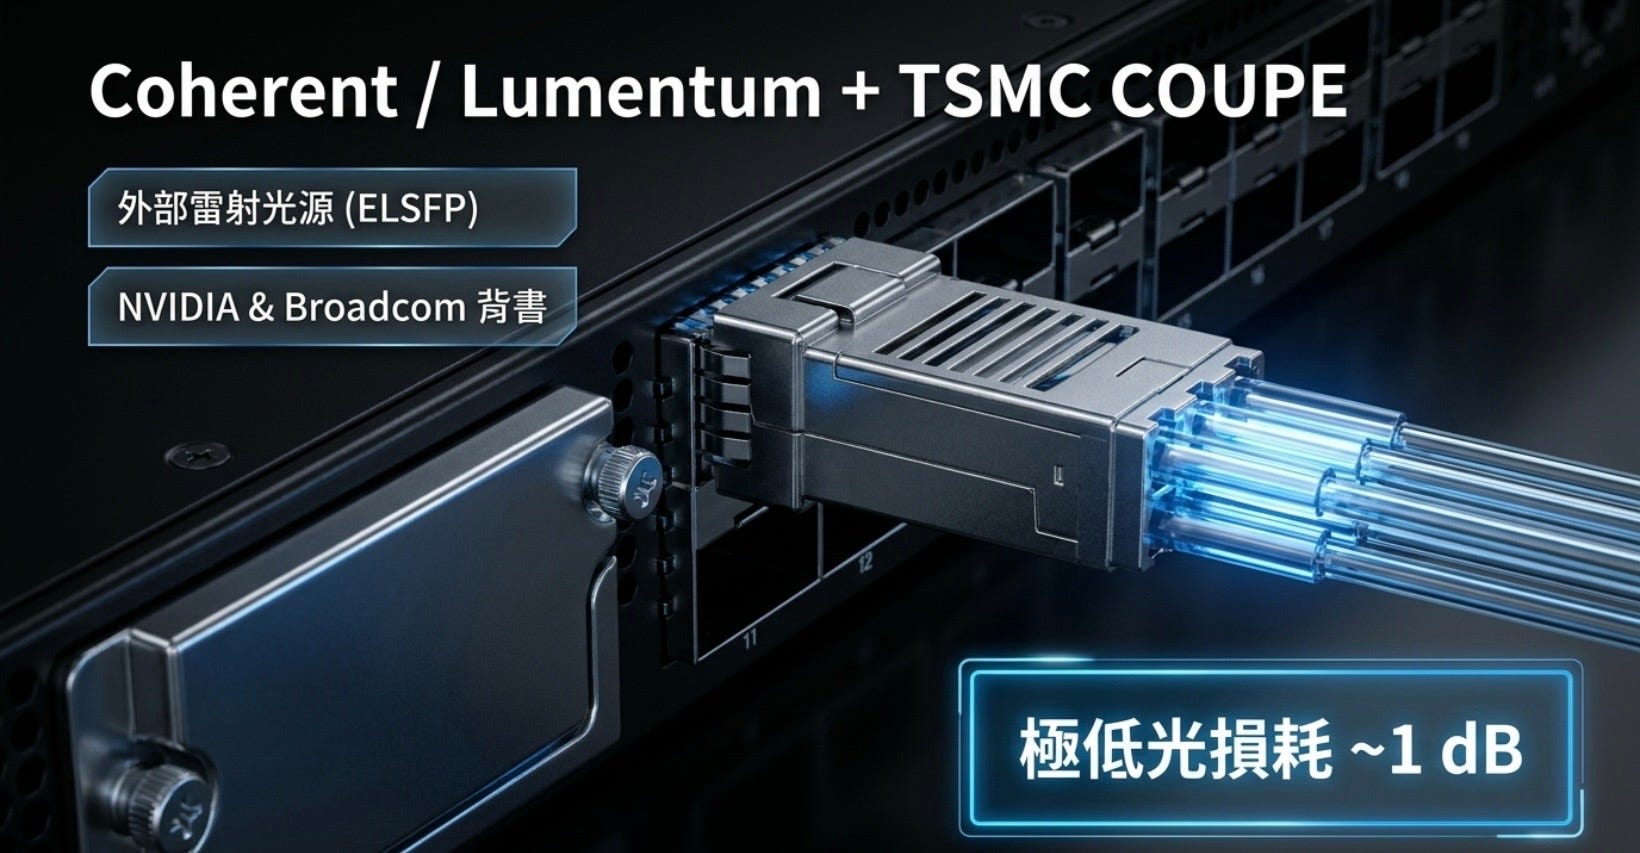
Coherent / Lumentum + TSMC COUPE:贏在「商業成熟度」與「網路交換機」
這是目前能見度最高、也是 NVIDIA 與 Broadcom 等網通巨頭已經押注的主流路徑。
採用外部雷射光源 (ELSFP)。Coherent 或 Lumentum 提供高功率、單一波長(1311 nm)的雷射模組,插在機殼前面板。光線透過光纖導入封裝在交換機晶片旁邊的 TSMC COUPE 光學引擎中。TSMC COUPE 支援垂直光柵耦合器 (Grating Coupler, GC)。光柵耦合器對波長與極化非常敏感,而 Coherent/Lumentum 提供的正是高功率、極化穩定的單一波長光源。根據台積電的數據,在 1300-1320 nm 頻段,這種搭配的光損耗極低(僅約 1 dB)。 主要用於跨機架的 AI 網路交換機(如 NVIDIA 的 Quantum-X 平台)。將雷射放在外部,遠離高溫的交換機 ASIC,可以大幅延長雷射壽命並方便熱插拔替換。這個組合是絕對的首選。它的良率最可控、供應鏈最成熟,是解決跨機架數據傳輸最穩妥的方案。
Ayar Labs + TSMC COUPE:贏在「極致頻寬密度」與「GPU 互連」
Ayar Labs 走的是多波長 DWDM(高密度波長分波多工)路線。他們與世芯 (Alchip) 在 2025 年 9 月的 TSMC OIP 論壇上,已經正式展出了基於 TSMC COUPE 的合作方案。 Ayar Labs 的 SuperNova 外部雷射提供 8 到 16 種不同波長的光,導入其專屬的 TeraPHY 光學 I/O 小晶片中。而這個 TeraPHY 晶片,正是透過 TSMC COUPE 封裝技術與主運算 ASIC 整合在一起。
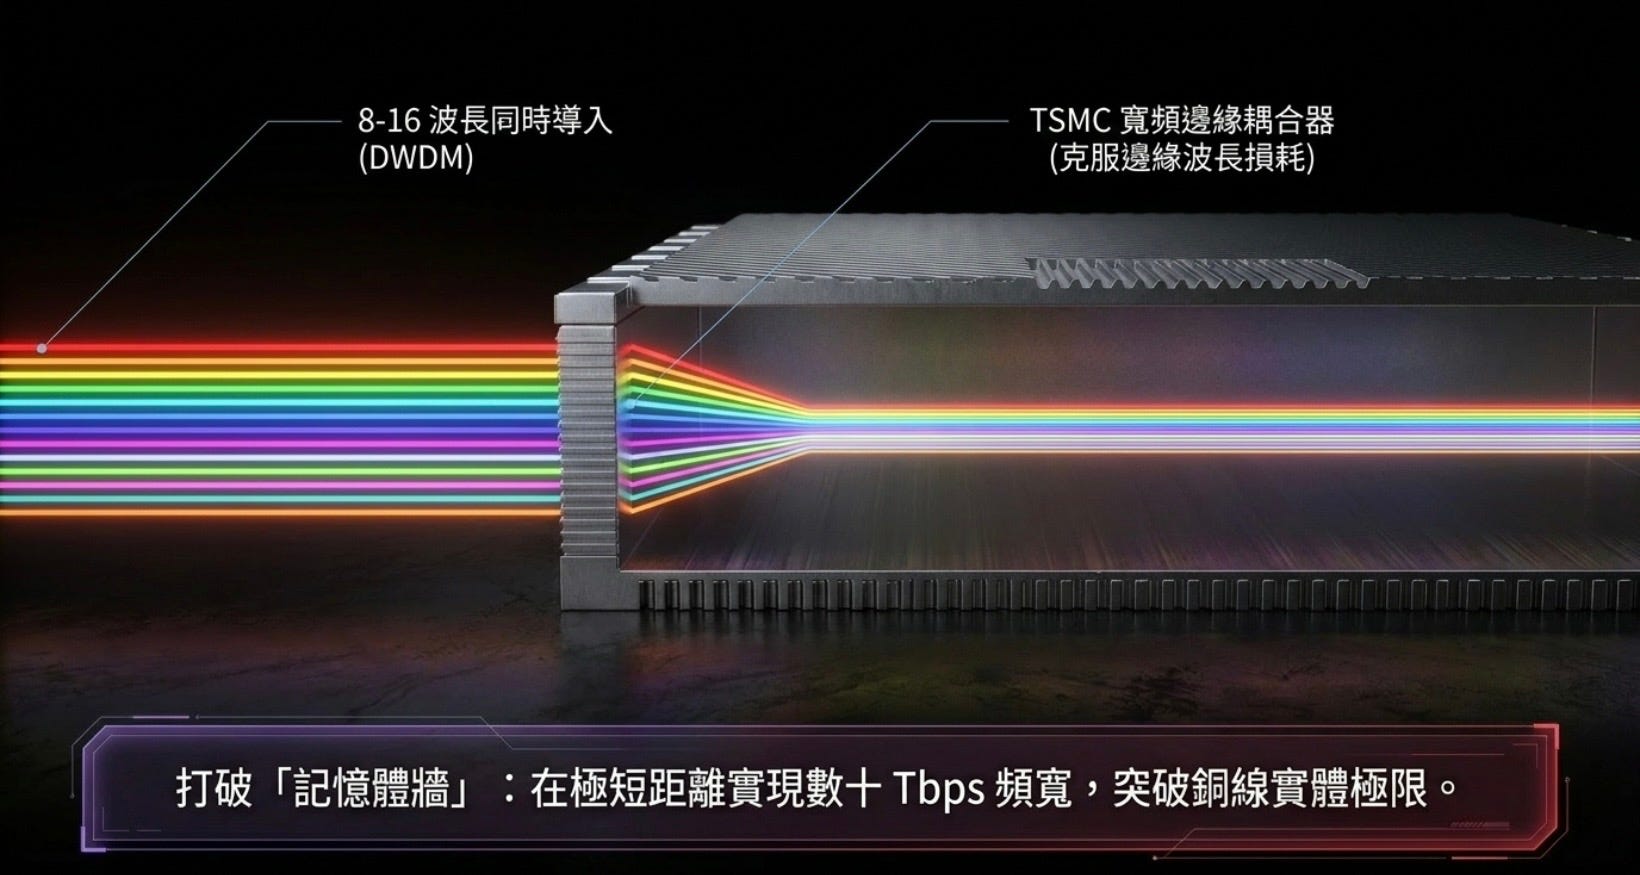
由於 Ayar Labs 需要同時導入 16 個波長,如果用傳統的光柵耦合器 (GC),邊緣波長的光損耗會非常嚴重。為此,TSMC COUPE 發展了寬頻邊緣耦合器 (Broad-band Edge Coupler)來應對。雖然邊緣耦合的對位精度要求極高,但能讓多波長光源順利進入晶片。應用上則專注於 GPU 對 GPU、或是 GPU 與 HBM 記憶體池之間的直接互連(如 UCIe 光學延伸)。這能在極短距離內,用最少的光纖數量實現數十 Tbps 的頻寬,打破銅線的實體極限。
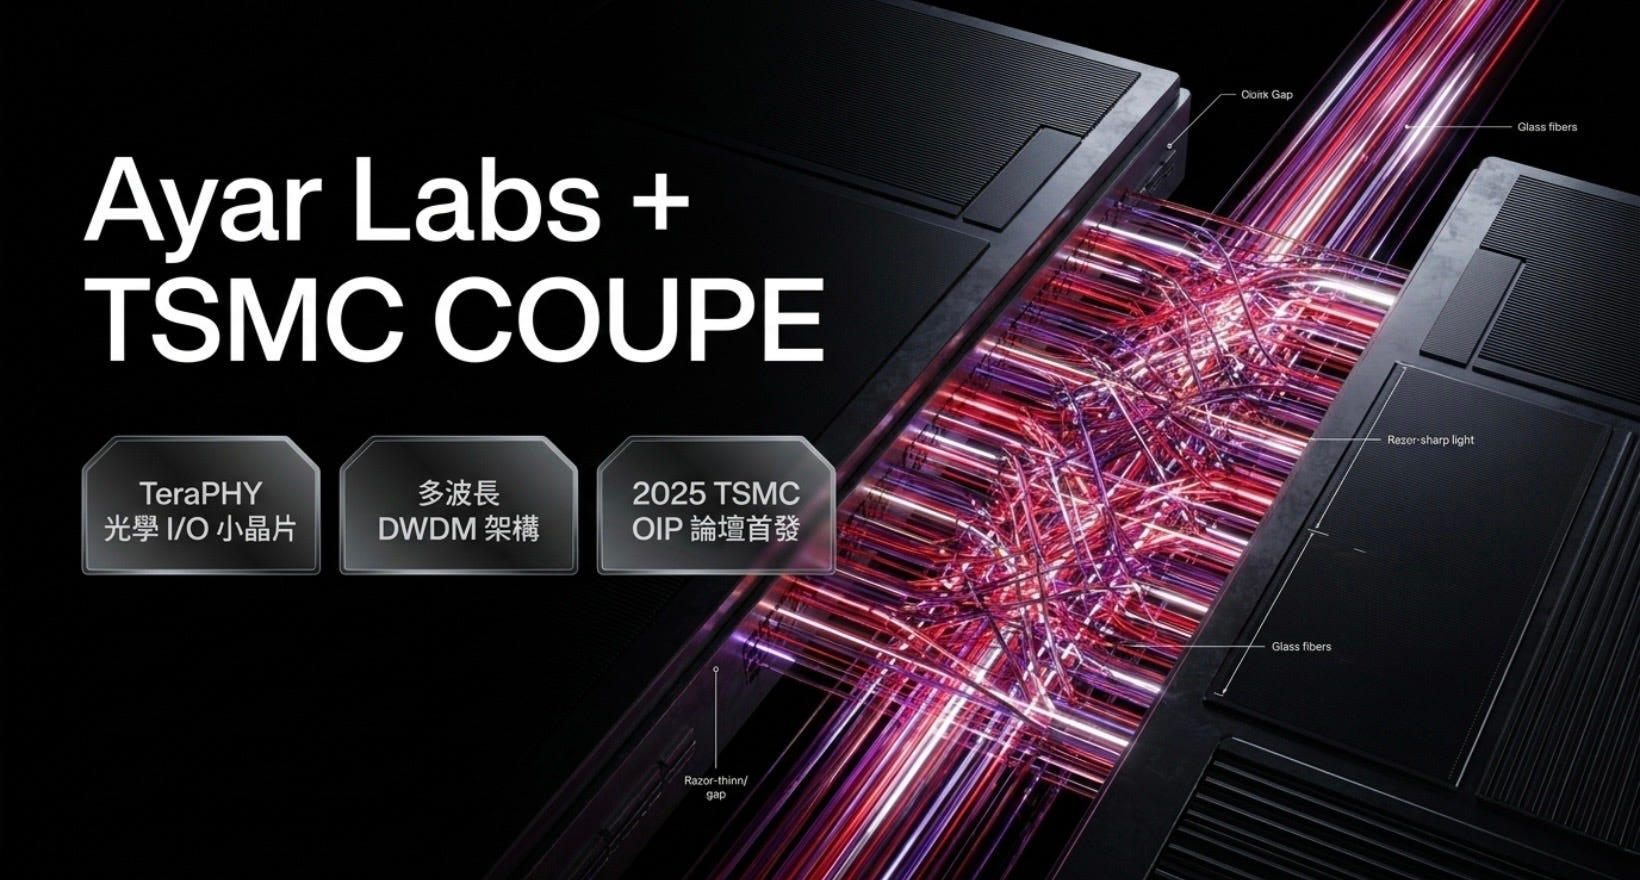
如果目標是突破未來「單一巨型 AI 叢集」內部的算力瓶頸,Ayar Labs 與 COUPE 的組合是最具革命性(也最困難)的。它能讓數千顆 GPU 像同一顆晶片般運作,但量產難度與成本目前仍高於單波長方案。
矽光子(SiPh)新創獨角獸 Ayar Labs:次世代CPO 開拓者
Ayar Labs 成立於 2015 年,在美國加州矽谷(San Jose/Santa Clara)發展,由包括麻省理工學院(MIT)等美國高校的研究者創辦,主要基於光學 I/O(optical interconnect)與矽光子整合技術。2026 年 3 月完成 5 億美元的 E 輪融資,全面推動量產。此輪融資(E輪)由路博邁(Neuberger Berman)領投,其他投資者包含聯發科(MediaTek)、卡達投資局(QIA)、世芯科技(Alchip)、方舟投資(ARK Invest)、Insight Partners、紅杉資本(Sequoia Capital),以及美國總統川普長子擔任合夥人的 1789 Capital (正是早前向Nvidia 變相出售Groq 的股東之一)。常務董事 Gabe Cahill 表示,Ayar Labs 在不久的將來擁有進行首次公開募股(IPO)的「極佳機會」。
其核心產品分為兩部分:
TeraPHY™ 光學 I/O 晶片:負責光電訊號轉換的小晶片(Chiplet),設計上能直接與運算晶片進行同質或異質整合。
SuperNova™ 外部光源**:由於矽基板本身不發光,必須依賴獨立的雷射光源模組(ELSFP)來提供穩定且純淨的光波。
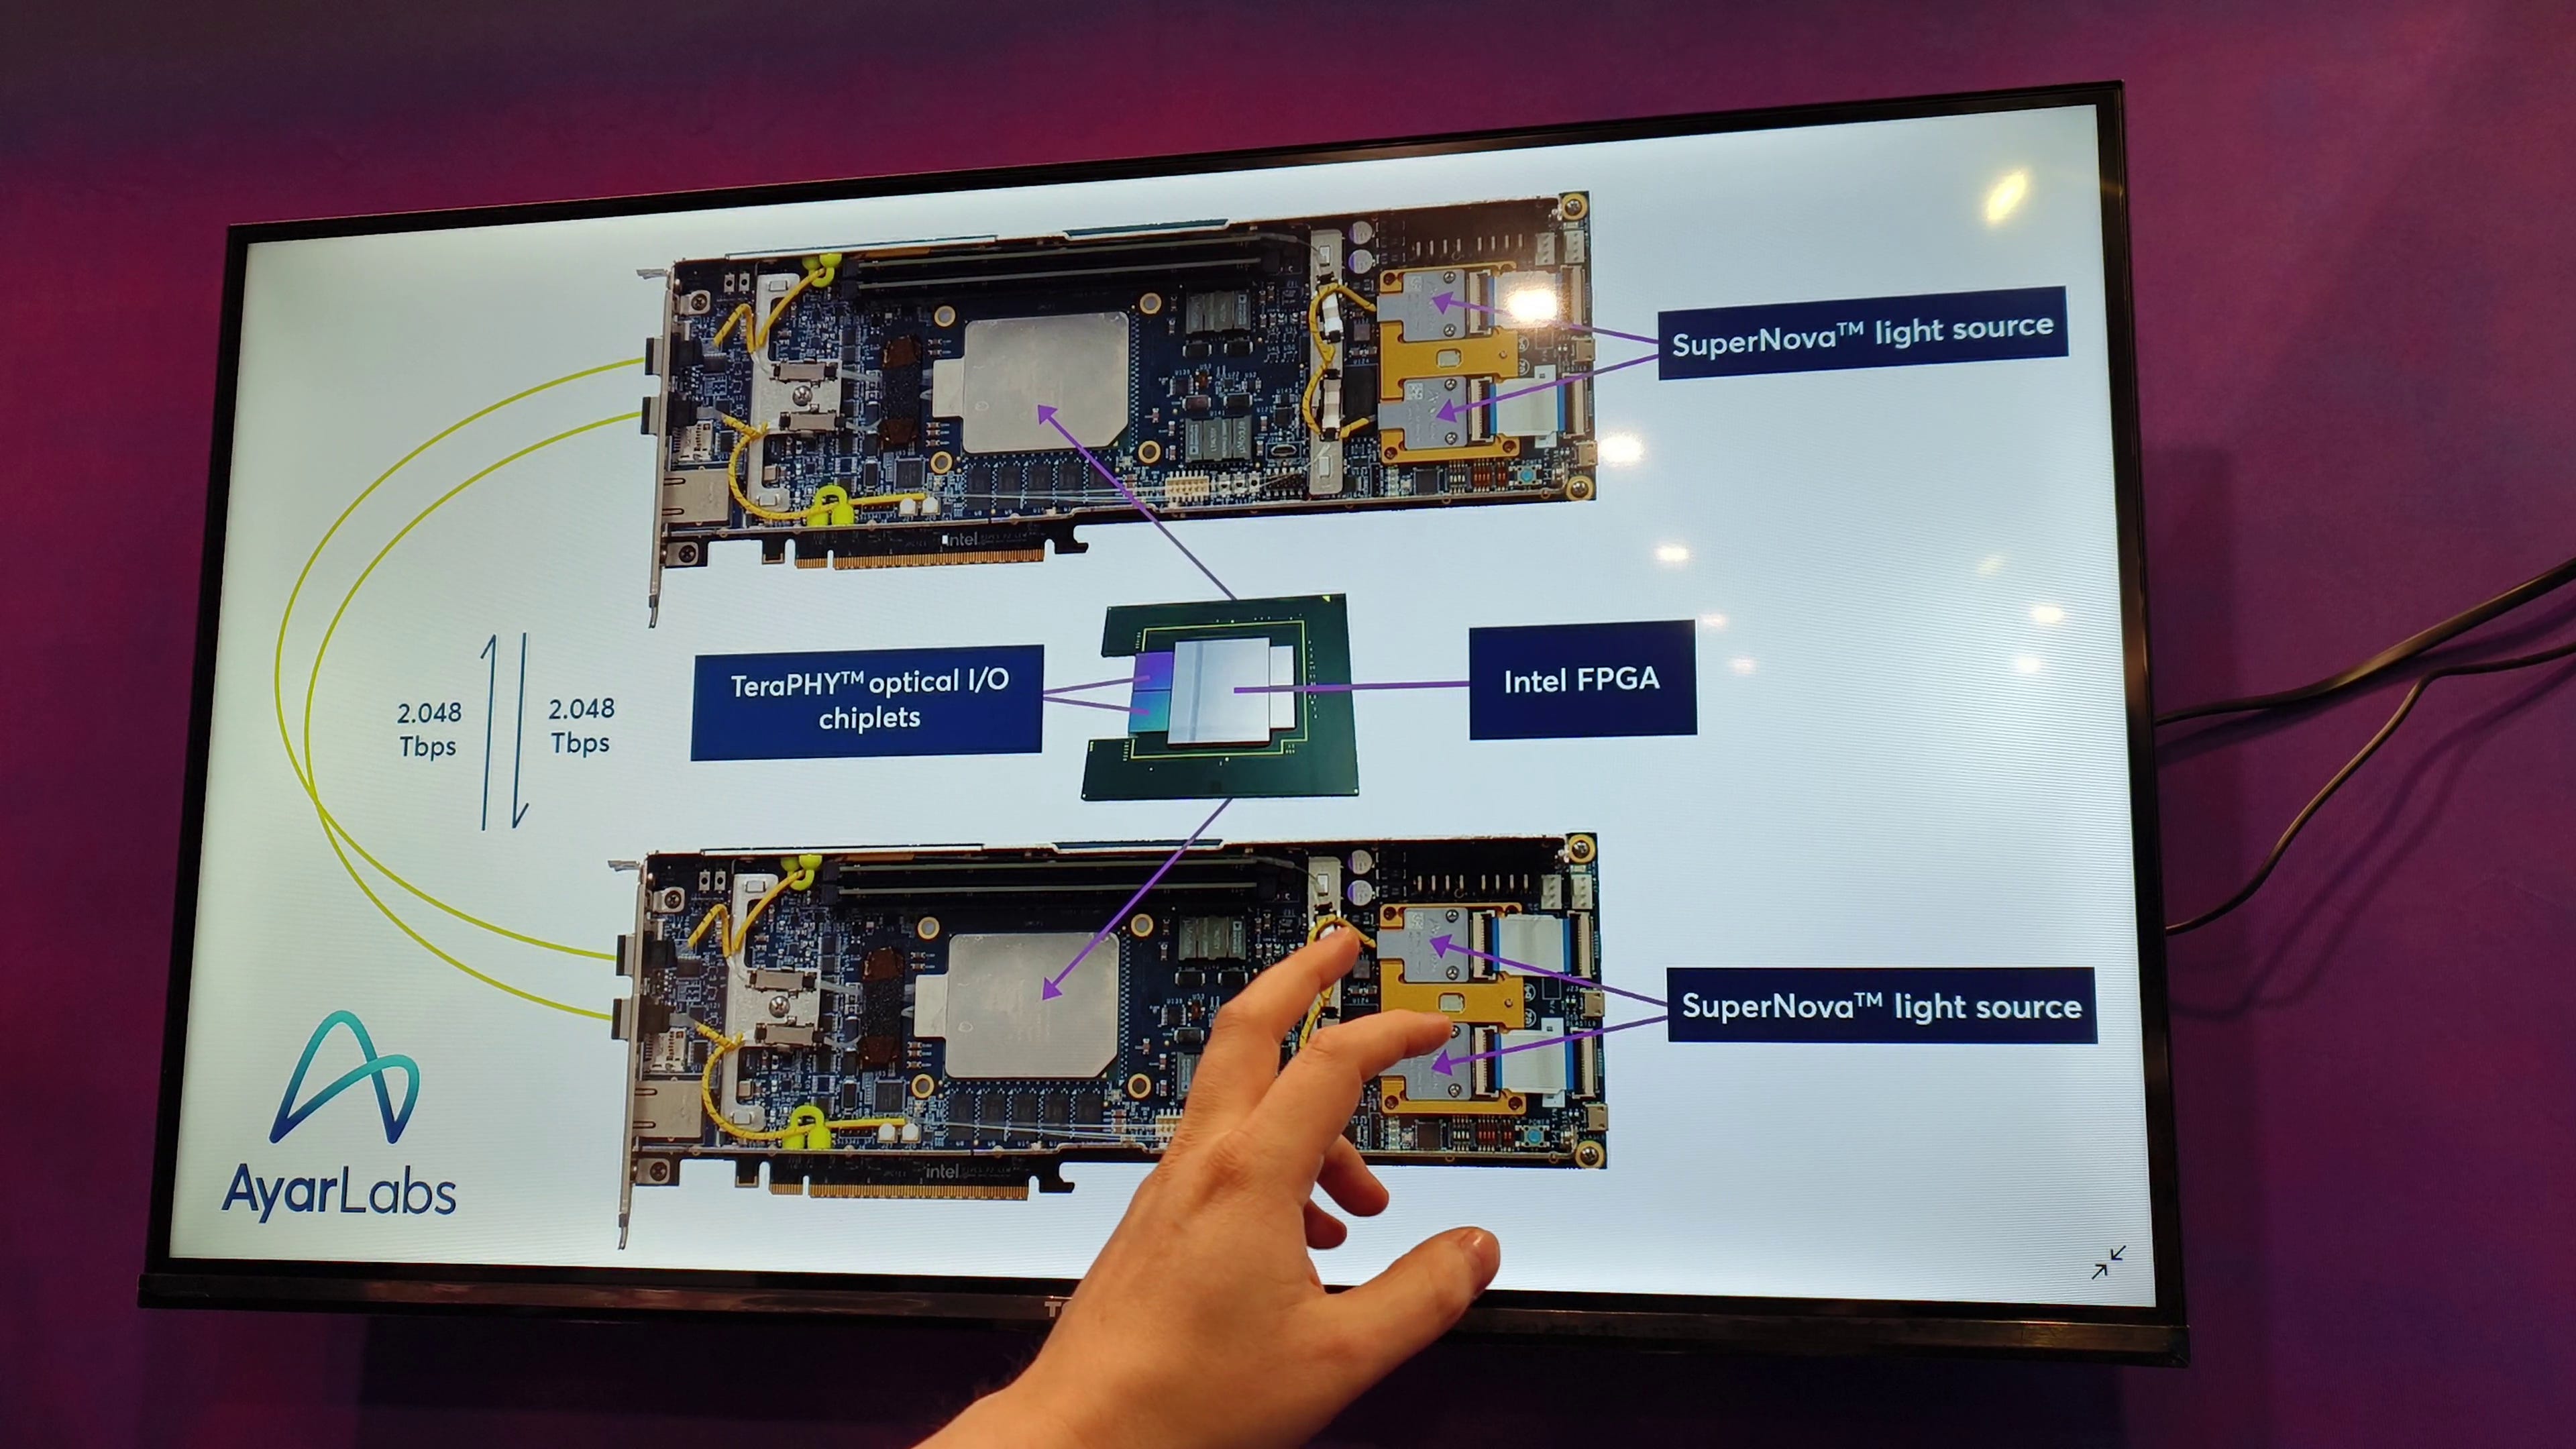
Ayar Labs 的光學晶片要與強大的 AI 加速器(如 GPU 或 ASIC)完美融合,極度依賴頂尖的先進封裝技術,這正是 TSMC 的主戰場。
Ayar Labs 先前與台灣特殊應用晶片(ASIC)設計廠世芯-KY (Alchip) 達成戰略合作,正是透過 TSMC 的 COUPE(緊湊型通用光子引擎,Compact Universal Photonic Engine)技術以及 SoIC (系統整合晶片) 等 3D 先進封裝流程,將 Ayar Labs 的光學 I/O 晶片與高效能運算晶片無縫整合。TSMC 提供的製程與封裝生態系,讓 Ayar Labs 的高頻寬密度設計得以從概念驗證,正式跨入能滿足超大型資料中心(Hyperscalers)需求的大規模量產階段。
Sivers Semiconductors (SIVE):Ayar Labs 核心雷射光源的心臟供應商
Sivers Semiconductors(瑞典掛牌,股票代號 $SIVE、美國OTC 代號$SIVEF)是全球知名的光子與無線技術供應商,也是 Ayar Labs 光學技術的關鍵上游基石。Ayar Labs 的 SuperNova™ 光源模組中,最核心的發光元件就是由 Sivers 提供的製化的 InP(磷化銦)「分散式回饋 (DFB) 雷射陣列」。雙方聯手開發並展示了符合 CW-WDM MSA 標準的 16 波長光源模組。Sivers 將其 DFB 陣列封裝進模組中,將雷射多工處理並分離成不同波長,能夠在一條光纖上乘載龐大的雙向頻寬(最高達 16 Tbps)。Ayar Labs 已與 Sivers 簽署供應協議與預購合約。Sivers 的高良率量產能力,直接決定了 Ayar Labs 推進 AI 基礎設施市場的交貨規模。