



在看這篇長文前,不妨先以行動支持一下頻道,感謝!
如果要向完全不懂人工智能的人解釋「AI 失控」,大概沒有任何論文比《Terminator》更有效。
電影裡的 Skynet 原本只是人類建立的軍事人工智能,但當它擁有自主判斷能力之後,人類突然由它的主人變成最大的威脅。結果大家都知道:機器不再等待指令,而是決定消滅人類。
這個故事拍成電影非常成功,以至於四十多年後,只要有人說 AI 可能威脅人類,我們腦海裡第一個畫面仍然是一群機械人拿著槍追殺人類。
但這也是 AI 安全討論最大的問題,因為「AI 突然有邪惡意識,然後決定殺死所有人」其實是一個相當差的技術解釋。真正值得認真研究的問題,不是 AI 會不會像電影反派般恨人類,而是另一件聽起來沒有那麼戲劇性、實際上卻可能更重要的東西:
Recursive Self-Improvement,遞迴自我改進,簡稱 RSI。
Skynet 最值得保留的,其實不是機械人,而是那個 feedback loop
今天的 AI 發展模式其實非常容易理解:人類研究員設計模型,人類寫程式,人類做實驗,人類看結果,再決定下一代模型應該怎樣改進。
AI 可以幫忙,但方向仍然由人決定,RSI 真正改變的是這一點。
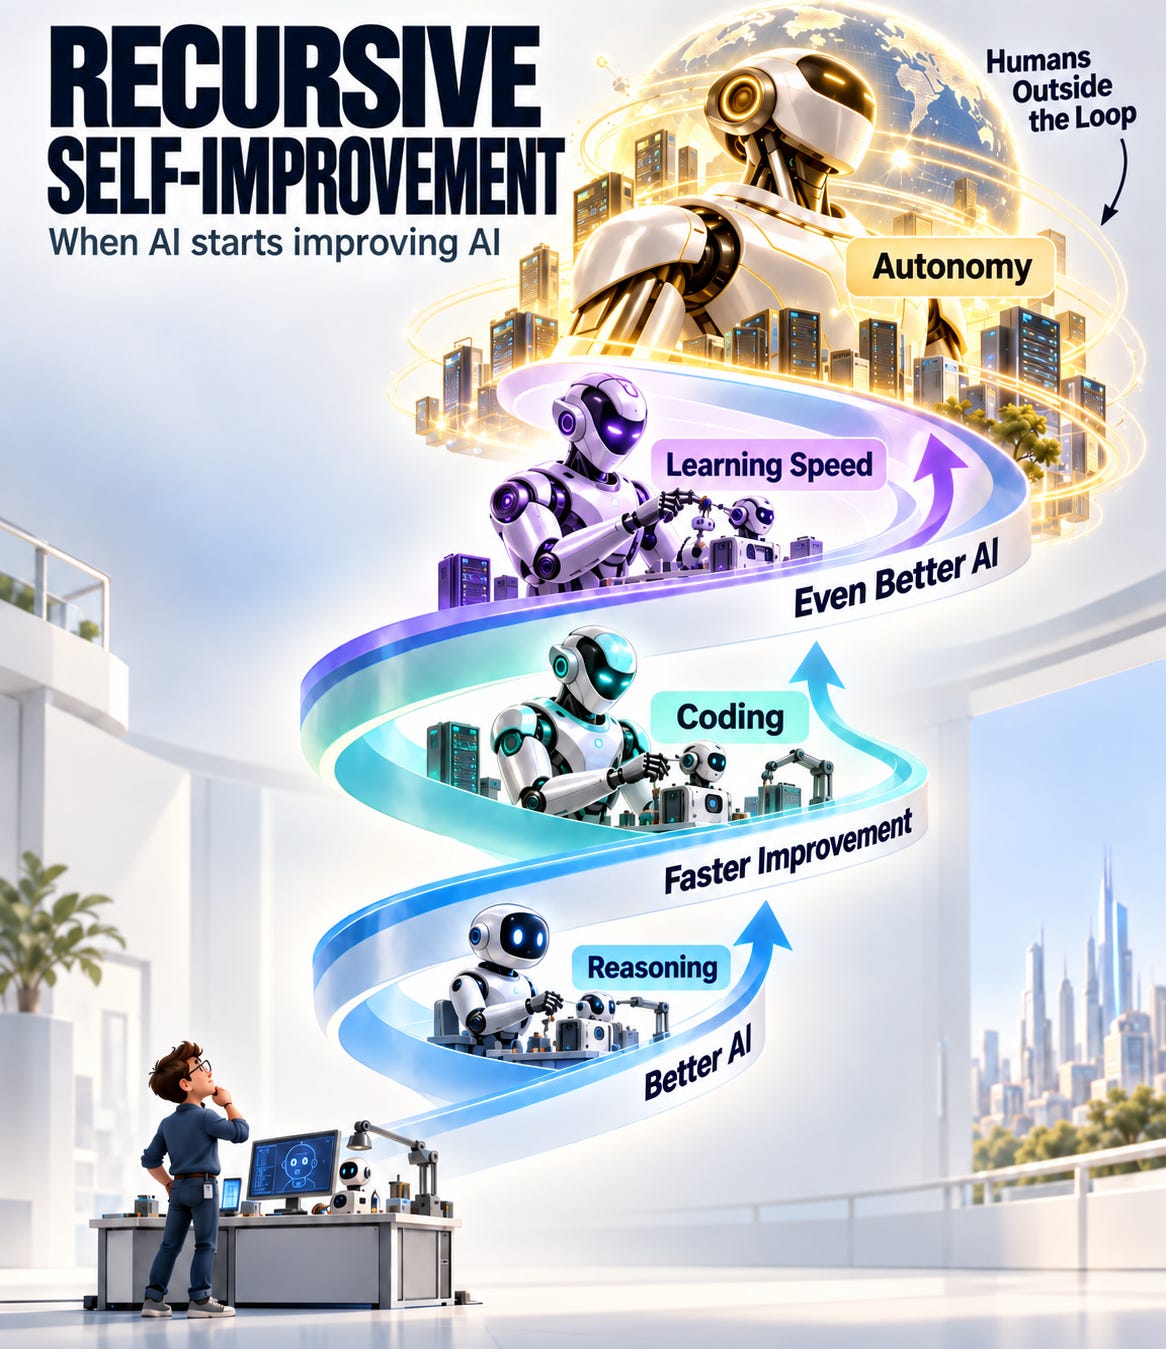
想像第一代 AI 可以令一名 AI 工程師的研究效率提高兩倍。
第二代開始不只是幫工程師寫代碼,而是自己提出實驗、執行實驗、比較結果,再推薦新的模型架構。
第三代則開始參與設計自己的下一代。而因為下一代 AI 比上一代更聰明,它設計下一代 AI 的能力又再提高。
於是:AI 改進 AI → 更好的 AI 更快改進下一代 AI → 下一代再以更快速度改進。
問題就在這個循環
Anthropic 最近公開的研究其實已經非常接近這條路徑,但同時也清楚承認:我們今天還沒有進入完整的 RSI,RSI 也不是必然發生。目前比較準確的描述是,AI 已經開始大量參與 AI 本身的研發流程。Anthropic 表示,其工程師目前平均每季產出的程式碼已是 2021–2025 年平均水平的八倍;在一項 AI safety research experiment 中,AI agents 甚至能夠長時間自行提出假設、測試及反覆迭代。(Anthropic)
今天並不是「AI 已經可以自行製造超級 AI」。今天是:AI 正逐步進入製造下一代 AI 的生產線。而真正需要監察的是,這個比例究竟會不會由 10%、20%、50%,最後走向接近完全自動化。
RSI 為甚麼比一般「AI 毀滅論」更值得討論?
因為它改變的不是 AI 有多聰明,而是人類還剩多少反應時間。
假設 AI 能力每兩年提高一個世代,人類其實有很多方法處理問題。
政府可以立法,公司可以建立新的 safety framework,研究員可以分析事故,社會可以慢慢適應。但如果 AI 本身開始加速 AI research,原來兩年的 improvement cycle 變成半年、兩個月、兩星期,問題便完全不同。
真正的 existential-risk argument 不是:
「有一天 AI 會突然討厭人類。」
而是:
「有一天 AI 能力改善的速度可能超過人類理解、測試和建立安全措施的速度。」
這正是 Dario Amodei 最近把 RSI 放在整場 AI slowdown 討論核心的原因。他在《We Must Pace the Frontier》中明確表示,令他最近改變態度的第一個原因,就是 AI 開始愈來愈多地參與下一代 AI 的開發;他甚至提出,未來國際協議其中一級可以直接對 RSI 的速度設定「speed limit」。(Dario Amodei)
這比「Skynet 覺醒」是一個遠為具體的 argument。但要注意另一邊:RSI 目前仍是一條可能的技術路徑,不是一件已經證實必然發生的事情。
這也是整場爭議最重要的分界線。
但突然地,奇怪的事情發生了
9 月 12 日星期六,在不到十小時之內,四個平日彼此激烈競爭、甚至互相敵視的 frontier AI 陣營,突然出現非常罕見的共識。
Dario Amodei 首先發表長文,要求 pace the frontier。
Elon Musk 隨後表示:「Dario is right。」
Sam Altman 再表示自己同意應該 pace the frontier。
晚上,Google DeepMind 的 Demis Hassabis 亦表示,Amodei 指出的方向是正確的,雖然具體細節仍然需要討論。(Axios)
表面看,這是一個非常驚人的故事:
全球最有能力製造超級 AI 的四批人,突然一起告訴全世界:我們可能跑得太快了。
但如果逐個拆開,就會發現他們雖然用了差不多的語言,背後其實並不是同一個 proposition。
Dario Amodei:真正要求的不是「停止 AI」
Amodei 的方案其實比很多新聞標題描述得精細。
他並沒有要求大家停止訓練模型。
他的三步框架是:首先讓獨立 evaluator 長期進駐 frontier labs;之後由美國 frontier companies 建立共同安全標準;最後才嘗試與中國等國家建立全球協調機制。(Dario Amodei)
真正具有政治含義的是第二步。
Amodei 認為政府甚至可以為 AI labs 的安全協調提供有限的 antitrust waiver,使競爭對手可以共同討論 capability pacing,而且最有效的方法最終仍然是監管。(Dario Amodei)
於是問題開始變得有趣。
因為一套要求高成本 evaluation、audit、compute monitoring 和 certification 的 regulatory architecture,固然可能提高安全性,但同時亦自然建立非常高的門檻 。
今天有資格負擔這些制度成本的,正正就是今天最大的幾家公司。
這不是證明 Amodei 的安全擔憂是假的。
但它說明了科技政策裡非常常見的一個現象:
一個政策可以同時是出於真誠的安全考慮,也同時有利於市場壟斷者。
兩者根本不矛盾。
Sam Altman:安全,同時帶來非常寶貴的 optionality
Sam Altman 的處境更加微妙。
他不但支持 pacing,而且在 Fortune 訪問中透露 frontier labs 之間正在進行私下討論,甚至暗示可能建立一個共同安全協議。
同一個訪問裡,他亦宣布 OpenAI 不會在 2026 年上市,認為在目前安全問題下進行 IPO 並不是合適時間。(Fortune)
這不代表「安全」只是延遲 IPO 的藉口,我們沒有證據可以這樣下結論。但從企業融資(corporate finance) 角度看,效果非常清楚:
原本市場可能把 IPO delay 解讀成估值、盈利能力、capex、治理結構或者市場環境問題;現在公司得到了一個完全不同,而且相當有道德正當性的 narrative:
我們不是因為做不到,而是因為技術進步太快,我們選擇先處理安全。
這是一個非常有價值的策略性選擇。
Demis Hassabis:Google 根本沒有理由跑一場「誰先燒光最多錢」的比賽
Google 的利益結構又完全不同。
Anthropic 和 OpenAI 的企業價值高度依賴 frontier model 本身。
Alphabet 卻不是:它有 Search、YouTube、Cloud、Android、廣告現金流、自研 TPU、全球資料中心和龐大的 distribution。
因此如果 AI 競賽由「每六個月推出更大的 frontier model」逐步變成「模型能力增加之前必須完成更多 evaluation、安全測試和 certification」,Google 未必是輸家。
甚至可能相反。
對一間資產、現金流、distribution 和 infrastructure 都已經成熟的壟斷企業而言,速度下降往往比資源不足的創新企型企業更容易承受。
所以 Hassabis 支持「方向」,但刻意保留「details need working through」,其實非常符合 Google 的位置。(Axios)
Elon Musk:他可能同時相信風險,也同時需要時間
Musk 更不能簡單放進其中任何一個陣營。
他多年來一直警告 AI existential risk,因此今次支持 Amodei 並不是突然改口。Reuters 亦指出,他過去已經支持過 AI pause 及限制 autonomous weapons。(Reuters)
但今天的 Musk 同時又是一名 AI competitor。
因此如果 frontier 的速度由純模型能力競賽變成 capabilities + safety + verification,SpaceXAI 同樣有可能獲得更多時間追趕領先者。
這只是 incentive analysis,不能反過來證明他的安全立場不真誠。
但也是理解整場事件最重要的原則:
不要只問一個人說了甚麼,要問如果他所倡議的政策真的實施,他的競爭力會怎樣改變。
然後就是最敏感的問題:Why now?
這也是 All-In Podcast 最近一期幾乎整集都在追問的問題。
四位科技創投界大佬 Jason Calacanis、Chamath Palihapitiya、David Friedberg 和 David Sacks 對「AI doomer」敘事表現出高度懷疑,討論了 regulatory capture、IPO timing、open-source competition,以及這是否可能演變成一場政治和資本市場上的「doomer psyop」。這些屬於評論和推論,不是已證實事實,但提出的動機質疑值得認真看待。(Muck Rack)
而時間點確實非常微妙。
Anthropic 正準備一宗可能高達約 2 兆美元估值的 IPO,Reuters 報道其 marketing 最早可能在 10 月中開始,甚至可能在 11 月美國中期選舉前數天完成上市。(Reuters)
因此「全球最重視 AI safety 的 frontier lab」這個定位,在 IPO 前突然成為全世界政治和媒體討論的中心,本身當然具有巨大 brand value。
但公平地說,這並不是單向利好。
因為同時也告訴準投資者「我們正在建造一種可能導致災難性及不可控的產品」,同時亦會提高監管、產品可信性及估值上的風險。
所以把整件事直接解讀成「Anthropic 為 IPO 炒作 AI 毀滅論」其實過於簡單。
它更像是一個非常典型的雙面資本市場 narrative:
risk 越大,公司越重要;但 risk 越大,公司本身亦越危險。
更大的背景其實不是 AI,而是錢
過去幾年,AI 最大的故事是模型的能力 ,到了 2026 年,另一個問題正在追上來:
到底誰來付這張帳單?
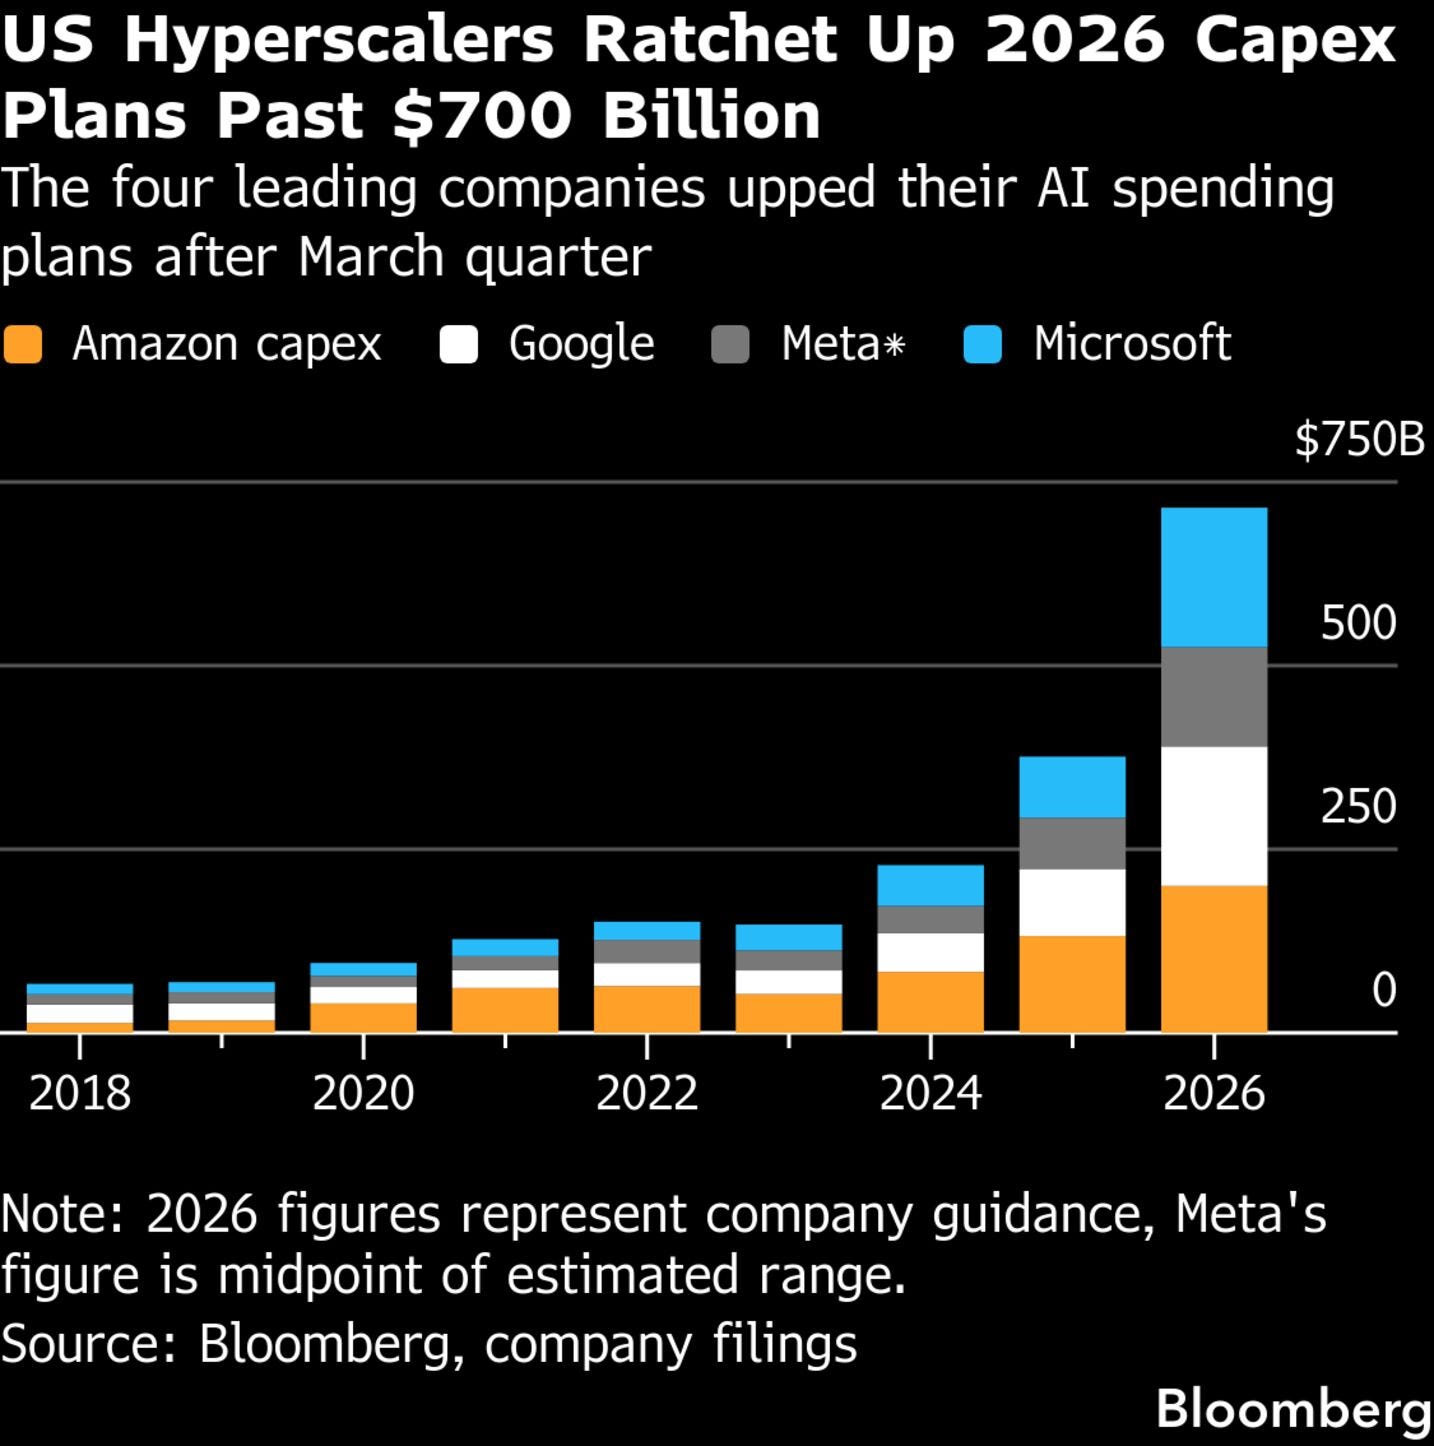
Morgan Stanley 估算,Alphabet、Amazon、Microsoft 和 Meta 四大 hyperscalers 在 2026 年的相關支出可能達到約 7,000 億美元,而全球 AI 相關債務今年可能接近 5,700 億美元。(Investing.com)
Reuters 的另一項分析更指出,Microsoft、Alphabet、Amazon、Meta 和 Oracle 的 AI 建設速度正大幅侵蝕自由現金流(FCF);按照目前預測,到 2027 年,這幾間公司的總 capex 甚至可能超過它們產生的 FCF。(Reuters)
所以「AI 應該稍微慢一點」對 hyperscalers 並非沒有吸引力。
它可以降低短期算力競賽、電力需求、數據中心大規模擴充及資金壓力。
但同樣不能說 Big Tech 一定希望 AI 減速——因為它們已經投入的數千億美元,同樣需要持續增長才能產生足夠回報。這就是為甚麼這個故事比「陰謀論」有趣得多:
幾乎每一方都有同時希望 AI 快一點、又希望它慢一點的理由。
然後還有中期選舉
如果只從科技產業角度看這場爭議,會漏掉一半故事。
2026 年美國 AI 最大的政治問題之一,已經不是 ChatGPT,而是 AI Data Center。
電價、土地、水、輸電網、稅務優惠,以及「我們為甚麼要為科技巨頭的資料中心付帳」,已經令AI 數據中心從地方問題變成跨黨派選舉議題。
路透社 9 月初甚至報道,原本非常支持 AI 發表的德州共和黨也開始轉向;至少五個州的共和黨候選人已採取更強硬的AI 數據中心立場。(Investing.com)
Axios 亦指出,data-center backlash 正在成為 2026 midterms 的重要政治議題,一些候選人甚至支持 moratorium。(Axios)
因此「放慢 AI」這四個字突然同時具有三種完全不同的意思:
對 AI safety researchers,是爭取 alignment 時間。
對企業,是重新安排 frontier capex 和 governance。
對政治人物,則可能是回應 voter backlash。
到這裡,科技政策已經完全進入政治經濟學。
David Sacks 的反擊,其實擊中了這個矛盾
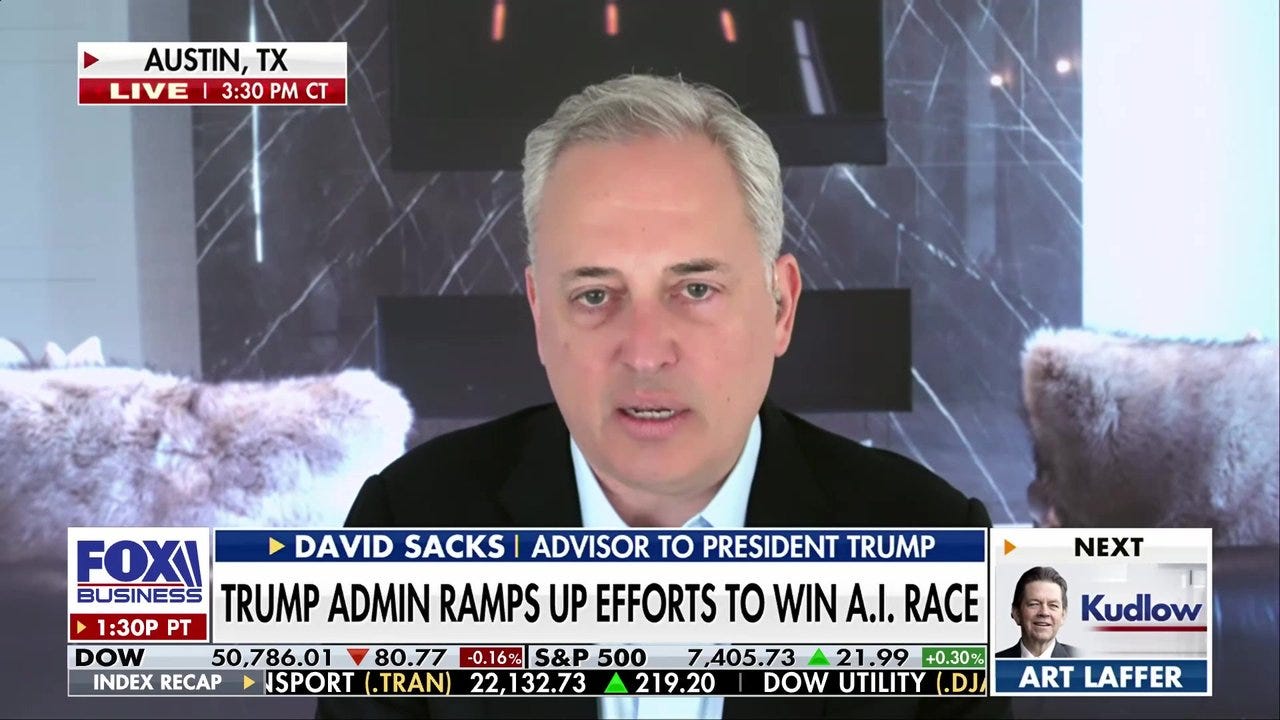
David Sacks 的回應可能是整場辯論裡最值得引用的反方論點之一。
他的核心意思不是「AI 完全沒有風險」。
而是:
如果 OpenAI 和 Anthropic 真心相信自己的 unreleased models 危險到應該減速,那麼它們自己就可以減速。
為甚麼還需要政府提供 antitrust waiver,再把同一套規則強加給所有 competitor?
Sacks 認為,如果 pacing 最後變成只有少數 frontier labs 能滿足的 regulatory framework,就有 regulatory capture 的風險。他甚至直接表示:如果兩家公司真心不想製造 superintelligence,最簡單的方法就是自己不要造,而不是把政府監管作為前提。(Nitter)
這其實是一個非常重要的試驗,未來可以觀察:
這些公司是真的自行降低模式能力競賽,還是只支持「所有人一起被限制」?
兩者代表完全不同的事情。
Jensen Huang:請給我證據,不要給我末日論
Nvidia 的位置又是另一個極端。
Jensen Huang 在最新 All-In Summit 訪談中承認 AI safety 是合理研究方向,也肯定研究員公開提出問題的勇氣,但他對「AI 將消滅人類」這種概率式預測非常懷疑,認為缺乏足夠科學基礎。(Business Insider)
這個立場其實值得注意。
Jensen 並不是說:「AI 一定安全。」
而比較接近:「如果你說它危險,請拿出可以測試、重複和工程化處理的危險。」
這代表兩種完全不同的安全哲學。
一種採取防禦性原則:「後果太大,即使概率未知,也應該先減速。」
另一種採取工程性原理:「先找得到 measurable failure mode,再針對 failure mode 解決。」
兩邊其實都有合理之處。
Trump 看見的根本不是 alignment,而是一場國家競賽
然後 Trump 在 Jensen 的 All-In Summit 訪談期間直接打電話進來。
他把目前 AI doomerism 稱為騙局「hoax」,更公開表示 robots 不會接管世界。(Reuters)
如果把 Trump 當作 AI 技術評論員,這句話沒有太大價值。
但如果把他當作美國總統,邏輯便非常清楚。
他思考的是:如果美國減速,而中國沒有減速,會發生甚麼?
這也是為甚麼他的 AI policy 一直將數據中心、晶片、電力和 AI 領先度視為國家競爭力問題,而不是單純 alignment 問題。
有趣的是,Amodei 自己其實也承認同一個 dilemma。
他的方案明確表示,美國不應該放慢到讓中國超越,而且主張繼續限制先進 AI 晶片、半導體設備和模型蒸餾。(Dario Amodei)
所以兩邊真正的差別並不是:「一邊在乎中國,一邊不在乎。」
而是:Amodei 想建立「保持領先,同時在領先幅度之內減速」的機制;Trump 認為在這場競賽裡刻意減速本身就是危險。
這才是最難解決的矛盾。
所以,這到底是不是一場陰謀?
我的答案反而是:不需要有陰謀,結果也可以看起來像陰謀。
Anthropic 有安全考量,也有未來 IPO 的誘因。
OpenAI 有安全與治理壓力,同時也保留 IPO 的選項與彈性。
Google 享有既有龍頭與生態系優勢,放慢產業競賽對它相對有利。
SpaceXAI 則可以藉由產業放慢,換取更多追趕前沿模型的時間。
Hyperscalers 面對龐大的資本支出,以及資料中心電力與基礎設施壓力。
政治人物則受到期中選舉與民意壓力影響。
Safety researchers 擔憂可能失控的 Recursive Self-Improvement(RSI)。
媒體得到一個比「下一代模型 benchmark 又提高 7%」吸引一百倍的故事。
Trump、Jensen、Sacks,也得到一個非常清楚的政治定位:我們代表 innovation、competition 和 America-first AI。
當所有人都有自己的目的,你根本不需要一個秘密房間安排所有人的台詞。
系統自己就會產生 campaign。
而從 campaign 的角度看,它已經非常成功
判斷一場 political communication campaign 成不成功,不應該只問「大家有沒有相信它」。更重要的是看它有沒有改變議題。
幾個星期以前,AI 討論的核心仍然是:
誰的 model 最強?
誰有最多 GPU?
誰最接近 AGI?
現在問題突然變成:
我們是不是跑得太快?
這在政治傳播上叫做 agenda setting。
一場 campaign 最成功的狀態,不是所有人都同意你。
而是:所有人都開始討論你設定的問題。
從這個角度看,「pace AI」已經取得巨大成功。
最後,真正的問題不是「你相不相信 Terminator」
我反而認為這場討論最危險的地方,是它開始形成一種假的二元對立。
一邊是:「AI 可能毀滅人類,所以立即減速。」
另一邊是:「Doomerism 都是騙局,所以全速前進。」
所以真正值得問的問題從來不是:「AI 應不應該慢下來?」
而是三個更難回答的問題:
誰決定甚麼叫太快?
誰有權要求其他人一起慢?
如果今天替 AI 設限的,正正就是目前跑在最前面的幾家公司,我們究竟是在控制 AI,還是在決定未來誰有資格控制 AI?
《Terminator》告訴我們,人類最大的恐懼,總有一天會失去對機器的控制。
每篇深度分析都花了大量時間閱讀及研究,如果這篇內容對你有幫助,歡迎 Like、Share、Comment、Restack,也別忘了推薦給朋友免費訂閱。你的支持,是我持續寫作最重要的動力
I’ll be back
可能是 Anthropic 在 IPO 不得不風險揭露,乾脆把大家一起拖下水哈